NVIDIA Tesla P100 DGXS

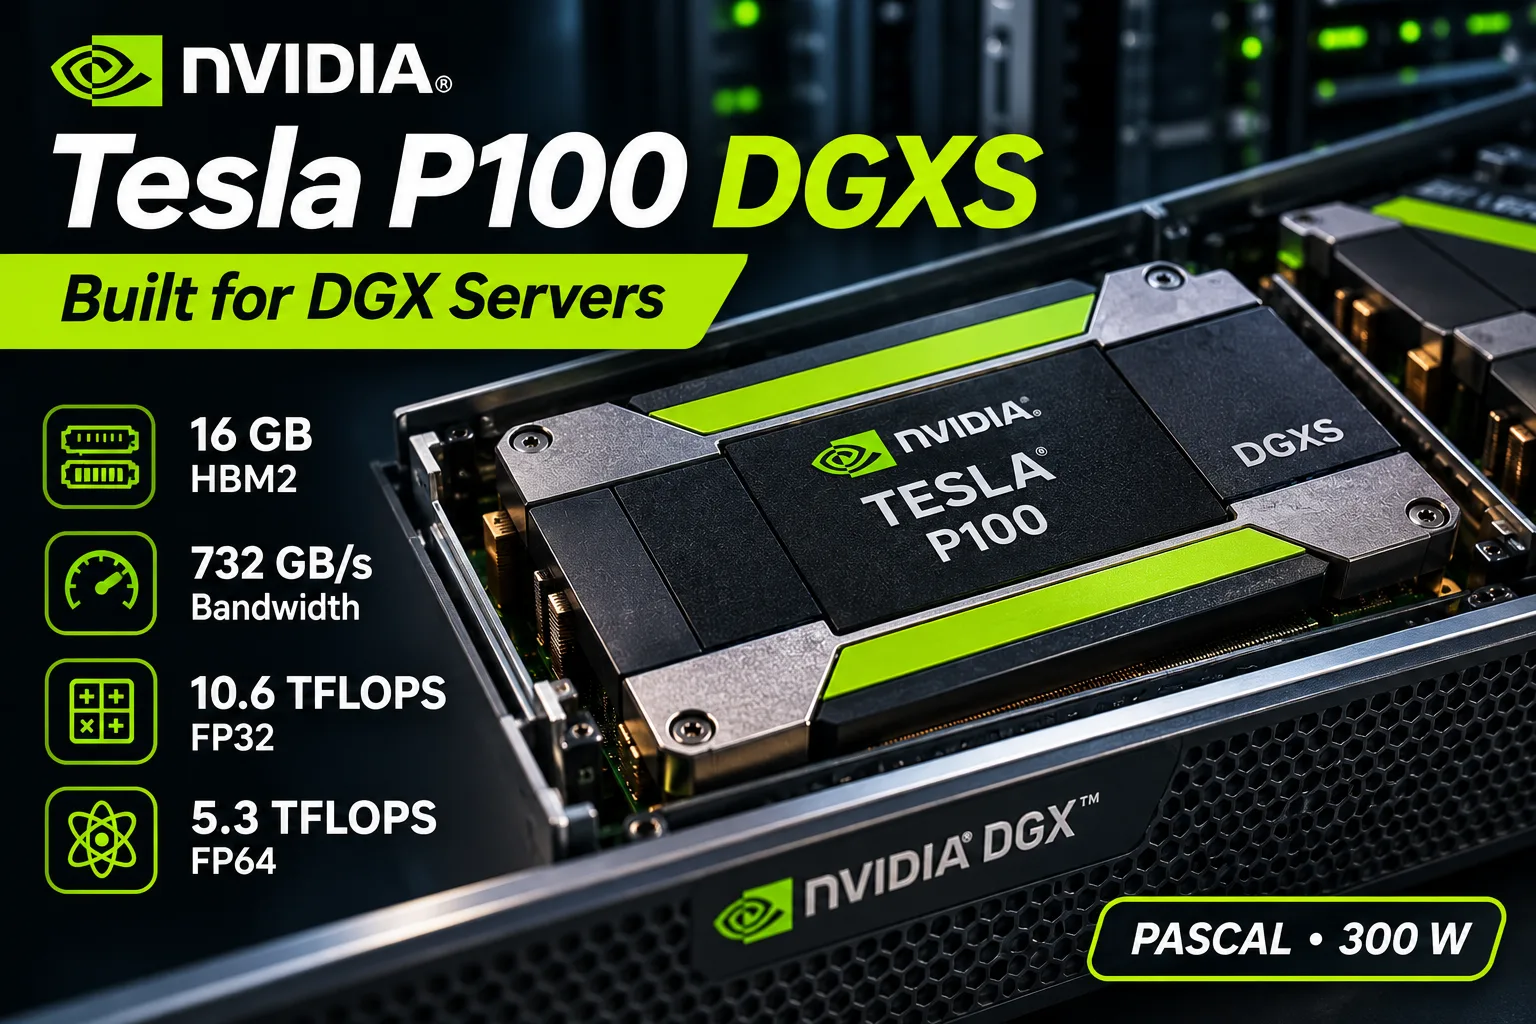
Tesla P100 DGXS: der Beschleuniger, der in Datenbanken, aber nicht auf dem Markt existiert
Die NVIDIA Tesla P100 DGXS taucht in Grafikkartenkatalogen als eigenständiges Modell mit 16 GB HBM2, Taktraten von 1328-1480 MHz und einer Leistungsaufnahme von 300 W auf. Ein offizielles Dokument mit diesen technischen Daten, unabhängige Tests oder bestätigte Verkäufe dieser Version ließen sich jedoch nicht finden. Gleichzeitig ist die Bezeichnung P100-DGXS in NVIDIA-Treibern vorhanden, und in der Diagnosesoftware des Unternehmens wurden zusätzliche GP100-Konfigurationen entdeckt, die mit der DGX Station in Verbindung stehen.
Damit ist die P100 DGXS ein ungewöhnlicher Fall: Die Existenz der entsprechenden Kennung ist bestätigt, die Geschichte der eigentlichen Platine bleibt jedoch unklar.
Wie sich die P100 DGXS von anderen Tesla-P100-Modellen unterscheidet
Allen Tesla-P100-Modellen liegt der 16-nm-Prozessor GP100 mit Pascal-Architektur und 3584 CUDA-Kernen zugrunde. Die Serienversionen unterscheiden sich beim HBM2-Speicher, bei den Taktraten, der Leistungsaufnahme und der Anbindung.
| Modell | Speicher | Speicherbandbreite | Taktraten | Leistung |
|---|---|---|---|---|
| Tesla P100 PCIe 12 GB | 12 GB | 549 GB/s | 1189-1328 MHz | 250 W |
| Tesla P100 PCIe 16 GB | 16 GB | 732 GB/s | 1189-1328 MHz | 250 W |
| Tesla P100 SXM2 16 GB | 16 GB | 732 GB/s | 1328-1480 MHz | 300 W |
| Tesla P100 DGXS | 16 GB laut Bezeichnung | Nicht bestätigt | 1328-1480 MHz (laut Datenbanken) | 300 W (laut Datenbanken) |
Die in den Katalogen genannten Parameter der DGXS entsprechen praktisch den technischen Daten der P100 SXM2. Möglicherweise wurden sie analog übernommen, doch offizielle NVIDIA-Spezifikationen für diese Version ließen sich nicht finden.
Nicht einmal die Übereinstimmung der DGXS-Taktraten mit denen der SXM2 ist bislang bestätigt. Deshalb lassen sich die in den Katalogen veröffentlichten Werte nicht für einen präzisen Leistungsvergleich verwenden.
Spuren der P100 DGXS in NVIDIA-Dokumenten
Der überzeugendste Hinweis auf die Existenz dieser Konfiguration ist die Kennung PCI\VEN_10DE&DEV_15FC. In der NVIDIA-Treiberdatenbank für Windows vom Juni 2017 wird sie als Tesla P100-DGXS-16GB aufgeführt.
Weitere Informationen finden sich im offiziellen NVIDIA-DCGM-Repository, das Diagnoseeinstellungen für Serverbeschleuniger enthält.
Darin finden sich zwei für uns relevante Einträge:
- 15FA - DGX Station. GP100-Konfiguration mit einer Ziel-Leistungsaufnahme von 249 W für den Diagnosetest.
- 15FC - GP100 SKU 201. Separate Konfiguration mit einer Ziel-Leistungsaufnahme von 299 W für den Test.
Die zweite Kennung stimmt mit der Tesla P100-DGXS-16GB aus den Treiberdatenbanken überein. Die Leistungswerte im DCGM legen jedoch die Belastung für Diagnosetests fest und entsprechen nicht der TDP-Angabe.
NVIDIA hat somit tatsächlich mehrere GP100-Konfigurationen vorgesehen, darunter eine Variante mit der Bezeichnung DGX Station. Die Einträge in der Software lassen jedoch nicht erkennen, wie viele physische Platinen hergestellt wurden und ob sie an Kunden ausgeliefert wurden.
Verbindung zur NVIDIA DGX Station
Die Geschichte der P100 DGXS wird durch die zeitliche Einordnung zusätzlich erschwert. Die Tesla P100 wurde im April 2016 zusammen mit dem DGX-1-Server vorgestellt. Die DGX Station kündigte NVIDIA jedoch erst am 10. Mai 2017 offiziell an.
In der ursprünglichen Präsentation war die DGX Station mit vier Tesla-V100-Beschleunigern mit 16 GB HBM2 ausgestattet, die über NVLink verbunden waren. Das System verfügte über eine Flüssigkeitskühlung und wurde mit $69 000 bewertet.
Im Oktober 2017 berichtete das Magazin ServeTheHome dagegen, dass die DGX Station in einer frühen Phase vier P100 verwendete und später auf V100 umgestellt wurde. Das widerspricht der ursprünglichen offiziellen Ankündigung von NVIDIA, in der bereits Volta-Beschleuniger genannt wurden.
Möglicherweise ging es dabei um Prototypen oder vorläufige Konfigurationen. Öffentlich zugängliche Dokumente, die eine solche Auslieferung bestätigen, ließen sich jedoch nicht finden.
Daher kann das in Katalogen anzutreffende Erscheinungsdatum der P100 DGXS - April 2016 - nicht als bestätigt gelten. Es bezieht sich auf das Erscheinen des GP100 und nicht auf eine bekannte Veröffentlichung des DGXS-Modells.
Leistung: Was sich überprüfen lässt
Öffentlich zugängliche Testergebnisse speziell zur Tesla P100 DGXS ließen sich nicht finden. Um die Möglichkeiten der GP100-Architektur einzuschätzen, können Messungen der Serienversion Tesla P100 PCIe 16 GB herangezogen werden.
In einem von der llama.cpp-Community veröffentlichten Vergleich finden sich Ergebnisse mehrerer konkreter GPUs bei der Ausführung des Modells Llama 7B Q4_0.
| GPU | Prompt-Verarbeitung, Token/s | Generierung, Token/s |
|---|---|---|
| Tesla V100 32 GB | 2974 | 134,8 |
| GeForce RTX 2080 Ti | 2891 | 107,5 |
| GeForce RTX 3060 12 GB | 2138 | 75,6 |
| GeForce GTX 1080 Ti | 1084 | 62,5 |
| Tesla P100 16 GB | 761 | 58,4 |
Mehr ist besser. Die Daten wurden von Mitgliedern der llama.cpp-Community veröffentlicht. Es wurde ein Modell verwendet, aber die Testsysteme und Programmversionen unterschieden sich. Für die Tesla P100 ist das Ergebnis der PCIe-Version angegeben, nicht das der DGXS.
In diesem Test liegt die P100 bei der Generierungsgeschwindigkeit nur knapp hinter der GTX 1080 Ti, fällt bei der Prompt-Verarbeitung jedoch deutlich zurück. Ein Grund dafür ist das Fehlen von DP4A-Instruktionen im GP100, die Berechnungen mit quantisierten Daten beschleunigen.
Die hohe HBM2-Bandbreite gleicht diese Einschränkung nicht aus. Selbst bei SXM2-Taktraten hätte die unbekannte DGXS-Version die fehlenden Instruktionen nicht erhalten.
Der GP100 hat allerdings einen anderen Vorteil: FP64-Berechnungen. Die Serienversion Tesla P100 SXM2 erreicht 5,3 TFLOPS bei doppelter Genauigkeit, während die PCIe-Version 4,7 TFLOPS erreicht. Damit bleiben diese Modelle für bestimmte wissenschaftliche Berechnungen attraktiv, auch wenn sich die genaue Leistung der DGXS nicht bestimmen lässt.
Softwareunterstützung im Jahr 2026
Alle GP100-Beschleuniger verfügen über die CUDA Compute Capability 6.0. In modernen Bibliotheken für maschinelles Lernen wird dies zu einer erheblichen Einschränkung.
Die letzte CUDA-Toolkit-Version, mit der sich Anwendungen für Pascal kompilieren lassen, ist 12.9. Ab CUDA 13 wurde die Unterstützung für die Kompilierung für diese Architektur entfernt. Die letzte NVIDIA-Treiberversion für Pascal ist der Zweig R580, dessen Support 2028 endet.
Ältere CUDA-Programme werden mit kompatiblen Treibern weiterhin funktionieren, neue Builds von PyTorch und anderen Bibliotheken unterstützen GP100 jedoch möglicherweise nicht. Das Fehlen von Tensor Cores schränkt die Leistung bei neuronalen Berechnungen zusätzlich ein.
Für lokale Sprachmodelle sind 16 GB HBM2 weiterhin nützlich. Einen Beschleuniger ausschließlich anhand der Speicherkapazität und Speicherbandbreite auszuwählen, reicht jedoch nicht mehr aus.
Kann man eine P100 DGXS kaufen, und wodurch lässt sie sich ersetzen?
Bestätigte Angebote für eine Tesla P100 DGXS auf dem offenen Gebrauchtmarkt ließen sich nicht finden. Auch die Eigenschaften ihres physischen Aufbaus sind unbekannt: Anhand einer Gerätekennung allein lassen sich die Position der Anschlüsse, das Kühlsystem oder die Kompatibilität mit herkömmlichen Mainboards nicht bestimmen.
Wenn ein Beschleuniger auf Basis der GP100-Architektur benötigt wird, stehen besser einschätzbare Varianten zur Verfügung:
- Tesla P100 PCIe 16 GB. Standardmäßige PCIe-Anbindung, 16 GB HBM2 und eine FP64-Leistung von bis zu 4,7 TFLOPS. Erfordert einen starken gerichteten Luftstrom und eine geeignete Stromversorgung.
- Tesla P100 SXM2 16 GB. Höhere Leistung und Unterstützung für NVLink in kompatiblen Servern. Für einen herkömmlichen Computer sind ein Adapter und eine separate Kühlung erforderlich.
- Tesla V100 SXM2 16 GB. Volta-Architektur, Tensor Cores und eine FP64-Leistung von bis zu 7,8 TFLOPS. Für kompatible Aufgaben des maschinellen Lernens deutlich interessanter, erfordert jedoch ebenfalls eine spezielle Anbindung.
Für die Ausführung moderner lokaler LLMs ist eine GeForce RTX mit Tensor Cores und einer neueren Architektur häufig praktischer, selbst wenn ihre Videospeicherkapazität geringer ist.
Fazit
Tesla P100 DGXS ist eine reale Bezeichnung im Software-Ökosystem von NVIDIA, aber kein durch Dokumente bestätigtes Serienmodell. Die Kennungen in den Treibern und im DCGM weisen auf die Existenz einzelner GP100-Konfigurationen hin. Ihre kommerzielle Veröffentlichung und technische Ausführung bleiben jedoch unbekannt.
Der DGXS ohne zusätzliche Belege die technischen Daten der P100 SXM2 zuzuschreiben, wäre nicht korrekt. Für wissenschaftliche Berechnungen und CUDA-Experimente sollte man besser Serienmodelle wie die P100 PCIe oder SXM2 mit bekannten Spezifikationen und verfügbaren Testergebnissen wählen.
Die P100 DGXS ist vor allem als wenig bekannter Teil der Geschichte von NVIDIA DGX interessant - nicht als praktische Kaufoption im Jahr 2026.
GPU-Vergleich
Tesla P100 DGXS mit anderen GPUs vergleichen
Basic
Speicherspezifikationen
Anzeige und Medien
Theoretische Leistung
Verschiedenes
Benchmarks
Im Vergleich zu anderen GPUs
Verwandte GPU-Vergleiche


In sozialen Medien teilen
Oder verlinken Sie uns
<a href="https://cputronic.com/index.php/de/gpu/nvidia-tesla-p100-dgxs" target="_blank">NVIDIA Tesla P100 DGXS</a>