NVIDIA Tesla V100 PCIe 16 GB

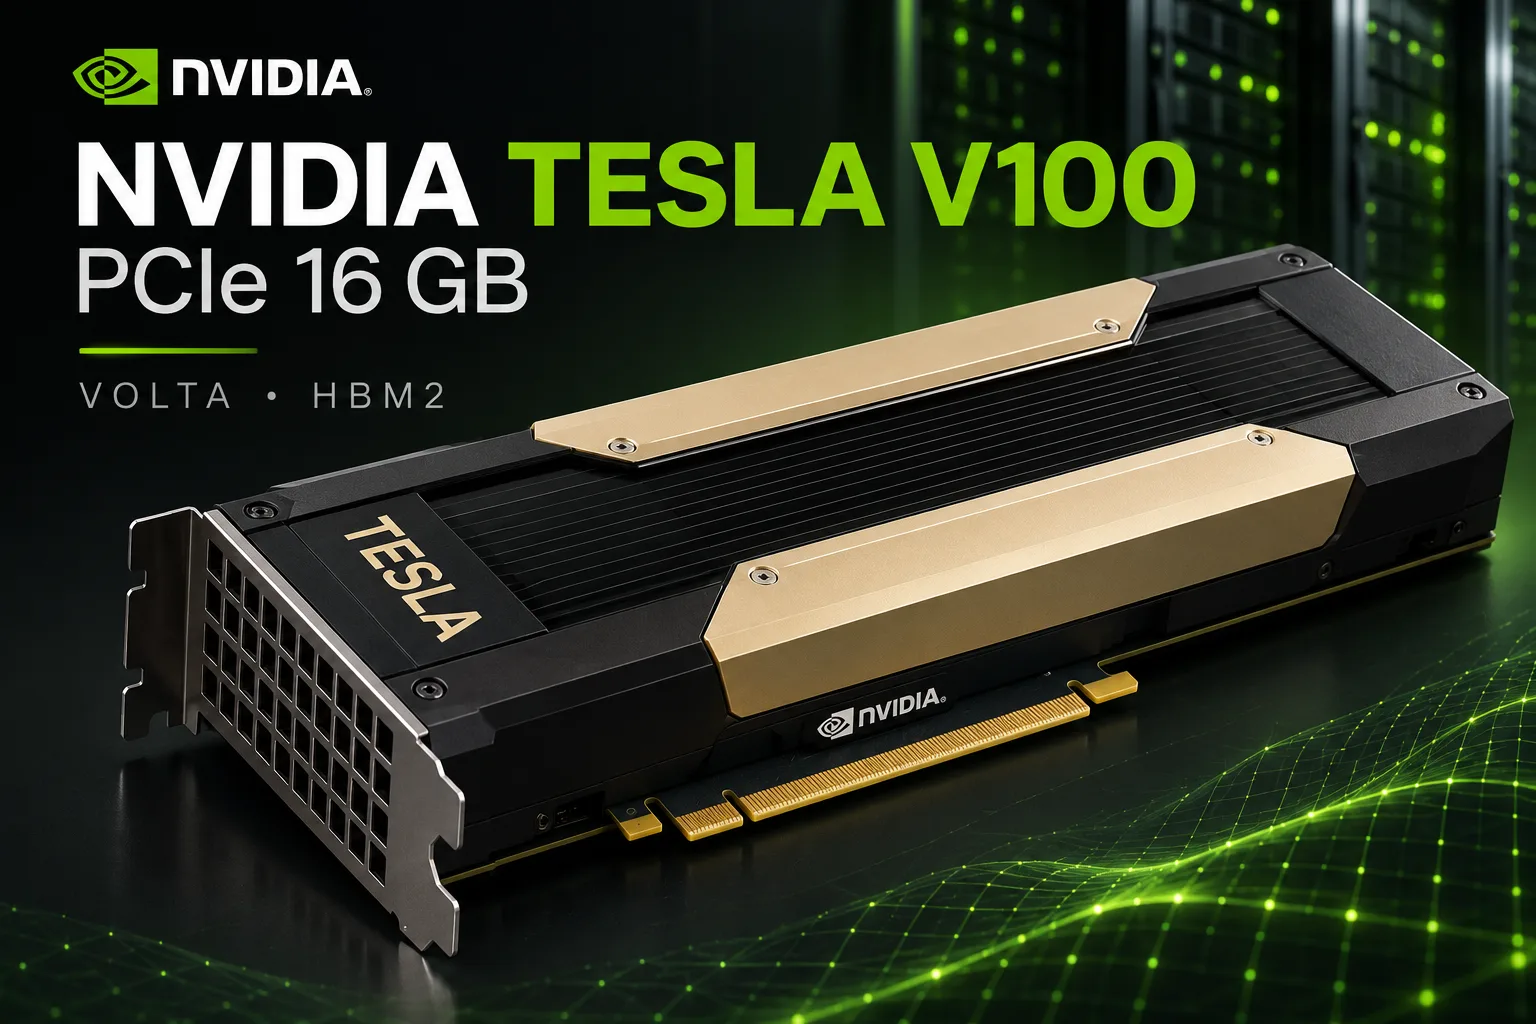
Tesla V100 PCIe 16 GB: 900 ГБ/с HBM2 за небольшие деньги, но с ограниченной поддержкой CUDA
Tesla V100 PCIe 16 GB - серверный ускоритель 2017 года, который до сих пор интересен для локальных нейросетей и научных расчётов. Его главное достоинство - память HBM2 с пропускной способностью 900 ГБ/с, почти как у GeForce RTX 3090. На вторичном рынке карта стоит несколько сотен долларов, хотя самые дешёвые предложения часто оказываются модулями SXM2, а не полноценными PCIe-картами.
За невысокую цену приходится мириться с ограничениями. У V100 нет видеовыходов и аппаратной трассировки лучей, 16 ГБ памяти недостаточно для крупных языковых моделей, а поддержка новых версий CUDA закончилась. NVIDIA оставила Volta на ветке драйверов R580, сопровождение которой продлится до середины 2028 года. Для запуска современных LLM всё чаще приходится самостоятельно подбирать совместимые версии программ.
Положение в линейке
Tesla V100 построена на кристалле GV100 площадью 815 мм², изготовленном по 12-нм техпроцессу TSMC FFN. Из 84 потоковых мультипроцессоров активны 80, что даёт 5120 CUDA-ядер и 640 тензорных ядер первого поколения. Четыре стека HBM2 подключены по 4096-битной шине.
На базе GV100 NVIDIA выпустила несколько ускорителей с разными объёмами памяти, частотами и интерфейсами.
| Модель | Память | Пропускная способность | Boost | TDP | Особенности |
|---|---|---|---|---|---|
| Tesla V100 PCIe 16 GB | 16 ГБ HBM2 | 900 ГБ/с | 1380 МГц | 250 Вт | PCIe 3.0 x16, без NVLink |
| Tesla V100 PCIe 32 GB | 32 ГБ HBM2 | 900 ГБ/с | 1380 МГц | 250 Вт | Удвоенный объём памяти |
| Tesla V100 SXM2 16/32 GB | 16/32 ГБ HBM2 | 900 ГБ/с | 1530 МГц | 300 Вт | SXM2, поддержка NVLink |
| Tesla V100S PCIe 32 GB | 32 ГБ HBM2 | 1134 ГБ/с | 1601 МГц | 250 Вт | Более быстрая HBM2 |
| Titan V | 12 ГБ HBM2 | 653 ГБ/с | 1455 МГц | 250 Вт | Видеовыходы, шина 3072 бит |
| Quadro GV100 | 32 ГБ HBM2 | 870 ГБ/с | 1627 МГц | 250 Вт | Профессиональная графика |
PCIe-версия на 16 ГБ развивает до 14 TFLOPS в FP32, 7 TFLOPS в FP64 и 112 TFLOPS в тензорных вычислениях FP16. Это немного меньше показателей SXM2, у которой выше частота и лимит мощности.
Volta первой среди архитектур NVIDIA получила тензорные ядра. Однако они поддерживают только FP16 и не работают с BF16, TF32 и FP8. Отсутствие этих форматов ограничивает эффективность современных библиотек и моделей. Аппаратных RT-ядер у GV100 также нет.
Производительность
Локальные языковые модели
При генерации токенов производительность часто ограничивается скоростью чтения весов из видеопамяти. Поэтому V100 с её 900 ГБ/с сохраняет конкурентоспособность даже на фоне значительно более новых GPU.
Для сравнения можно использовать опубликованную разработчиками llama.cpp таблицу результатов Llama 2 7B в квантовании Q4_0. В ней измеряются скорость обработки промпта из 512 токенов и генерация 128 токенов без FlashAttention.
| Видеокарта | Память | Обработка промпта, ток/с | Генерация, ток/с |
|---|---|---|---|
| Tesla P40 | 24 ГБ GDDR5 | 1007 | 55 |
| Tesla V100 PCIe 32 GB | 32 ГБ HBM2 | 3043 | 129 |
| GeForce RTX 3090 | 24 ГБ GDDR6X | 5175 | 158 |
| GeForce RTX 4090 | 24 ГБ GDDR6X | 11 993 | 186 |
| GeForce RTX 5090 | 32 ГБ GDDR7 | 14 073 | 290 |
Результаты собраны из тестов разных пользователей. Модель и основные параметры одинаковые, но версии llama.cpp, драйверы и конфигурации систем могут различаться.
В таблице протестирована V100 PCIe 32 GB. У 16-гигабайтной версии те же частоты и пропускная способность HBM2, а сама модель занимает менее 4 ГБ. Поэтому ожидается близкая производительность, хотя прямого измерения именно 16-гигабайтной карты здесь нет.
В генерации V100 отстаёт от RTX 3090 примерно на 18%, а в обработке промпта - на 41%. Для короткого диалога разница не всегда существенна, но при обработке больших документов и длинной истории переписки она становится заметнее.
RTX 4090 обрабатывает промпт почти в четыре раза быстрее V100, хотя в генерации преимущество составляет лишь 44%. Это показывает, почему одна пропускная способность памяти не определяет производительность во всех задачах.
Главное ограничение V100 PCIe 16 GB - объём памяти. Карта подходит для 7-14-миллиардных моделей в 4-битном квантовании. Модели на 27-32 млрд параметров обычно требуют частичной выгрузки в оперативную память или более сильного сжатия. В обоих случаях приходится идти на компромиссы по скорости, качеству или длине контекста.
Обучение и научные расчёты
V100 создавалась прежде всего для обучения нейросетей и высокопроизводительных вычислений. Тензорные ядра FP16 по-прежнему полезны, но новые ускорители получили более эффективные форматы вычислений, увеличенные кеши и оптимизированные библиотеки.
Особенно заметны ограничения при обучении моделей, использующих BF16. У V100 нет аппаратной поддержки этого формата, поэтому не все современные конфигурации PyTorch и других фреймворков можно перенести на Volta без изменений.
Зато в вычислениях двойной точности карта сохраняет серьёзное преимущество перед игровыми GeForce. Её производительность достигает 7 TFLOPS FP64, примерно в 5,4 раза больше, чем у RTX 4090.
Для молекулярной динамики, численного моделирования и других HPC-задач V100 остаётся интересной, если используемое программное обеспечение поддерживает Volta. Однако высокая паспортная скорость FP64 сама по себе не гарантирует такого же преимущества в конкретной программе.
Можно ли играть на Tesla V100
У V100 PCIe нет видеовыходов. Для отображения изображения потребуется другая видеокарта или встроенная графика процессора. В Windows также необходимо подобрать совместимый драйвер и настроить запуск игр на вычислительном ускорителе.
Энтузиасты проверили игровые возможности V100 SXM2 16 GB через переходник PCIe. В системе с Ryzen 7 5700GE карта показала следующие результаты на высоких настройках без масштабирования и генерации кадров.
| Игра | 2560×1080, средний FPS | 3440×1440, средний FPS |
|---|---|---|
| Cyberpunk 2077 | ~78 | ~56 |
| Hogwarts Legacy | ~55-60 | ~40 |
| Atomic Heart | ~115 | ~75-80 |
| Red Dead Redemption 2 | ~80 | ~65 |
В Cyberpunk 2077 энергопотребление ускорителя составляло около 181 Вт. Результаты показывают, что Volta ещё способна справляться с современными играми, хотя отсутствие DLSS и аппаратной трассировки лучей существенно ограничивает её возможности.
Важно, что это тесты SXM2, а не PCIe. У SXM2 частота Boost достигает 1530 МГц против 1380 МГц у PCIe, а лимит мощности выше на 50 Вт. Поэтому PCIe-версия может оказаться медленнее. Определить разницу в FPS без отдельных измерений нельзя.
Покупать V100 специально для игр невыгодно. Обычная GeForce проще в установке, поддерживает современные графические технологии и не требует дополнительной видеокарты для вывода изображения.
Установка в обычный компьютер
В отличие от SXM2, Tesla V100 PCIe подключается непосредственно к стандартному слоту PCIe x16. Однако установка в домашний ПК всё равно требует подготовки.
Питание. У референсной V100 PCIe предусмотрен 8-контактный разъём CPU EPS12V. Он отличается от обычного 8-контактного разъёма PCIe. NVIDIA допускает подключение подходящего кабеля EPS12V или использование специального переходника с разъёмами PCIe.
Перед первым включением необходимо проверить распиновку и допустимую нагрузку кабелей. Подключать неподходящий кабель только потому, что разъём похож, нельзя.
Охлаждение. Карта оснащена пассивным радиатором, рассчитанным на интенсивный поток воздуха внутри сервера. В обычном корпусе потребуется отдельный вентилятор с направленным обдувом.
Без достаточного охлаждения ускоритель может сбрасывать частоты или перегреваться. Проверять следует не только температуру ядра, но и стабильность работы под длительной нагрузкой.
Потребление. Паспортный лимит составляет 250 Вт. Через nvidia-smi можно снизить допустимую мощность, например до 180 Вт. Это уменьшит нагрев и требования к охлаждению, но влияние на производительность зависит от задачи.
Поддержка программ: главное ограничение
NVIDIA подтвердила, что R580 станет последней веткой драйверов с поддержкой Maxwell, Pascal и Volta. Для серверных ускорителей она относится к линейке долгосрочной поддержки с окончанием сопровождения в июне 2028 года.
CUDA 13 больше не позволяет компилировать приложения для архитектуры Volta с вычислительными возможностями sm_70. Последняя совместимая линейка CUDA Toolkit - 12.x, включая версию 12.9.
При этом V100 не перестала работать после выхода CUDA 13. Программы, собранные с поддержкой Volta на более ранних версиях CUDA, продолжают запускаться с совместимыми драйверами.
Проблема заключается в новых версиях программ и библиотек:
- llama.cpp. Исходный код позволяет собирать совместимые версии под sm_70, но новые оптимизации могут не поддерживать Volta.
- PyTorch. Для V100 необходимо выбирать сборки с поддержкой CUDA 12.x и соответствующих вычислительных архитектур.
- LM Studio и Ollama. Совместимость зависит от версии приложения и поставляемого CUDA-runtime. Некоторые функции могут требовать более старых сборок.
- FlashAttention 2. Обычная CUDA-реализация рассчитана на более новые архитектуры, поэтому V100 приходится использовать альтернативные механизмы обработки внимания.
Для домашних экспериментов это приемлемо: совместимое окружение можно сохранить и обновлять выборочно. Для рабочего сервера ограничения серьёзнее, поскольку новые версии фреймворков постепенно перестают поддерживать Volta.
Цены на вторичном рынке
Стоимость V100 заметно различается в зависимости от исполнения. Дешёвые SXM2-модули часто попадают в общие результаты поиска Tesla V100, хотя установить их в ПК без переходника невозможно.
По сводке предложений eBay на 28 октября 2026 года ситуация выглядит так:
| Видеокарта | Нижний диапазон предложений | Медиана объявлений |
|---|---|---|
| Tesla V100 PCIe 16 GB, пассивное исполнение | $329 | $422 |
| Tesla V100 SXM2 16 GB | $191 | $300 |
| Tesla V100 SXM2 32 GB | $842 | $990 |
| Tesla V100 PCIe 32 GB, пассивное исполнение | $860 | $960 |
| GeForce RTX 3090 24 GB | $1651 | $1970 |
Цены относятся к активным объявлениям, а не завершённым сделкам. Отдельные продажи V100 PCIe 16 GB проходили примерно за $240-275, но такие предложения нельзя считать гарантированно доступными.
Для PCIe-версии на 16 ГБ разумно ориентироваться на $300-350 за исправную карту с возможностью проверки. При цене около $400 покупка становится менее привлекательной, особенно если дополнительно нужны охлаждение и кабель питания.
Стоимость готовой домашней сборки может оказаться заметно выше цены самого ускорителя. Поэтому сравнивать V100 с альтернативами следует только после учёта всех комплектующих.
Конкуренты и альтернативы
Tesla V100 SXM2 16 GB. Сам модуль дешевле PCIe-версии, но требует переходника, питания и отдельного охлаждения. Итоговая стоимость может оказаться сопоставимой с готовой PCIe-картой. Для одного GPU преимущество SXM2 обычно не оправдывает сложную сборку. Другое дело - многомодульные платы с NVLink.
Tesla V100 PCIe 32 GB. Та же вычислительная архитектура и пропускная способность памяти, но вдвое больший объём HBM2. Существенно лучше подходит для языковых моделей на 27-32 млрд параметров. Однако при цене $800-1000 экономическое преимущество старой архитектуры уже не столь очевидно.
GeForce RTX 3090 24 GB. Быстрее в обработке промптов, поддерживает BF16, современные оптимизации CUDA и аппаратную трассировку лучей. Её 24 ГБ позволяют работать с более крупными моделями, чем на V100 16 GB. На вторичном рынке встречаются объявления примерно от $1200, хотя основная масса предложений дороже. Это более универсальная карта, но переплата значительна.
GeForce RTX 5060 Ti 16 GB. Новая архитектура, поддержка актуальных библиотек, видеовыходы, DLSS 4 и гарантия производителя. Пропускная способность памяти ниже - 448 ГБ/с против 900 ГБ/с у V100. Однако напрямую предсказывать по этой разнице скорость LLM нельзя: современные вычислительные ядра и программные оптимизации способны компенсировать недостаток пропускной способности. Для игр и повседневной работы RTX 5060 Ti предпочтительнее.
AMD Instinct MI50 32 GB. Альтернатива с удвоенным объёмом HBM2, пропускной способностью около 1 ТБ/с и высокой производительностью FP64. Цены отдельных объявлений начинаются примерно от $650. Главное ограничение - устаревающая поддержка ROCm и сложности с современным вычислительным ПО. Для программ, рассчитанных на CUDA, V100 обычно проще.
Tesla P40 24 GB. Более старая карта с GDDR5 и 24 ГБ памяти. В тесте llama.cpp она генерирует около 55 ток/с против 129 у V100. Однако дополнительные 8 ГБ позволяют запускать модели, которые не помещаются в V100 16 GB. Поэтому P40 остаётся альтернативой, если объём памяти важнее скорости.
Стоит ли покупать Tesla V100 PCIe 16 GB
Tesla V100 PCIe 16 GB по-прежнему привлекательна для локальных нейросетей, научных расчётов и экспериментов с CUDA. За несколько сотен долларов покупатель получает 900 ГБ/с пропускной способности памяти, 640 тензорных ядер и 7 TFLOPS в FP64.
Однако 16 ГБ ограничивают выбор языковых моделей, а программная поддержка Volta постепенно сокращается. Карта требует направленного охлаждения, подходящего питания и внимательного выбора версий драйверов и библиотек.
При цене до $300-350 V100 PCIe 16 GB можно считать удачной покупкой для домашнего вычислительного стенда. Если карта стоит $400 и дороже, следует сравнить её с SXM2 16 GB, P40 24 GB и более современными ускорителями, учитывая расходы на установку.
Для моделей до 14 млрд параметров возможностей V100 обычно достаточно. Если цель - локальный запуск моделей на 27-32 млрд параметров без выгрузки в оперативную память, лучше сразу рассматривать видеокарту с 24-32 ГБ памяти.
V100 стоит покупать ради конкретных вычислительных задач, а не как универсальную видеокарту. Её производительности ещё хватает для многих экспериментов, но рассчитывать на полноценную поддержку нового ПО в следующие несколько лет уже нельзя.
Сравнение GPU
Сравнить Tesla V100 PCIe 16 GB с другими GPUs
Общая информация
Характеристики памяти
Дисплей и мультимедиа
Теоретическая производительность
Другое
Бенчмарки
По сравнению с другими GPU
Похожие сравнения видеокарт


Поделиться в социальных сетях
Или разместите ссылку на нас
<a href="https://cputronic.com/index.php/ru/gpu/nvidia-tesla-v100-pcie-16-gb" target="_blank">NVIDIA Tesla V100 PCIe 16 GB</a>