NVIDIA Tesla P100 PCIe 16 GB

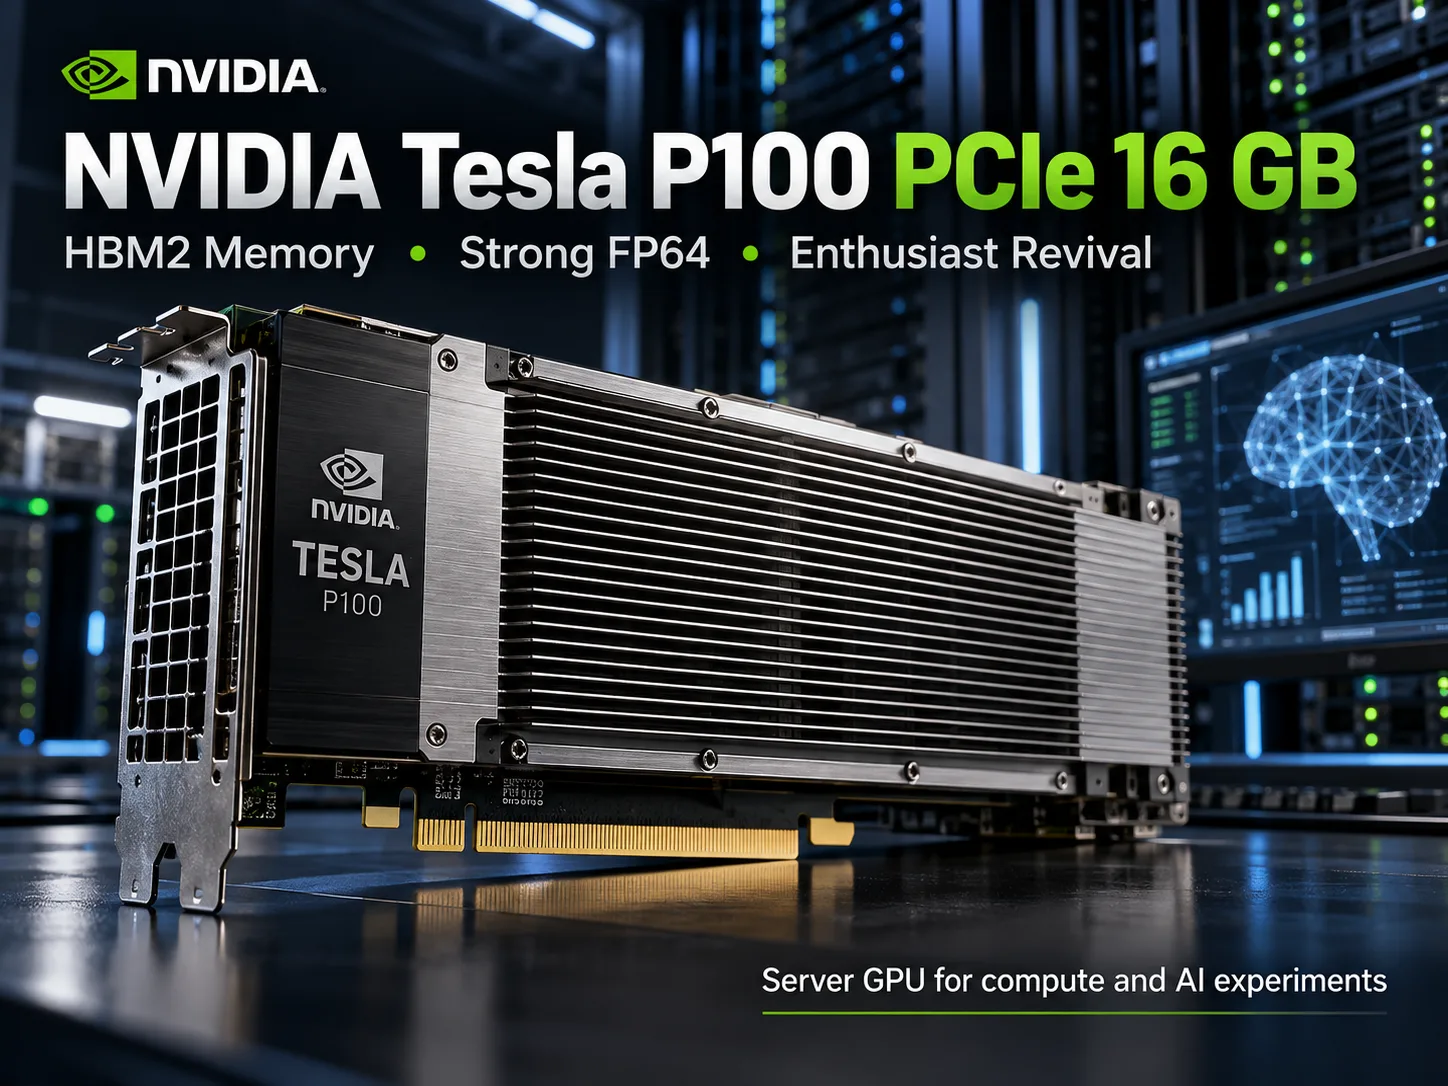
NVIDIA Tesla P100 PCIe 16 GB: почему старая Tesla снова заинтересовала энтузиастов
NVIDIA Tesla P100 PCIe 16 GB вышла в 2016 году как ускоритель для научных вычислений и суперкомпьютеров. Спустя десять лет списанные серверные карты получили вторую жизнь: энтузиасты покупают их для домашних серверов, экспериментов с нейросетями и CUDA-программами. Причина проста - 16 ГБ памяти HBM2 и высокая вычислительная мощность теперь доступны за небольшие деньги. Но низкая цена скрывает проблемы: пассивное охлаждение, устаревающую поддержку CUDA и отсутствие Tensor Cores.
Чем P100 отличается от P40 и V100
Tesla P100 построена на 16-нм процессоре GP100 архитектуры Pascal. Она получила 3584 CUDA-ядра и 4096-битную шину памяти. Главная особенность - мощные блоки FP64, практически не встречающиеся в потребительских видеокартах того поколения.
| Характеристика | Tesla P100 PCIe | Tesla P40 | Tesla V100 PCIe |
|---|---|---|---|
| Архитектура | Pascal | Pascal | Volta |
| CUDA-ядер | 3584 | 3840 | 5120 |
| Память | 16 ГБ HBM2 | 24 ГБ GDDR5 | 16 ГБ HBM2 |
| Пропускная способность | 732 ГБ/с | 346 ГБ/с | 900 ГБ/с |
| FP32 | 9,3 TFLOPS | 12 TFLOPS | 14 TFLOPS |
| FP64 | 4,7 TFLOPS | ~0,375 TFLOPS | 7 TFLOPS |
| Tensor Cores | Нет | Нет | 640 |
P40 располагает большим объёмом видеопамяти, но P100 превосходит её в пропускной способности более чем вдвое, а в теоретической производительности FP64 - примерно в 12,5 раза.
V100 существенно мощнее обеих карт. Её преимущество заключается не только в скорости вычислений, но и в наличии Tensor Cores, ускоряющих операции, востребованные в машинном обучении.
Производительность в бенчмарках
В Geekbench 7 OpenCL P100 PCIe занимает промежуточное положение между Tesla T4 и GeForce RTX 3060. Серверная V100 на архитектуре Volta более чем вдвое быстрее.
| Видеокарта | Geekbench 7 OpenCL |
|---|---|
| NVIDIA Tesla V100 SXM2 16 GB | 152 601 |
| NVIDIA GeForce RTX 3060 | 88 251 |
| NVIDIA Tesla P100 SXM2 16 GB | 87 454 |
| NVIDIA Tesla P100 PCIe 16 GB | 71 673 |
| NVIDIA Tesla T4 16 GB | 60 483 |
Это агрегированные результаты Geekbench Browser, полученные на разных системах. Они подходят для общего сравнения GPU, но не показывают скорость научных расчётов FP64 или работы языковых моделей.
P100 PCIe опережает T4 примерно на 19%, но уступает собственной версии SXM2 на 18%. При этом SXM2 требует специальной серверной платформы и не устанавливается в обычный слот PCIe.
Почему P100 до сих пор интересна для вычислений
В научных приложениях FP64 используется для расчётов, требующих высокой численной точности: моделирования физических процессов, вычислительной гидродинамики и некоторых инженерных задач.
Например, при выполнении операций с матрицами двойной точности Tesla P100 располагает теоретической производительностью 4,7 TFLOPS против примерно 0,375 TFLOPS у P40. Разница огромная, хотя реальное ускорение зависит от алгоритма, объёма обмена с памятью и эффективности программы.
Память HBM2 также помогает в задачах, обрабатывающих большие массивы данных. Её пропускная способность 732 ГБ/с особенно полезна при интенсивном чтении и записи. Поддержка ECC дополнительно повышает надёжность длительных расчётов.
Поэтому P100 нельзя считать просто устаревшей видеокартой. В совместимых научных приложениях она по-прежнему способна выполнять полезную работу.
Вторая жизнь на вторичном рынке
К 2026 году Tesla P100 привлекла внимание владельцев домашних серверов и любителей экспериментировать с недорогим оборудованием. Карты, ранее работавшие в дата-центрах, появляются на вторичном рынке по ценам, несопоставимым с их первоначальной стоимостью.
В октябре 2026 года на американском eBay встречались объявления о продаже P100 PCIe 16 GB примерно за $100-160. Отдельные энтузиасты сообщают о покупках за $75-80. Цена зависит от состояния, продавца и региона.
За сравнительно небольшие деньги покупатель получает 16 ГБ видеопамяти с высокой пропускной способностью. Именно это привлекает людей, собирающих домашние вычислительные серверы или пробующих запускать локальные LLM без покупки дорогих современных ускорителей.
Однако P100 - не обычная видеокарта, которую достаточно вставить в компьютер:
- Охлаждение. Карта оснащена пассивным радиатором и рассчитана на мощный направленный воздушный поток. Для домашнего ПК обычно требуется отдельный вентилятор с воздуховодом.
- Питание. Используется восьмиконтактный разъём CPU/EPS. Обычный кабель PCIe 8-pin нельзя подключать без проверки распиновки.
- Совместимость. На некоторых старых материнских платах требуется настройка Above 4G Decoding.
- Программное обеспечение. Новые CUDA-библиотеки не всегда поддерживают архитектуру Pascal. Некоторые приложения приходится собирать самостоятельно со старыми зависимостями.
При покупке стоит запросить результаты диагностики nvidia-smi, проверить ошибки памяти и уточнить, проходила ли карта длительный тест под нагрузкой. Дешёвый экземпляр с неисправной HBM2 практически бесполезен.
Подходит ли P100 для локальных нейросетей
P100 способна запускать совместимые языковые модели в квантованных форматах. В 16 ГБ памяти помещаются многие модели класса 7-8 млрд параметров, а также некоторые более крупные модели при подходящей степени квантования и размере контекста.
Но высокая скорость памяти не компенсирует отсутствие Tensor Cores. Кроме того, у GP100 нет нативной поддержки BF16, а Compute Capability 6.0 ограничивает совместимость с современными ML-библиотеками.
Начиная с CUDA 13.0 NVIDIA исключила поддержку компиляции под Pascal. Для разработки на P100 приходится использовать CUDA 12.x и подходящие версии библиотек. Это не означает, что все старые приложения перестали работать, но установка современных ML-стеков стала сложнее.
Для экспериментов с LLM P100 пригодна, особенно если карта уже есть. Однако при покупке специально под языковые модели стоит сравнить её с P40 на 24 ГБ и V100. Первая позволяет размещать более крупные модели целиком в памяти, а вторая предлагает Tensor Cores и значительно большую вычислительную производительность. Наличие большего объёма памяти не гарантирует более высокой скорости генерации.
Стоит ли покупать Tesla P100 в 2026 году
При цене около $100 рабочая P100 PCIe 16 GB остаётся привлекательной для энтузиастов, готовых самостоятельно организовать охлаждение и настроить CUDA. Особенно если требуется недорогой ускоритель для FP64-вычислений.
Для локальных LLM покупка менее очевидна. Помимо самой карты придётся учитывать охлаждение, питание, потребление до 250 Вт и время на настройку совместимого ПО. Если основная цель - удобный запуск современных моделей, V100 или более новые RTX предпочтительнее.
Tesla P100 не стала современной видеокартой благодаря низкой цене. Но как дешёвый вычислительный ускоритель с 16 ГБ HBM2 она сохранила свою нишу. Для научных расчётов и экспериментов это интересное оборудование. Для универсального домашнего ПК и беспроблемной работы с ИИ - неудачный выбор.
Сравнение GPU
Сравнить Tesla P100 PCIe 16 GB с другими GPUs
Общая информация
Характеристики памяти
Дисплей и мультимедиа
Теоретическая производительность
Другое
Бенчмарки
По сравнению с другими GPU
Похожие сравнения видеокарт


Поделиться в социальных сетях
Или разместите ссылку на нас
<a href="https://cputronic.com/index.php/ru/gpu/nvidia-tesla-p100-pcie-16-gb" target="_blank">NVIDIA Tesla P100 PCIe 16 GB</a>