NVIDIA GeForce RTX 5080
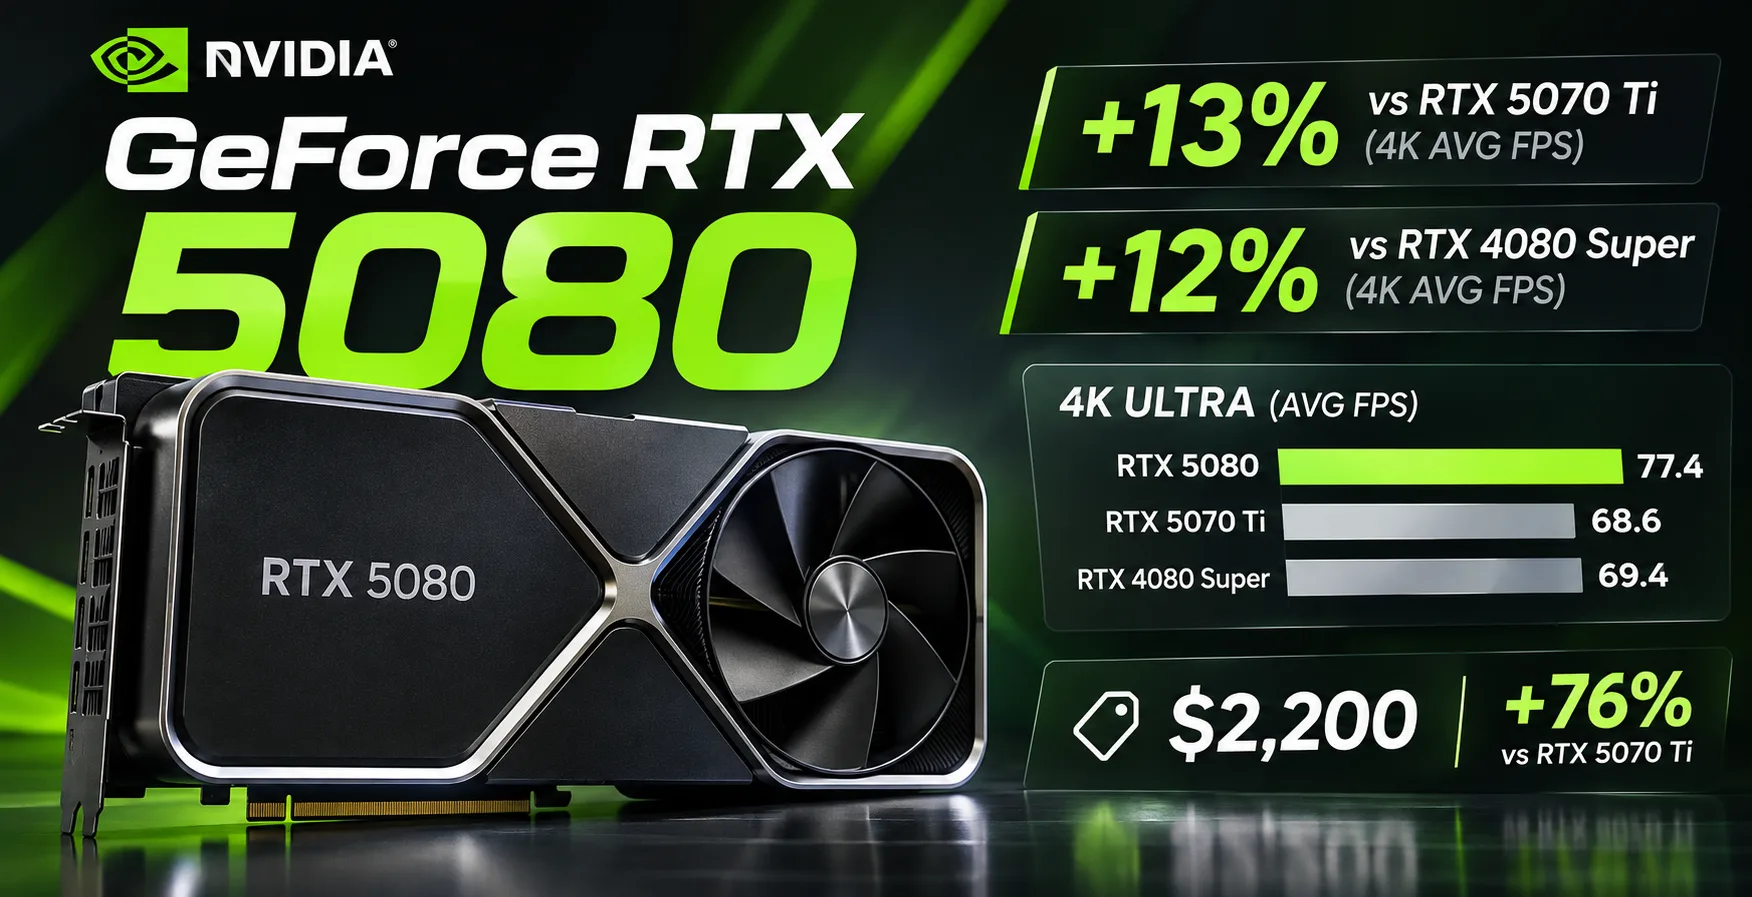
GeForce RTX 5080: на 13% быстрее RTX 5070 Ti в 4K, но на 76% дороже
GeForce RTX 5080 вышла в январе 2025 года за $999, но к октябрю 2026 года минимальная цена доступных предложений в США достигла $2200. При этом RTX 5070 Ti за $1250 уступает ей в среднем лишь 13% по частоте кадров в 4K. Разница в цене составляет $950, хотя обе карты имеют 16 ГБ видеопамяти и поддерживают DLSS Multi Frame Generation.
Обновление относительно RTX 4080 Super тоже оказалось скромным. По результатам тестов Tom's Hardware, RTX 5080 быстрее предшественницы примерно на 12% в 4K без трассировки лучей. Наиболее заметное преимущество перед RTX 5070 Ti она показывает в играх с тяжелой трассировкой лучей, но и там прирост не соответствует разнице в цене.
Blackwell и GDDR7: что изменилось
RTX 5080 построена на графическом процессоре GB203 с 10 752 ядрами CUDA. Она использует память GDDR7 с пропускной способностью 960 ГБ/с вместо GDDR6X у RTX 4080 Super. Пропускная способность выросла на 30%, но объем памяти остался прежним.
| Характеристика | RTX 5080 | RTX 4080 Super | RTX 5070 Ti |
|---|---|---|---|
| Архитектура | Blackwell | Ada Lovelace | Blackwell |
| CUDA-ядра | 10 752 | 10 240 | 8 960 |
| Память | 16 ГБ GDDR7 | 16 ГБ GDDR6X | 16 ГБ GDDR7 |
| Пропускная способность | 960 ГБ/с | 736 ГБ/с | 896 ГБ/с |
| Boost-частота | 2617 МГц | 2550 МГц | 2452 МГц |
| TGP | 360 Вт | 320 Вт | 300 Вт |
RTX 5080 получила RT-ядра четвертого поколения, Tensor-ядра пятого поколения, PCIe 5.0 и DisplayPort 2.1b.
Номинальный TGP увеличился с 320 до 360 Вт, хотя фактическое энергопотребление зависит от нагрузки. NVIDIA рекомендует блок питания мощностью 850 Вт. Для подключения используется 16-контактный кабель питания или комплектный переходник на три 8-контактных разъема.
3DMark Time Spy
| Видеокарта | Graphics Score |
|---|---|
| GeForce RTX 4090 | 36 676 |
| GeForce RTX 5080 | 31 987 |
| Radeon RX 9070 XT | 29 464 |
| GeForce RTX 4080 Super | 27 920 |
| GeForce RTX 5070 Ti | 27 727 |
Результаты ComputerBase.
RTX 5080 опережает RTX 4080 Super и RTX 5070 Ti примерно на 15%, но уступает RTX 4090 предыдущего поколения.
Игровые тесты: 1440p и 4K без масштабирования
Сводные результаты Tom's Hardware за июнь 2026 года позволяют сравнить видеокарты без DLSS, FSR и генерации кадров.
| Видеокарта | 1440p Ultra | 4K Ultra | 4K с RT |
|---|---|---|---|
| RTX 4090 | 143,4 | 89,1 | 52,2 |
| RTX 5080 | 128,3 | 77,4 | 42,1 |
| RTX 4080 Super | 118,6 | 69,4 | 38,5 |
| RTX 5070 Ti | 116,8 | 68,6 | 36,7 |
| Radeon RX 9070 XT | 116,5 | 65,8 | 30,1 |
Средний FPS. Растеризация и трассировка лучей измерялись в отдельных наборах игр.
При 1440p RTX 5080 быстрее RTX 5070 Ti на 10%, при 4K преимущество увеличивается до 13%. RTX 4080 Super уступает новой карте примерно 12% в 4K, а RTX 4090 сохраняет лидерство.
С трассировкой лучей преимущество RTX 5080 над RTX 5070 Ti достигает 15%, а над Radeon RX 9070 XT - 40%. Однако средние 42 FPS в 4K с RT означают, что для более высокой частоты кадров потребуется масштабирование или снижение настроек.
Death Stranding 2: сравнение с DLSS и FSR
В тестах ComputerBase от марта 2026 года использовались очень высокие настройки графики, DLSS 4 Quality для NVIDIA и FSR 4.1 Quality для Radeon RX 9000. Генерация кадров была отключена.
| Видеокарта | 1440p | 4K | 4K с RT |
|---|---|---|---|
| RTX 4090 | 124,8 | 105,5 | 65,5 |
| RTX 5080 | 125,8 | 96,4 | 57,0 |
| RTX 4080 Super | 104,1 | 82,3 | 49,2 |
| RTX 5070 Ti | 110,4 | 84,6 | 49,2 |
| Radeon RX 9070 XT | 106,9 | 79,0 | 41,2 |
Средний FPS. В режиме RT используется максимальная трассировка лучей. Качество изображения при DLSS и FSR может различаться.
RTX 5080 быстрее RTX 5070 Ti на 14% в 4K и на 16% с трассировкой лучей. RTX 4090 сохраняет лидерство в 4K, хотя при 1440p немного уступает новой карте.
Цена: сколько стоит дополнительная производительность
По исследованию TechSpot, опубликованному 2 ноября 2026 года, минимальные цены доступных видеокарт в американских магазинах за октябрь составляли $2200 для RTX 5080, $1250 для RTX 5070 Ti и $870 для Radeon RX 9070 XT.
| Видеокарта | Цена в США | FPS в 4K | Цена за FPS |
|---|---|---|---|
| RTX 5080 | $2200 | 77,4 | $28,42 |
| RTX 5070 Ti | $1250 | 68,6 | $18,22 |
| Radeon RX 9070 XT | $870 | 65,8 | $13,22 |
Цена за FPS рассчитана по средним результатам 4K Ultra без трассировки лучей. Показатель используется только для сравнения стоимости производительности.
В пересчете на один FPS RTX 5080 обходится на 56% дороже RTX 5070 Ti. Radeon RX 9070 XT предлагает около 85% производительности RTX 5080 при цене в 2,5 раза ниже.
RTX 5070 Ti тоже значительно подорожала относительно рекомендованных $749, однако в сравнении с RTX 5080 остается более выгодной покупкой.
DLSS и трассировка лучей
RTX 5080 поддерживает DLSS Multi Frame Generation, которая создает дополнительные кадры между рассчитанными игровым движком. Технология повышает визуальную плавность, но не дает пропорционального улучшения отзывчивости управления.
RTX 5070 Ti поддерживает ту же технологию. Преимущество RTX 5080 заключается в более высокой исходной частоте кадров, особенно в играх с path tracing. Для владельцев 4K-мониторов с высокой частотой обновления эта разница может быть важна, хотя в тяжелых играх даже RTX 5080 не всегда позволяет обойтись без масштабирования.
Blender, видеомонтаж и нейросети
RTX 5080 поддерживает CUDA, OptiX и аппаратное кодирование AV1. Два видеокодировщика NVENC девятого поколения позволяют ускорять обработку совместимых видеоформатов, включая 10-битный HEVC 4:2:2.
В тестах Puget Systems результаты Blender Benchmark выглядят следующим образом:
| Видеокарта | Blender Benchmark |
|---|---|
| RTX 5090 | 15 872 |
| RTX 5080 | 9 035 |
| RTX 5070 Ti | 7 882 |
| Radeon RX 9070 XT | 3 722 |
RTX 5080 быстрее RTX 5070 Ti на 15%. Radeon RX 9070 XT значительно уступает при рендеринге через HIP, поэтому для регулярной работы в Blender ускорители NVIDIA предпочтительнее.
Для локальных нейросетей RTX 5080 ограничена 16 ГБ видеопамяти. Например, языковая модель на 32 миллиарда параметров с 4-битной квантизацией обычно не помещается в такой объем целиком с учетом служебных данных и KV-кеша. Точные требования зависят от формата квантования и размера контекста.
Если модель помещается в VRAM, RTX 5080 обеспечивает высокую скорость вычислений. Для более крупных моделей дополнительный объем видеопамяти часто полезнее, чем более производительный GPU.
Стоит ли покупать GeForce RTX 5080 в 2026 году
При цене $2200 RTX 5080 трудно рекомендовать для обычных игр. RTX 5070 Ti стоит на $950 меньше, имеет те же 16 ГБ памяти и уступает в среднем только 13% по FPS в 4K. Radeon RX 9070 XT еще выгоднее, если не требуется высокая производительность трассировки лучей.
RTX 5080 имеет смысл для 4K с тяжелыми графическими эффектами, Blender и CUDA-задач, которым достаточно 16 ГБ видеопамяти. Владельцам RTX 4080 Super обновляться не стоит: прирост около 12% в 4K слишком мал для такой дорогой замены.
Сравнение GPU
Сравнить GeForce RTX 5080 с другими GPUs
Общая информация
Характеристики памяти
Дисплей и мультимедиа
3x DisplayPort 2.1b
Теоретическая производительность
Другое
Бенчмарки
По сравнению с другими GPU
Похожие сравнения видеокарт


Поделиться в социальных сетях
Или разместите ссылку на нас
<a href="https://cputronic.com/index.php/ru/gpu/nvidia-geforce-rtx-5080" target="_blank">NVIDIA GeForce RTX 5080</a>