NVIDIA Tesla P100 PCIe 12 GB

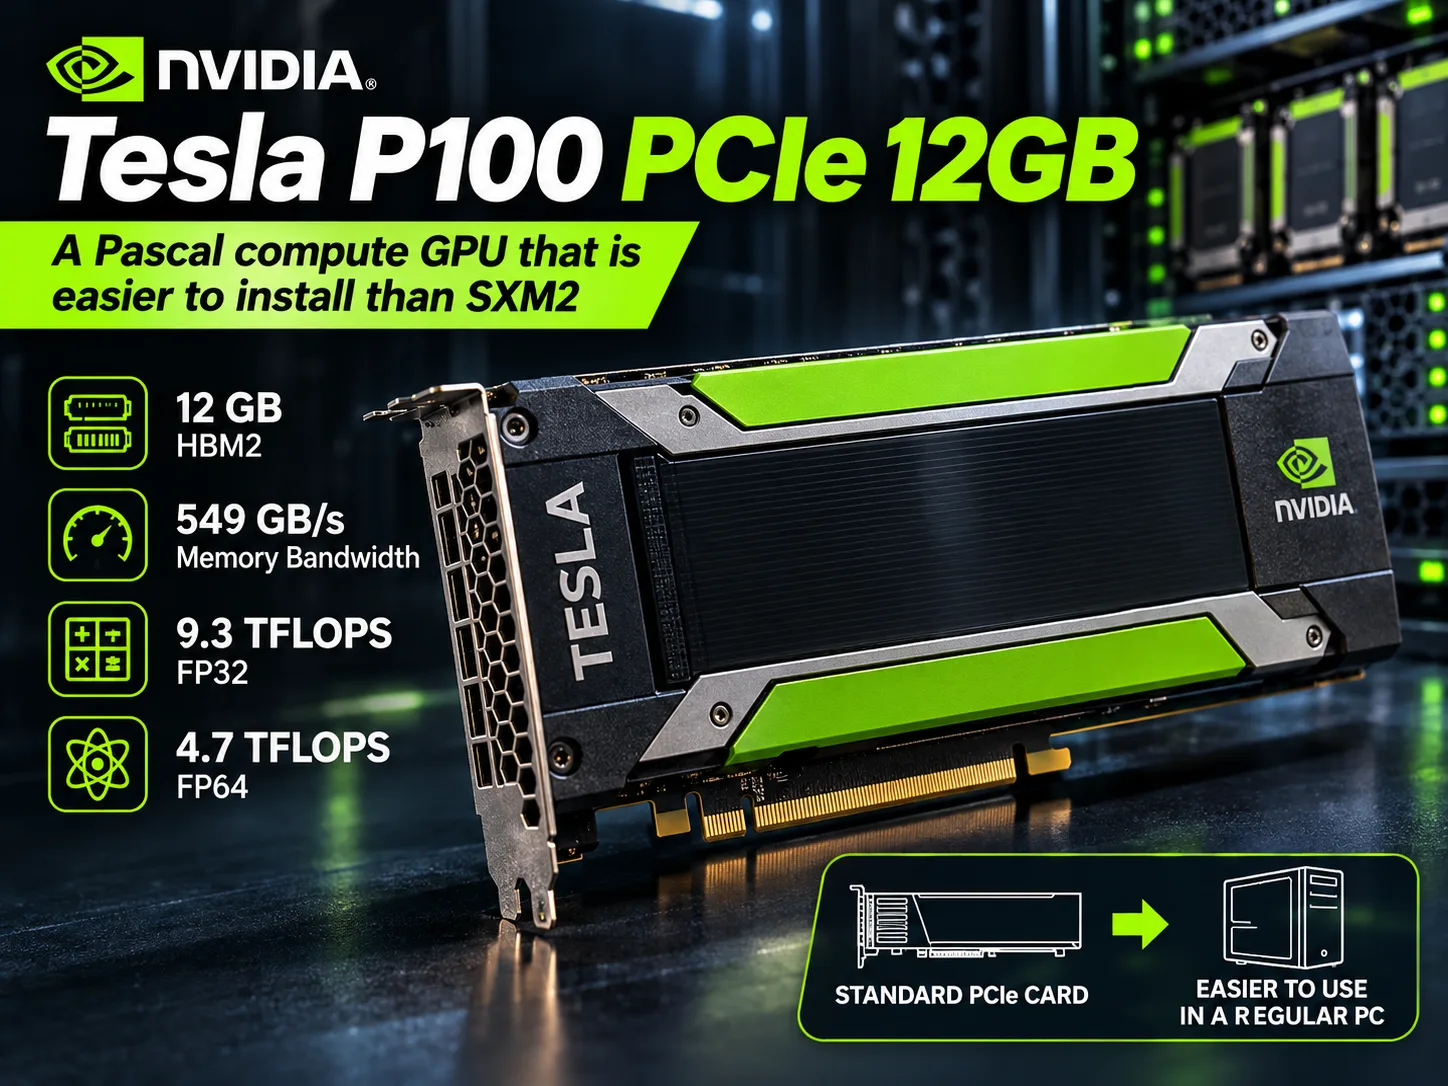
Tesla P100 PCIe 12 GB: uma calculadora FP64 por $80 com data de desligamento marcada
A Tesla P100 foi o primeiro acelerador da NVIDIA baseado na arquitetura Pascal e, em 2016-2017, era uma das principais placas para supercomputadores e treinamento de redes neurais. Na época, a versão de 12 GB para PCIe custava cerca de $4600. Hoje, essas placas saem de servidores desativados e são vendidas no eBay por $70-140, menos do que uma placa de vídeo gamer de entrada.
Ela é procurada pela precisão dupla e pela memória HBM2. Em FP64, a placa entrega 4,7 TFLOPS, mais do que a RTX 4090. A versão menor leva desvantagem na memória: um dos quatro stacks HBM2 está desativado, portanto a capacidade e a largura de banda são 25% menores que as da P100 de 16 GB. Todo o suporte de software ao Pascal termina junto com a ramificação de drivers R580, em meados de 2028.
Posição na linha e arquitetura
Todas as Tesla P100 são baseadas no GP100 - um die de 16 nm com área de 610 mm², montado em um substrato CoWoS junto com quatro stacks HBM2. Dos 3840 CUDA cores do chip completo, 3584 estão ativos na P100. A versão PCIe opera a 1190-1329 MHz, com TDP de 250 W.
A versão de 12 GB é a mesma placa, com um stack de memória desativado. O núcleo e os clocks não mudaram, portanto a capacidade computacional é igual à da versão superior.
| Modelo | Memória | Barramento | Largura de banda | FP64 | FP16 | TDP |
|---|---|---|---|---|---|---|
| Tesla P100 PCIe 12 GB | 12 GB HBM2 | 3072 bits | 549 GB/s | 4,7 TFLOPS | 18,7 TFLOPS | 250 W |
| Tesla P100 PCIe 16 GB | 16 GB HBM2 | 4096 bits | 732 GB/s | 4,7 TFLOPS | 18,7 TFLOPS | 250 W |
| Tesla P100 SXM2 | 16 GB HBM2 | 4096 bits | 732 GB/s | 5,3 TFLOPS | 21,2 TFLOPS | 300 W |
| Tesla P40 | 24 GB GDDR5 | 384 bits | 347 GB/s | 1/32 de FP32 | 1/64 de FP32 | 250 W |
O chip GP100 não chegou à linha GeForce. Seu parente mais próximo para estações de trabalho é a Quadro GP100, com saídas de vídeo. A GTX 1080 Ti e a Tesla P40 são baseadas em outro die, o GP102. O GP100 calcula FP64 à metade da velocidade de FP32 e FP16 ao dobro; no GP102, os dois modos são reduzidos quase a zero. Por outro lado, o GP100 (compute capability 6.0) não tem as instruções DP4A para produto escalar inteiro presentes no GP102. Para redes neurais quantizadas, isso acabou sendo mais importante do que parecia em 2016.
A P100 não tem Tensor Cores. Eles só apareceram em 2017, na Tesla V100 baseada na arquitetura Volta.
Desempenho
A placa não serve para jogos. Ela não tem saídas de vídeo, e entusiastas que usaram uma segunda placa para transmitir a imagem reclamam dos drivers de datacenter e não recomendam a P100 para jogos. Onde ela ainda funciona bem é em modelos de linguagem locais e cálculos de precisão dupla.
Tabela consolidada da comunidade do llama.cpp para CUDA (Llama 2 7B, Q4_0, sem Flash Attention):
| Acelerador | Memória | Processamento do prompt, tokens/s | Geração, tokens/s |
|---|---|---|---|
| RTX 3090 | 24 GB GDDR6X | 5174 | 158 |
| Tesla V100 | 32 GB HBM2 | 3043 | 129 |
| RTX 2080 Ti | 11 GB GDDR6 | 2890 | 107 |
| GTX 1080 Ti | 11 GB GDDR5X | 1084 | 62 |
| Tesla P100 PCIe 16 GB | 16 GB HBM2 | 761 | 58,4 |
| Tesla P40 | 24 GB GDDR5 | 1007 | 54,7 |
| Tesla T4 | 16 GB GDDR6 | 1219 | 46,4 |
A P100 gera texto no nível da GTX 1080 Ti e da P40. Ela processa o prompt 3,8 vezes mais lentamente que a RTX 2080 Ti e também fica atrás da própria P40. Com consultas curtas no chat, isso é tolerável, mas em documentos longos o modelo demora visivelmente para “ler” o texto antes de responder.
Um teste da ComputingForGeeks com uma versão recente do llama.cpp, em outubro de 2026, mostrou a mesma coisa. No Qwen3 8B em Q4_K_M, a P100 de 16 GB entregou 38,4 tokens/s, contra 47 da P40, embora a memória da P100 seja duas vezes mais rápida. A causa é a ausência de DP4A: no compute capability 6.0, os kernels quantizados do llama.cpp seguem o caminho lento.
Por isso, o barramento reduzido da versão de 12 GB quase não atrapalha em modelos de linguagem. No teste com Llama 2 7B, a P100 de 16 GB atinge cerca de 220 GB/s, menos de um terço da sua largura de banda máxima - ou seja, o limite está no processamento. Não há medições separadas da versão menor no llama.cpp, mas, em modelos pequenos, sua velocidade de geração deve ser próxima à da versão de 16 GB. O problema dos 12 GB é a capacidade: o gpt-oss-20b e modelos densos maiores que 14B não cabem nela.
Com FP64, a situação é inversa. A RTX 4090 tem cerca de 1,3 TFLOPS em precisão dupla, e a RTX 3090 tem dez vezes menos que a P100. As placas de servidor da geração seguinte são as únicas mais próximas em FP64: a V100 PCIe, com 7 TFLOPS, e a AMD Instinct MI50, com 6,6 TFLOPS. Em cálculos nos quais a FP64 é limitada pela memória, como métodos de malha e hidrodinâmica, a versão de 12 GB ficará até 25% atrás da versão superior.
Resultados em sistemas específicos
Como quase não há testes publicados especificamente para a versão de 12 GB, a tabela também inclui resultados do modelo de 16 GB com o mesmo chip.
| Sistema | Configuração | Versão da P100 | Teste | Resultado |
|---|---|---|---|---|
| Uniwide RB228H | 2× Xeon E5-2699 v4 | PCIe 12 GB | SPEC ACCEL OpenCL, base | 5,15 |
| Servidor de hospedagem da Database Mart | 2× Xeon E5-2660 v2, 128 GB DDR3 | PCIe 16 GB | Ollama, Llama 2 7B | 49,7 tokens/s |
| Nó alugado da vast.ai | n/d | PCIe 16 GB | llama.cpp, Qwen3 8B Q4_K_M | 38,4 tokens/s |
A diferença entre 49,7 e 38,4 tokens/s é explicada pelo modelo e pela quantização, não pelo servidor. Se o modelo couber inteiro na memória de vídeo, o processador quase não influencia a velocidade de geração, e até uma plataforma com Xeon E5 v2 de 2013 não limita a placa.
Em idle, a P100 fica em 28 W, enquanto a P40 fica em 11 W. Sob carga de LLM, o consumo de pico da P100 chega a 211 W.
Onde é encontrada, preços e disponibilidade
Não há dispositivos novos com a P100 à venda. Em sua época, a placa era oferecida como opção nos servidores Dell PowerEdge R730, R740, C4130 e C4140, Cisco UCS C240 M5 e C220 M5SX e HPE ProLiant. É de lá que ela chega ao mercado de usados, geralmente sem cabos.
| Variante | Estado | Preço |
|---|---|---|
| Tesla P100 PCIe 12 GB | usada, lotes grandes | $70-100 |
| Tesla P100 PCIe 12 GB | usada, com teste e devolução | $110-165 |
| Tesla P100 PCIe 16 GB | usada, lotes da China | $118-130 |
| Tesla P100 PCIe 16 GB | recondicionada, Amazon | cerca de $155 |
Para instalar a placa em um PC comum, será preciso comprar algumas coisas:
| O que é necessário | Para quê | Preço |
|---|---|---|
| Duto e ventoinha tipo turbina | o resfriamento é passivo | a partir de $20, mais a ventoinha |
| Adaptador para 8-pin EPS | conector de processador, não PCIe | cerca de $13 |
| Gráficos integrados ou uma segunda placa | não há saídas de vídeo | - |
A opção Above 4G Decoding deve estar ativada na BIOS. Não é possível instalar a P100 no mesmo sistema que uma placa Blackwell: elas precisam de módulos de kernel NVIDIA diferentes. No fim, uma P100 de 12 GB pronta para uso custa $110-150.
Concorrentes e alternativas
Tesla P100 PCIe 16 GB (cerca de $130-155). O chip é o mesmo, mas há 4 GB a mais de memória e a largura de banda é um terço maior. Os $40-60 adicionais permitem usar o gpt-oss-20b, modelos 14B com contexto normal e obter velocidade máxima em tarefas limitadas pela memória. A versão menor continua sendo mais vantajosa apenas para cálculos FP64 nos quais a capacidade não é importante: ela calcula na mesma velocidade e custa menos.
Tesla P40 24 GB (cerca de $300-350). Ela tem duas vezes mais memória e DP4A; modelos 32B em Q4 cabem inteiros e geram cerca de 12 tokens/s. Na prática, ela não tem FP16 nem FP64, portanto não serve para cálculos. Para modelos maiores que 14B, é mais útil que qualquer P100.
Tesla V100 PCIe 16 GB (cerca de $365). Ela tem Tensor Cores, processa o prompt de 3 a 4 vezes mais rápido e chega a 7 TFLOPS em FP64. O suporte terminará da mesma forma que no Pascal. Por três vezes mais dinheiro, você obtém uma placa consideravelmente mais rápida, mas com o mesmo tempo de vida.
GeForce RTX 3060 12 GB (cerca de $300-320 usada). A capacidade de memória é a mesma, mas funcionam a CUDA atual, o vLLM e as futuras versões do PyTorch. A placa tem saídas de vídeo e refrigeração convencional, com consumo de 170 W. Os Tensor Cores aceleram significativamente o processamento do prompt. A precisão dupla é simbólica. Se você precisa de uma placa de vídeo comum com software que continuará sendo suportado por vários anos, a RTX 3060 é mais vantajosa, embora custe três vezes mais.
Conclusão
Em modelos de linguagem, a P100 de 12 GB gera texto no nível da GTX 1080 Ti, mas processa o prompt de 3 a 4 vezes mais lentamente que a RTX 2080 Ti. Ela é suficiente para modelos 7-14B em quantização de 4 bits e para experimentar o Ollama e o llama.cpp em um servidor antigo. Modelos maiores que 14B não cabem nela, e prompts longos são processados lentamente. O vLLM não é suportado, o PyTorch anunciou o fim das compilações prontas para Pascal e os drivers deixarão de ser lançados em 2028. A isso se somam o consumo de 250 W e a ventoinha-turbina barulhenta.
Não vale pagar mais de $80 por essa placa. Se você precisa de modelos maiores que 14B, considere a P40; se precisa de software que funcione depois de 2028, escolha a RTX 3060 de 12 GB.
Para cálculos em precisão dupla, por $70-80, a P100 de 12 GB quase não tem concorrentes. Para redes neurais, é melhor pagar mais $50 e comprar a versão de 16 GB.
Comparação de GPU
Comparar Tesla P100 PCIe 12 GB com outros GPUs
Básico
Especificações de memória
Tela e multimídia
Desempenho Teórico
Diversos
Classificações
Comparado com outra GPU
Compartilhar nas redes sociais
Ou faça um link para nós
<a href="https://cputronic.com/index.php/pt/gpu/nvidia-tesla-p100-pcie-12-gb" target="_blank">NVIDIA Tesla P100 PCIe 12 GB</a>