NVIDIA Tesla V100 SXM2 32 GB
Tesla V100 SXM2 32GB: 신경망용 대용량 메모리, 하지만 복잡한 구성
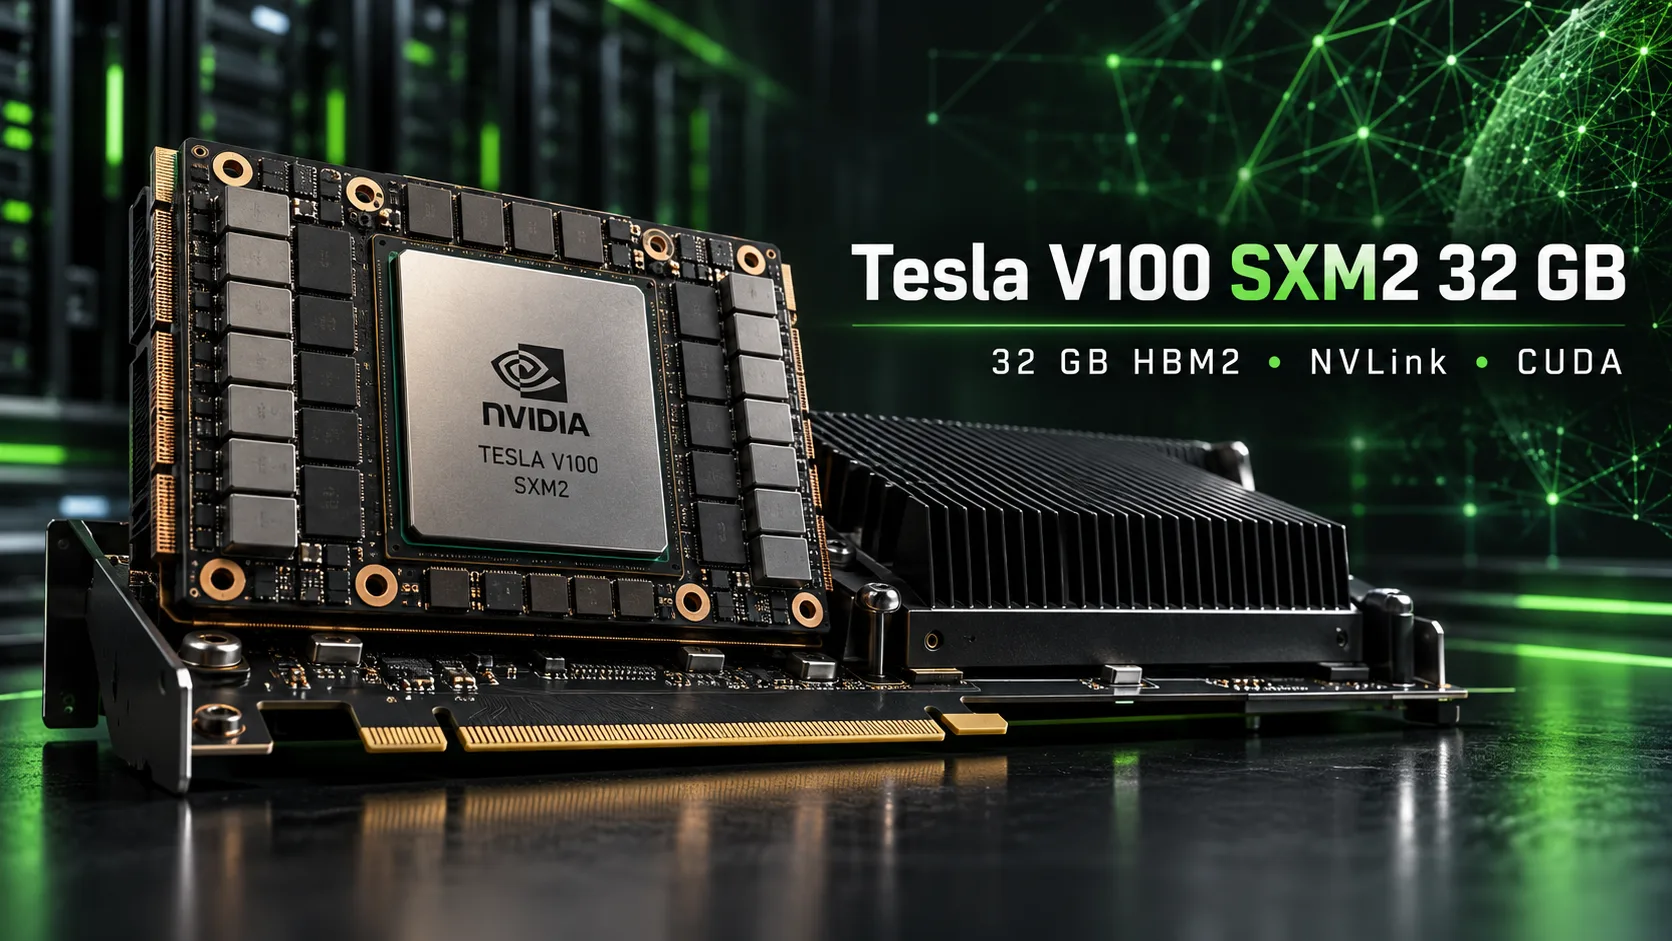
Tesla V100 SXM2 32GB는 32GB HBM2 메모리를 탑재한 서버용 연산 모듈로, 어댑터를 사용하면 일반 PC에 연결할 수 있다. 성능은 Tesla V100 PCIe에 가깝지만, NVLink를 통해 여러 가속기를 연결할 수 있다. 중고 시장에서는 이런 모듈이 완제품 PCIe 카드보다 저렴한 경우도 있지만, 실제 절약 금액은 어댑터와 냉각 장치 가격에 따라 달라진다.
NVIDIA는 2018년 3월 32GB 버전을 선보였다. 초기 가격은 약 $11 500이었다. 현재는 서버에서 퇴역한 뒤 판매되는 모듈이 대부분이며, 로컬 언어 모델에 24GB 이상의 비디오 메모리가 필요한 사용자와 애호가들의 관심을 끌고 있다.
그러나 SXM2는 PCIe 슬롯에 직접 장착할 수 없고, 별도의 전원 공급과 냉각이 필요하다. 소프트웨어 지원에도 제한이 있다. NVIDIA가 Volta 아키텍처용 드라이버 개발을 종료하고 있으며, CUDA 13은 더 이상 V100용 애플리케이션 컴파일을 지원하지 않는다.
제품군 내 위치
Tesla V100 SXM2는 5120개의 CUDA 코어와 640개의 텐서 코어를 갖춘 12nm GV100 다이 기반이다. HBM2 메모리는 4096비트 버스로 연결된다. PCIe 버전과 비교하면 클록, 소비전력, 인터페이스가 다르다.
| 모델 | 메모리 | 대역폭 | Boost | TDP | 인터페이스 |
|---|---|---|---|---|---|
| Tesla V100 PCIe 32GB | 32GB HBM2 | 900GB/s | 1380MHz | 250W | PCIe 3.0 x16 |
| Tesla V100 SXM2 16GB | 16GB HBM2 | 900GB/s | 1530MHz | 300W | SXM2, NVLink 2.0 |
| Tesla V100 SXM2 32GB | 32GB HBM2 | 900GB/s | 1530MHz | 300W | SXM2, NVLink 2.0 |
SXM2의 공식 사양상 성능은 FP32에서 15.7 TFLOPS, FP64에서 7.8 TFLOPS, FP16 텐서 코어에서 125 TFLOPS에 달한다.
6개의 NVLink 2.0 링크는 양방향 합산 최대 300GB/s의 대역폭을 제공한다. 이는 PCIe 3.0보다 훨씬 높은 수치지만, 두 GPU 사이의 실제 통신 속도는 두 GPU를 연결하는 링크 수에 따라 달라진다.
이 모듈은 NVIDIA DGX-1 서버 시스템과 AWS p3dn 클라우드 구성에 사용됐다. 중고 시장에서는 파트 번호가 699-2G503-0203-200 및 699-2G503-0204-200인 제품과 HPE P05912-001 서버용 버전을 찾아볼 수 있다.
일반 PC에 모듈 설치하기
SXM2-PCIe 어댑터. 단일 모듈용 보드는 약 $60-100에 판매된다. PCIe 3.0 x16에 연결하며, 보통 8핀 커넥터 2개를 통한 추가 전원이 필요하다. 구매 전에 어댑터가 V100 SXM2와 호환되는지, 전원 회로가 어떻게 구성되어 있는지 확인해야 한다.
일반적인 어댑터는 NVLink를 제공하지 않는다. 이 경우 V100은 독립적인 가속기로 작동하며, SXM2의 장점은 더 높은 클록과 더 높은 정격 전력 제한 정도로 줄어든다.
여러 모듈을 장착하는 보드. 두 개 또는 네 개의 V100을 연결하기 위해 NVLink 라인이 배선된 전용 보드가 출시되어 있다. 2모듈용 제품은 약 $300-500에 거래된다. 일부 설계에서는 PCIe 스위치와 전용 케이블을 통해 메인보드에 연결한다.
구매 전에 모듈 간 연결 구성을 확인해야 한다. SXM2 커넥터가 2개 있다고 해서 NVLink가 작동하는 것은 아니다.
냉각. V100 SXM2는 서버용 냉각 시스템을 전제로 설계됐으므로, 강한 풍량이 없는 일반 방열판만으로는 부족하다. TDP가 300W이므로 적합한 방열판을 선택하고, 방향성 있는 공기 흐름을 확보하며, 장시간 부하에서 온도를 확인해야 한다.
가정용 시스템에서는 덕트가 달린 별도 팬을 사용하며, 이 덕트를 3D 프린터로 제작하는 경우도 있다. nvidia-smi를 통해 전력 제한을 낮추면 발열과 소음을 줄일 수 있지만, 성능이 제한될 수 있다.
운영체제. 가정용 테스트 시스템에는 Linux가 더 적합하다. 관련 설명서와 드라이버, 특수 빌드를 찾기 쉽기 때문이다. Windows도 지원되며, V100 여러 개를 사용하는 일부 실험적 구성도 가능하지만 호환성은 별도로 확인해야 한다.
Linux에서는 NVIDIA 독점 드라이버 모듈을 설치하는 것이 중요하다. 560 브랜치부터는 기본적으로 오픈 커널 모듈이 제안되는데, 이 모듈은 Turing 및 그 이후 아키텍처만 지원한다. Volta에는 사용할 수 없다.
언어 모델에서의 성능
32GB 메모리를 탑재한 단일 모듈
토큰 생성 속도는 메모리 대역폭에 의해 제한되는 경우가 많다. SXM2와 PCIe의 대역폭은 모두 900GB/s이므로, 이런 작업에서 SXM2의 성능 우위는 대체로 크지 않다.
사용자 테스트에서는 V100 SXM2 32GB 한 장에서 Qwen3.6-27B를 여러 양자화 방식으로 llama.cpp에서 실행했다.
| 양자화 | 생성 속도, tok/s |
|---|---|
| Q4_K_M | 32.2 |
| Q5_K_M | 29.1 |
| Q6_K | 25.1 |
| Q8_0 | 22.8 |
테스트는 단일 스레드에서 128~2048토큰을 생성하는 방식으로 진행됐다. 이는 특정 구성에서 얻은 결과이며, 모든 V100에서 보장되는 속도는 아니다.
32GB 버전의 가장 큰 장점은 Qwen3.6-27B를 Q8_0으로 완전히 탑재할 수 있다는 점이다. 24GB 그래픽카드에서는 이 양자화 방식에 필요한 메모리가 부족하다.
다만 Q8_0 가중치는 사용 가능한 비디오 메모리 대부분을 차지한다. 긴 대화를 처리할 때는 KV 캐시에 더 많은 공간을 남길 수 있도록 Q4_K_M 또는 Q5_K_M을 선택하는 편이 좋다.
긴 컨텍스트와 최적화된 빌드
긴 컨텍스트에서는 성능이 눈에 띄게 떨어진다. 애호가들은 llama.cpp를 수정하고 MTP 방식의 추측 디코딩을 적용해 이러한 성능 저하를 줄이려 하고 있다.
공개된 테스트에서는 V100 SXM2 32GB 한 장에서 Qwen3.8-27B Q4_K_M을 다음과 같이 실행했다.
| llama.cpp 빌드 | 컨텍스트 1천, tok/s | 컨텍스트 128천, tok/s |
|---|---|---|
| 표준 | 36.0 | 16.5 |
| Volta용 패치 적용, MTP 제외 | 35.2 | 23.8 |
| 패치 및 MTP 적용 | 65.1 | 42.2 |
컨텍스트 128천 토큰에서 MTP를 적용한 최적화 빌드는 표준 빌드보다 2.6배 빨랐다. 하지만 이는 특정 구성에서 얻은 결과이며, 모델과 요청 내용, 추측 디코딩의 효율에 따라 달라진다.
프롬프트 캐싱은 다단계 에이전트 세션도 가속한다. 같은 실험에서는 이미 처리한 대화 기록을 재사용해 한 턴의 처리 시간이 22.94초에서 3.08초로 줄었다.
여러 모듈과 NVLink
여러 GPU를 사용하는 시스템에서는 SXM2의 장점이 더욱 분명해진다. NVLink는 가속기 간 데이터 교환을 가속하고 텐서 병렬화를 더 효율적으로 사용할 수 있게 한다.
텐서 병렬화는 PCIe를 통해서도 가능하지만, GPU 간 통신량이 많으면 속도가 제한될 수 있다.
| 구성 | 작업 | 결과 |
|---|---|---|
| 2× V100 SXM2 32GB, NVLink, vLLM 0.6.4 | Qwen2.5-32B, 동시 요청 32개 | 총 206 tok/s |
| 4× V100 SXM2 32GB, llama.cpp 포크 | Qwen3.8-Flash-Next 125B, 컨텍스트 16천 | 42.2 tok/s |
| 4× V100 SXM2 32GB, 동일 포크 | 동일 모델, 컨텍스트 256천 | 21.8 tok/s |
첫 번째 테스트에서는 단일 대화의 성능이 아니라 32개 요청을 처리하는 총속도를 측정했다.
V100 4개 구성에서는 주요 파라미터 1250억 개와 토큰당 약 60억 개의 활성 파라미터를 갖춘 MoE 모델 Qwen3.8-Flash-Next를 사용했다. 약 156GiB 용량의 양자화 버전은 128GiB의 비디오 메모리에 전부 들어가지 않았다. 데이터 일부는 서버의 시스템 메모리에 저장됐다.
이 실험은 CUDA 12.8과 수정된 llama.cpp를 사용하는 Windows Server 2022에서 진행됐다. 하드웨어의 가능성을 보여주는 결과지만, 그래픽카드 한 장에서 모델을 표준 방식으로 실행하는 것보다 훨씬 복잡한 설정이 필요하다.
Level1Techs의 비교에서 Radeon AI PRO R9700 32GB 두 장은 llama.cpp에서 V100 두 장보다 최대 총성능이 32% 높았다. 그러나 텐서 병렬화를 사용하는 vLLM에서는 V100 두 장이 206 tok/s를 달성해, 해당 실험에서 R9700의 최고 결과를 58% 웃돌았다.
이 비교는 특정 소프트웨어 버전과 Qwen2.5-32B 모델, 짧은 요청의 배치 처리에 해당한다. 이 비율을 다른 모델이나 긴 컨텍스트에 그대로 적용할 수는 없다.
게임과 FP64 연산
Tesla V100은 연산용으로 설계됐지만, 애호가들은 SXM2 버전에서 게임도 실행했다. 한 사용자 테스트에서 V100 SXM2 16GB는 2560×1080 해상도와 높음 설정에서 스케일링과 프레임 생성 없이 Cyberpunk 2077을 약 78 FPS로 구동했다.
그러나 이 모듈에는 비디오 출력, 하드웨어 레이 트레이싱, DLSS 지원이 없다. 게임을 실행하려면 시스템을 추가로 구성해야 하며, 32GB HBM2는 비슷한 성능의 게이밍 그래픽카드에 비해 실질적인 이점을 제공하지 않는다.
배정밀도 연산에서 V100은 7.8 TFLOPS FP64에 도달하며, 이는 RTX 4090보다 약 6배 높은 수치다. 따라서 높은 FP64 성능이 필요한 과학적 계산에서는 이 구형 가속기가 여전히 관심을 받을 만하다.
소프트웨어 지원
NVIDIA는 Volta 아키텍처 지원을 R580 드라이버 브랜치로 제한했다. 이 브랜치는 2028년 6월까지 유지보수가 예정되어 있지만, 이후 브랜치는 V100을 대상으로 하지 않는다.
CUDA 13에서는 Volta용 애플리케이션 컴파일과 라이브러리 지원이 제외됐다. 호환되는 마지막 CUDA Toolkit 제품군은 12.x다. 다만 R580 드라이버는 이전 CUDA 버전으로 빌드된 애플리케이션과의 호환성을 유지한다.
이 문제는 신경망용 소프트웨어에도 점차 영향을 미치고 있다. 새로운 사전 빌드에는 sm_70용 코드가 포함되지 않을 수 있으므로, 사용자는 호환되는 버전을 계속 사용하거나 프로그램을 직접 컴파일해야 한다.
현재 V100은 llama.cpp, 일부 PyTorch 빌드, Volta에 맞게 수정된 vLLM 버전, Volta용 실험적 프로젝트와 함께 사용할 수 있다. 그러나 최신 GPU를 위한 최적화가 이 세대에서 항상 제공되는 것은 아니다.
BF16과 FP8을 하드웨어에서 지원하지 않는 점도 모델과 연산 형식의 선택을 제한한다.
V100 SXM2 32GB의 가격
2018년 Microway는 V100 SXM2 32GB의 가격을 $11 458로 제시했다. 현재는 새로운 모듈이 생산되지 않으며, 중고 시장 가격은 퇴역 서버 장비의 공급 상황에 크게 좌우된다.
2026년 10월 eBay에서는 다음과 같은 매물을 확인할 수 있다.
| 장비 | 가격 |
|---|---|
| Tesla V100 SXM2 32GB, 모듈 단품 | $658~839 |
| Tesla V100 SXM2 16GB, 모듈 단품 | $150~200 |
| Tesla V100 PCIe 32GB | $650~900 |
| SXM2-PCIe 어댑터 | $60~100 |
| NVLink 지원 SXM2 2개용 보드 | 약 $300~500 |
| SXM2용 방열판 및 팬 | 약 $45~100 |
이는 개별 매물의 가격이며, 실제 판매 가격의 평균이 아니다. 배송비, 세금, 부품 호환성에 따라 최종 비용은 크게 달라질 수 있다.
SXM2 32GB를 $658에 구매하고 $60짜리 어댑터와 $60짜리 냉각 장치를 추가하면 배송비를 제외하고 약 $778이 된다. 이 가격에서는 완제품 V100 PCIe 32GB에 비해 절약된다고 보장하기 어렵다.
반대로 $350-400에 모듈을 구할 수 있다면 전체 구성 비용은 약 $470-560이 되며, PCIe 버전에 비해 뚜렷한 가격 우위를 유지할 수 있다.
모듈 2개를 사용하는 시스템에서는 계산이 더 복잡해진다. NVLink 보드, 추가 케이블, 냉각 장치와 전원 공급 장치로 인해 예산이 크게 늘어날 수 있다.
경쟁 제품과 대안
Tesla V100 PCIe 32GB. 동일한 메모리 용량과 대역폭을 제공하는 가장 가까운 대안이다. 카드를 PCIe에 직접 장착할 수 있지만, 수동 냉각 방식은 여전히 방향성 있는 공기 흐름을 필요로 한다. 전체 비용이 비슷하다면 단일 가속기용으로는 PCIe 버전이 더 적합하다.
Tesla V100 SXM2 16GB. 32GB 버전보다 훨씬 저렴하다. 어댑터와 냉각 장치를 포함한 구성 비용은 약 $260-350이 될 수 있다. 소형 및 중형 양자화 모델에 적합하지만, 16GB 메모리는 모델 선택과 컨텍스트 길이를 제한한다. NVLink를 사용하는 모듈 2개는 총 32GB의 메모리를 제공하지만, 모든 애플리케이션에서 하나의 통합 주소 공간으로 작동하는 것은 아니다.
GeForce RTX 3090 24GB. 하드웨어 BF16 지원, 최신 CUDA 라이브러리, Windows에서의 정상적인 작동을 제공하는 더 범용적인 그래픽카드다. 프롬프트 처리의 일부 작업에서는 V100보다 눈에 띄게 빠르다. eBay에서는 약 $1200부터 매물을 찾을 수 있지만, 10월 말 기준 대부분의 매물 가격 하한은 약 $1600이다. 대형 모델을 실행할 때의 가장 큰 단점은 32GB가 아닌 24GB의 메모리다.
AMD Instinct MI50 32GB. 32GB HBM2와 약 1TB/s의 대역폭을 제공하는 대안이다. eBay에서는 약 $650부터 매물이 시작되지만, 다른 판매처의 가격은 다를 수 있다. 가장 큰 문제는 오래된 ROCm 지원과 더 복잡한 연산 소프트웨어 설정이다. llama.cpp에서는 Vulkan을 포함한 호환 빌드를 사용할 수 있지만, CUDA 프로그램은 별도로 포팅하지 않으면 작동하지 않는다.
구매할 가치가 있는가
Tesla V100 SXM2 32GB는 24GB 이상의 비디오 메모리를 요구하는 로컬 언어 모델을 실행하고 싶으며, 냉각 시스템을 직접 구성할 의향이 있는 사용자에게 매력적이다.
모듈 가격이 $350-400 이하라면 추가 부품 비용을 고려해도 V100 PCIe 32GB보다 구매가 유리할 수 있다. 완제품 구성 가격이 PCIe 카드 가격에 가까워지면 SXM2의 이점은 사실상 사라진다.
여러 가속기를 사용할 계획이라면 NVLink 보드가 더 매력적이다. GPU 간 데이터 교환을 가속하고 텐서 병렬화 실험에 적합하지만, 비용이 많이 들고 설정도 복잡하다.
V100 SXM2의 가장 큰 제약은 냉각, 최대 300W의 소비전력, 최신 연산 형식의 부재, 점차 축소되는 소프트웨어 지원이다. 로컬 LLM, 과학적 계산, CUDA 실험용으로는 아직 사용할 수 있다.
복잡한 구성 없이 그래픽카드 한 장을 사용해야 한다면 V100 PCIe 32GB를 선택하는 편이 낫다. SXM2는 상당한 비용 절감이 가능하거나 NVLink가 필요한 경우에만 의미가 있다.
GPU 비교
Tesla V100 SXM2 32 GB을 다른 GPUs와 비교
기초적인
메모리 사양
디스플레이 및 미디어
이론적 성능
여러 가지 잡다한
벤치마크
다른 GPU와 비교
관련 GPU 비교


소셜 미디어에서 공유하기
또는 링크로 소개하기
<a href="https://cputronic.com/index.php/ko/gpu/nvidia-tesla-v100-sxm2-32-gb" target="_blank">NVIDIA Tesla V100 SXM2 32 GB</a>