NVIDIA Tesla V100 SXM3 32 GB

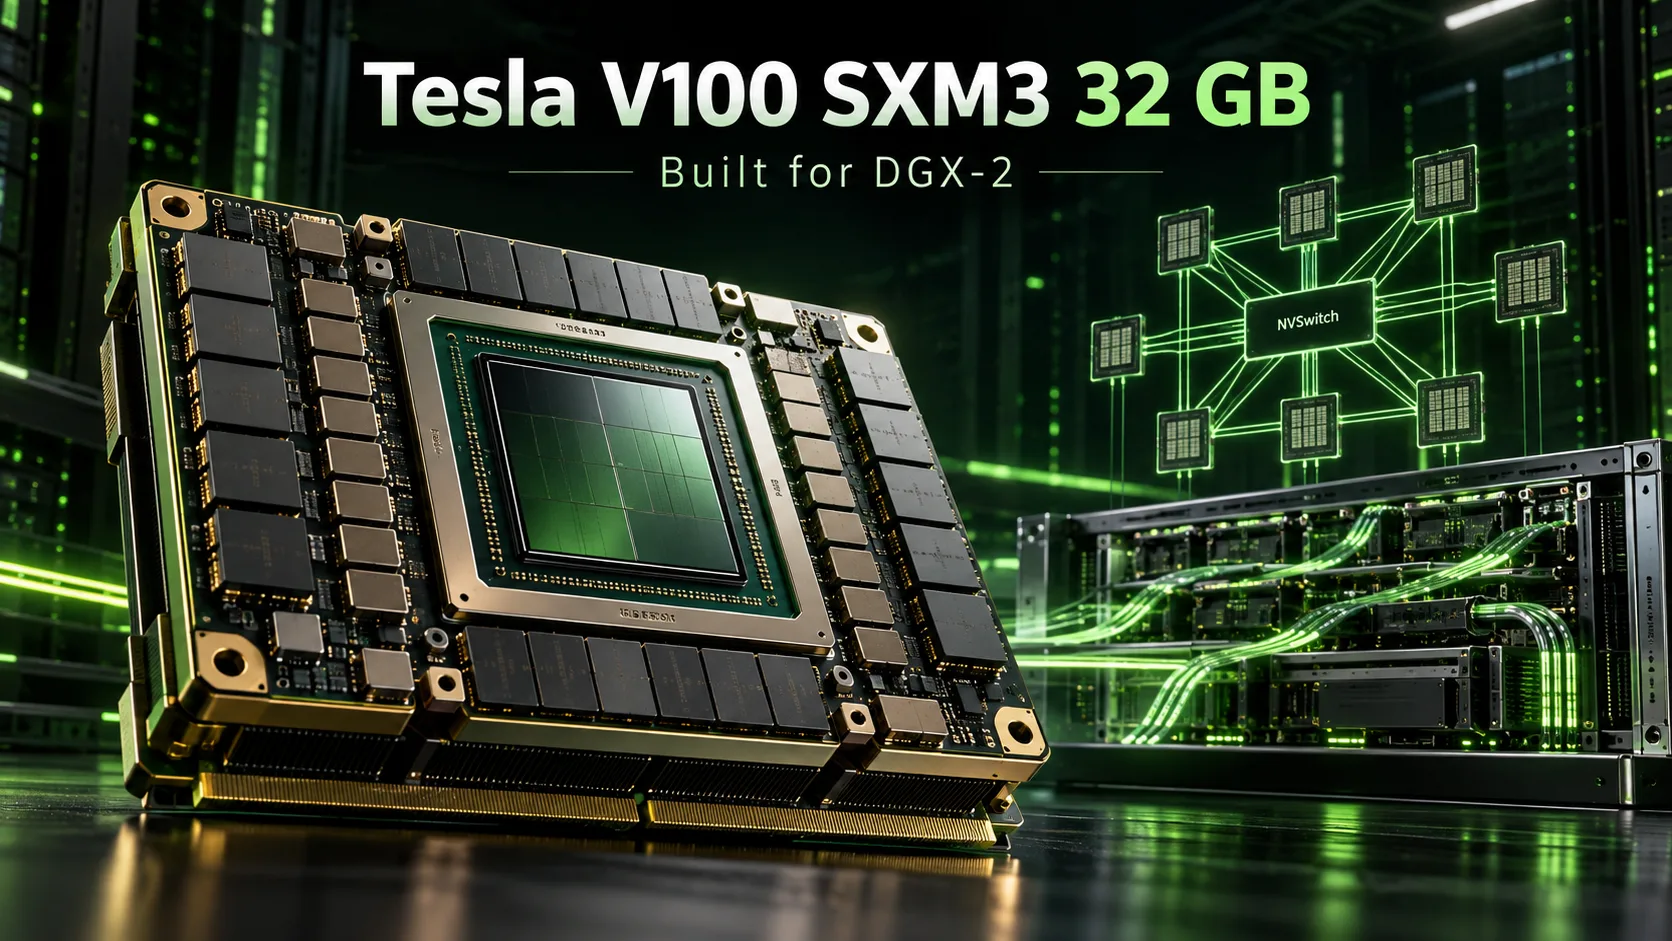
Tesla V100 SXM3 32 GB:SXM2より高性能だが、はるかに扱いが難しい
Tesla V100 SXM3 32 GBは、スーパーコンピューターDGX-2およびHGX-2プラットフォームのサーバー向けに設計された、NVIDIAの演算モジュールだ。NVIDIAは2018年3月にDGX-2を発表した。その中核には、NVSwitchで相互接続されたVoltaアーキテクチャのアクセラレーター16基が搭載されていた。従来のV100 SXM2と比べ、新バージョンでは動作周波数、メモリ帯域幅、消費電力上限が引き上げられ、上限は350 Wとなった。
SXM3はスペックではSXM2を上回るが、自作構成には大幅に不向きだ。このモジュールは専用コネクターを使用し、互換性のある電源と冷却が必要になる。また、サーバープラットフォーム以外での動作実績はほとんど確認されていない。仮にSXM3を一般的なコンピューターに接続できたとしても、わずかな性能差では、そのためのコストを正当化できない可能性が高い。
製品ラインアップにおける位置付け
| モデル | メモリ | 帯域幅 | ブースト | 消費電力 |
|---|---|---|---|---|
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 900 GB/s | 1380 MHz | 250 W |
| Tesla V100 SXM2 32 GB | 32 GB HBM2 | 900 GB/s | 1530 MHz | 300 W |
| Tesla V100 SXM3 32 GB | 32 GB HBM2 | 981 GB/s | 1597 MHz | 350 W |
| Tesla V100 SXM3 32 GB H | 32 GB HBM2 | 1134 GB/s | 1702 MHz | 450 W |
4つのバージョンはいずれも、5120基のCUDAコアと640基のTensorコアを備えた同じGV100ダイを採用している。違いは、動作周波数、電力設定、接続方式にある。
標準のSXM3は、FP32で約16.4 TFLOPS、FP64で8.2 TFLOPSに達する。メモリ帯域幅はSXM2より9%高く、GPUの動作周波数は約4%引き上げられている。これらの違いにより、SXM3は演算処理やメモリ速度がボトルネックになるタスクで優位に立つが、実際の性能向上幅は負荷によって異なる。
DGX-2H向けに、NVIDIAはより高性能なSXM3-Hも用意した。消費電力上限は450 Wに引き上げられ、メモリ帯域幅は1134 GB/sに達する。これはSXM仕様のV100としては最も高性能なバージョンだ。
DGX-2とNVSwitch
DGX-2の最大の新要素は、GPUの動作周波数の向上ではなく、GPUを相互接続する方式だった。
DGX-1では、8基のSXM2アクセラレーターがNVLinkを介して直接接続されていた。このトポロジーでは、個々のGPUペア間でのデータ交換が制限されていた。DGX-2では、16基のSXM3モジュールを12基のNVSwitchに接続し、すべてのアクセラレーター間で高速通信を可能にした。
システム全体で512 GBのHBM2メモリを備えていた。各GPUは他のGPUのメモリにもアクセスできたが、これによって16基のアクセラレーターが、共有ローカルバッファーを持つ1基のGPUになるわけではない。リモートメモリへのアクセス遅延は依然として大きく、アプリケーション側では分散コンピューティングへの対応が必要だった。
システムの2つの半分の間を結ぶインターコネクト帯域幅は、2.4 TB/sに達した。大規模なニューラルネットワークの学習では、個々のモジュールの動作周波数がわずかに向上することよりも、こちらのほうが重要だった。
DGX-2はTensorコアで約2 PFLOPSを実現し、最大10 kWを消費した。発売時の価格は$399 000だった。NVIDIAはNVSwitchを採用したアーキテクチャを、その後のDGX世代でも発展させ、DGX A100などに引き継いでいる。
現代的なタスクにおける性能
現代の言語モデルでV100 SXM3を独立して検証したテストは、ほとんど存在しない。利用可能な結果の大半はSXM2またはPCIe版で得られたものなので、テキスト生成におけるSXM3の優位性を正確に判断することは、現時点ではできない。
目安として、Tesla V100 SXM2 32 GBは、llama.cppを使用し、Qwen3.6-27BをQ4_K_M形式で生成した場合、約32トークン/秒を示す。これは複数GPUで構成したシステムではなく、1枚のGPUによる結果だ。
SXM3はメモリ帯域幅が9%大きいため、理論上は生成処理でより高速になる可能性がある。ただし、この割合をそのままトークン出力速度に当てはめるのは正しくない。結果には、量子化、コンテキストサイズ、ソフトウェアエンジン、モデルの特性が影響する。
FP32およびFP64のタスクでも、動作周波数の向上による優位性が得られる。しかし、Voltaアーキテクチャは、対応する演算フォーマットの種類では新しいアクセラレーターに劣る。
主なソフトウェア上の制限は以下のとおり。
- CUDA: 演算アーキテクチャsm_70はCUDA 12.9までサポートされる。CUDA 13以降、新しいGPUカーネルをVolta向けにコンパイルすることはできない。
- ドライバー: R580は、VoltaをサポートするNVIDIAの最後のドライバーブランチだ。
- BF16: ハードウェアサポートがなく、最新のニューラルネットワーク学習ツールとの互換性が制限される。
- FlashAttention 2: 公式実装はVoltaをサポートしていない。そのため、別のアテンション機構を使用する必要がある。
V100は現在でもローカルLLMを動作させられるが、新しいモデルやライブラリを実行するには、特別なビルドが必要になる場合がある。
SXM3を一般的なコンピューターで使用できるか
PCIeカードとは異なり、SXM3モジュールはマザーボードのスロットに直接取り付けることができない。対応するコネクター、電源システム、冷却機構を備えた専用サーバーボードを前提としている。
中古市場では、価格が約$200-300のSXM3 - PCIe変換アダプターの出品が見られる。しかし、その一部にはSXM2に該当する部品番号が記載されている。本物のSXM3モジュールが、そのような変換アダプターで安定動作することを裏付ける独立した情報は不足している。
購入前には、以下の点を確認する必要がある。
- ボードがSXM2ではなく、SXM3をサポートしているか。
- 電源システムが最大350 Wの負荷に耐えられるか。
- モジュールをどのように冷却するのか。
- GPUがNVIDIAドライバーで認識され、長時間の負荷テストを通過するか。
ボードの通常の写真や、販売者による互換性の主張だけでは不十分だ。nvidia-smiの結果、CUDAテスト、そしてV100 SXM3そのものを使った安定動作の確認を得ることが望ましい。
DGX-2やHGX-2の構成では、こうした問題はない。しかし、時代遅れになったアクセラレーターを数基手に入れるためにサーバー全体を購入するのは、正当化が難しい。DGX-2は大規模な電源・冷却インフラを前提としており、電力効率もA100や、それ以降のGPUを搭載した現代的なシステムに劣る。
代替製品
Tesla V100 SXM2 32 GB。 同じメモリ容量を持つ最も近い代替製品だ。中古市場では約$450-700で販売されていた例があるが、現在の出品価格は大幅に高い場合がある。SXM2向けには、PCIeへの変換アダプターや、冷却機構を備えた改造済みカードが存在する。ただし、変換アダプターの価格と改造の品質を考慮する必要がある。
Tesla V100 PCIe 32 GB。 PCIe対応サーバー向けとしては、より扱いやすい選択肢だ。成立済みの取引価格を基準にすると、目安は約$650-850だが、2026年秋時点では多くの出品が$850から始まっている。このカードは動作周波数とメモリ帯域幅でSXM3に劣る一方、専用のSXMボードを必要としない。それでも、適切な電源と強制冷却は必要になる。
まとめ
Tesla V100 SXM3 32 GBは、動作周波数とメモリ帯域幅でSXM2を上回るが、接続の難しさを考えると、その優位性はほぼ失われてしまう。
DGX-2やHGX-2サーバーの所有者にとっては、依然として有用な予備部品だ。自作構成では、変換アダプター、電源、冷却の互換性を検証する必要がある実験用途に限って興味深い製品となる。
ローカルニューラルネットワーク向けに32 GBのV100が必要なら、実績のある変換アダプターを使うSXM2か、完成品のPCIe版を選ぶほうが合理的だ。SXM3を購入するのは、互換性のあるサーバープラットフォーム、または接続まで含めて動作確認済みのセットがある場合に限るべきだ。
GPUの比較
Tesla V100 SXM3 32 GBを他のGPUsと比較
基本
メモリ仕様
ディスプレイとメディア
理論上の性能
その他
ベンチマーク
他のGPUとの比較
ソーシャルメディアで共有する
または当サイトへのリンクを追加
<a href="https://cputronic.com/index.php/ja/gpu/nvidia-tesla-v100-sxm3-32-gb" target="_blank">NVIDIA Tesla V100 SXM3 32 GB</a>