NVIDIA Tesla V100 SXM2 32 GB

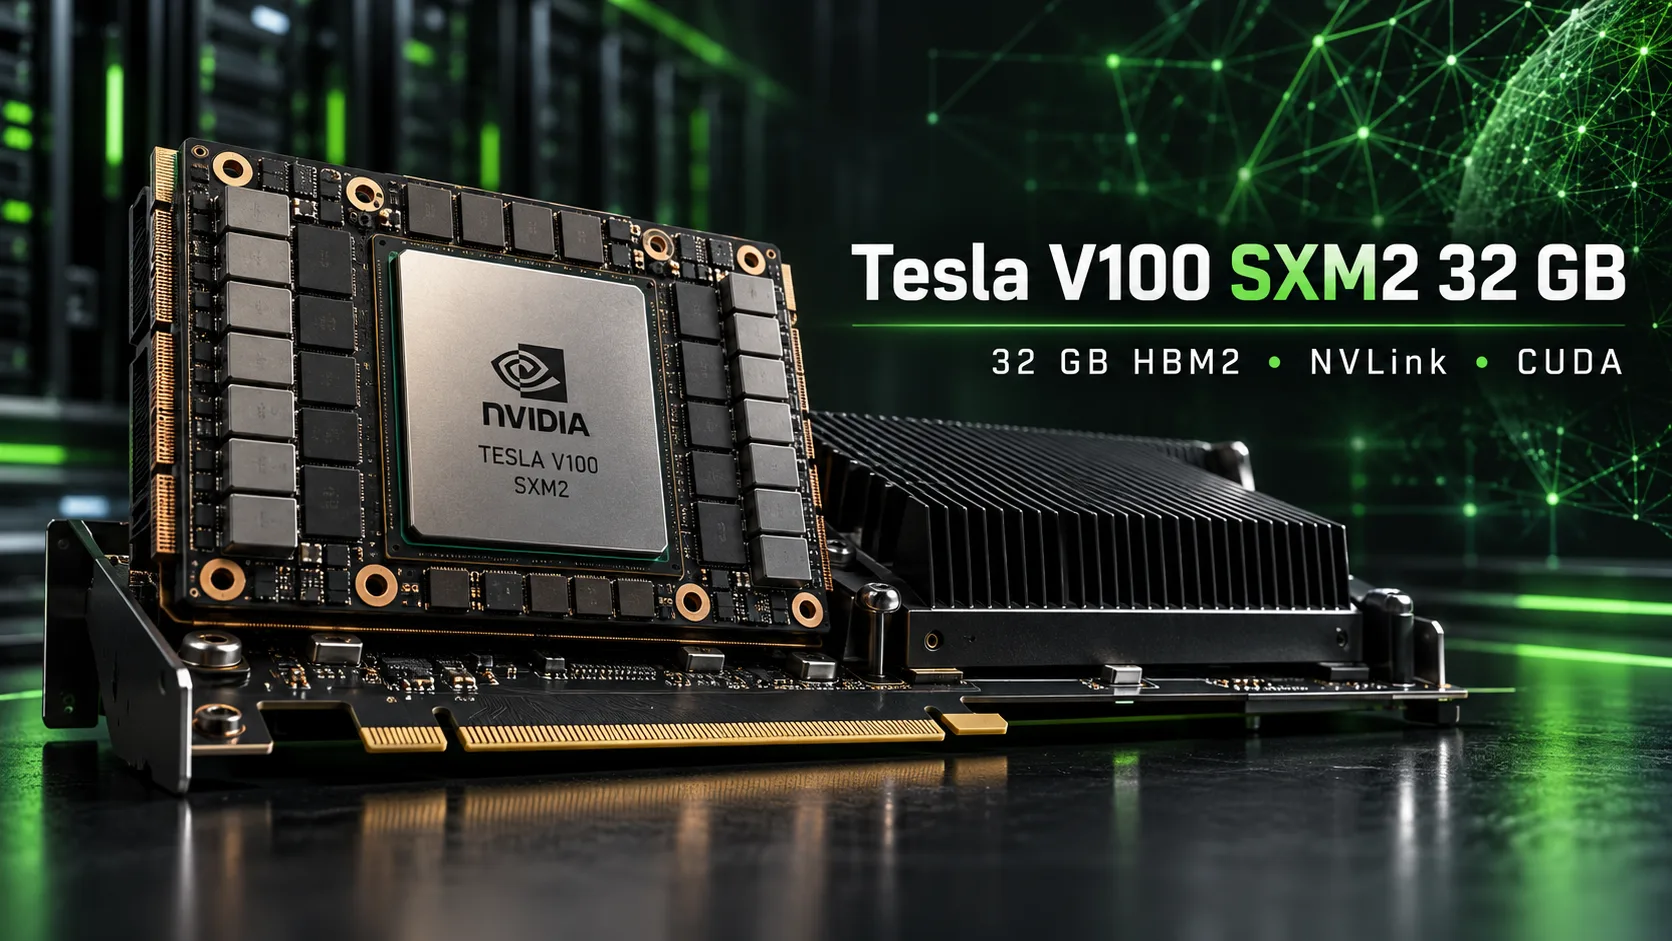
Tesla V100 SXM2 32 GB:ニューラルネットワークには大容量メモリ、ただし構築は複雑
Tesla V100 SXM2 32 GBは、32 GBのHBM2メモリを搭載したサーバー向け演算モジュールで、アダプターを使えば一般的なPCにも接続できる。性能はTesla V100 PCIeに近いが、NVLinkによって複数のアクセラレーターを接続できる。中古市場では、完成品のPCIeカードより安いこともあるが、実際の節約額はアダプターと冷却装置の価格に左右される。
NVIDIAは2018年3月に32 GB版を発表した。初期価格は約$11 500だった。現在は、廃棄されたサーバーから取り外されたモジュールが販売されており、24 GBを超えるビデオメモリをローカル言語モデルに必要とするエンスージアストの注目を集めている。
しかし、SXM2はPCIeスロットに直接装着できず、別途電源と冷却が必要になる。もう一つの制限はソフトウェアサポートに関するものだ。NVIDIAはVoltaアーキテクチャー向けドライバーの開発を終了しつつあり、CUDA 13ではV100向けアプリケーションのコンパイルがサポートされなくなった。
製品ラインアップにおける位置付け
Tesla V100 SXM2は、5120基のCUDAコアと640基のテンソルコアを備えた12 nmのGV100ダイを採用している。HBM2メモリは4096ビットのバスで接続される。PCIe版とは、動作周波数、消費電力、インターフェースが異なる。
| モデル | メモリ | 帯域幅 | Boost | TDP | インターフェース |
|---|---|---|---|---|---|
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | PCIe 3.0 x16 |
| Tesla V100 SXM2 16 GB | 16 GB HBM2 | 900 GB/s | 1530 MHz | 300 W | SXM2、NVLink 2.0 |
| Tesla V100 SXM2 32 GB | 32 GB HBM2 | 900 GB/s | 1530 MHz | 300 W | SXM2、NVLink 2.0 |
SXM2の公称性能は、FP32で15.7 TFLOPS、FP64で7.8 TFLOPS、FP16テンソルコアで125 TFLOPSに達する。
6本のNVLink 2.0リンクにより、合計で最大300 GB/sの双方向帯域幅を実現する。これはPCIe 3.0を大きく上回るが、2基のGPU間で実際にどれだけ高速に通信できるかは、両者を接続するリンク数によって異なる。
これらのモジュールは、NVIDIA DGX-1のサーバーシステムや、AWS p3dnのクラウド構成で使用されていた。中古市場では、パートナンバー699-2G503-0203-200および699-2G503-0204-200の製品のほか、サーバー向けのHPE P05912-001も見つかる。
モジュールを一般的なPCに取り付ける方法
SXM2-PCIeアダプター。 1モジュール用のボードは、およそ$60~100で販売されている。PCIe 3.0 x16に接続し、通常は2個の8ピンコネクターから追加の電力を供給する必要がある。購入前に、アダプターがV100 SXM2に対応しているか、また電源回路の構成を確認する必要がある。
一般的なアダプターではNVLinkを利用できない。この場合、V100は単独のアクセラレーターとして動作し、SXM2の利点は高い動作周波数と公称電力上限に限られる。
複数モジュール用ボード。 2基または4基のV100を接続するため、NVLinkの配線を備えた専用ボードが用意されている。2モジュール用の製品は、およそ$300~500で見つかる。一部の構成では、マザーボードとの接続にPCIeスイッチと専用ケーブルを使用する。
購入前には、モジュール間の接続構成を確認しなければならない。SXM2コネクターが2個あるだけでは、NVLinkが動作するとは限らない。
冷却。 V100 SXM2はサーバー向けの冷却システムを前提としているため、強力なエアフローなしで通常のヒートシンクだけを使用することはできない。TDPは300 Wなので、ヒートシンクを適切に選び、空気を一定方向に流し、長時間負荷時の温度を確認する必要がある。
自作システムでは、シュラウド付きの個別ファンが使われる。シュラウドは3Dプリンターで製作されることもある。nvidia-smiで電力上限を下げれば発熱と騒音を抑えられるが、性能が制限される可能性がある。
オペレーティングシステム。 自宅用のテスト環境ではLinuxのほうが適している。手順、ドライバー、専用ビルドを見つけやすいためだ。Windowsもサポートされており、複数のV100を使用する実験的な構成も一部で動作するが、互換性は個別に確認する必要がある。
Linuxでは、NVIDIAのプロプライエタリなドライバーモジュールをインストールすることが重要になる。560番台以降のブランチでは、デフォルトでオープンなカーネルモジュールが選択されるが、これはTuring以降のアーキテクチャーのみをサポートしている。Voltaには適していない。
言語モデルにおける性能
32 GBメモリの単一モジュール
トークン生成では、ビデオメモリの帯域幅が速度を制限することが多い。SXM2とPCIeの帯域幅は同じ900 GB/sなので、このような処理でのSXM2の優位性は通常それほど大きくない。
ユーザーテストでは、1基のV100 SXM2 32 GB上で、異なる量子化方式のQwen3.6-27Bをllama.cppで実行した。
| 量子化 | 生成速度、トークン/秒 |
|---|---|
| Q4_K_M | 32.2 |
| Q5_K_M | 29.1 |
| Q6_K | 25.1 |
| Q8_0 | 22.8 |
テストは1スレッドで、128~2048トークンを生成して実施された。これは特定の構成で得られた結果であり、すべてのV100で保証される速度ではない。
32 GB版の最大の利点は、Qwen3.6-27BをQ8_0で完全に配置できることだ。この量子化方式では、24 GBのビデオカードではメモリが足りない。
ただし、Q8_0の重みは利用可能なビデオメモリのほぼ全容量を占有する。長い対話では、KVキャッシュ用により多くの空き容量を残せるQ4_K_MまたはQ5_K_Mを選ぶほうがよい。
長いコンテキストと最適化ビルド
長いコンテキストでは、性能が大きく低下する。エンスージアストは、llama.cppの変更やMTPによる投機的デコーディングによって、この低下を抑えようとしている。
公開されたテストでは、1基のV100 SXM2 32 GB上でQwen3.8-27B Q4_K_Mを実行し、次の結果が得られた。
| llama.cppのビルド | コンテキスト1千、トークン/秒 | コンテキスト128千、トークン/秒 |
|---|---|---|
| 標準 | 36.0 | 16.5 |
| Volta向けパッチあり、MTPなし | 35.2 | 23.8 |
| パッチおよびMTPあり | 65.1 | 42.2 |
コンテキスト長が128千トークンの場合、MTPを使用する最適化ビルドは標準ビルドの2.6倍高速だった。ただし、これは特別な構成で得られた結果であり、モデル、リクエスト、投機的デコーディングの効率に左右される。
プロンプトのキャッシュも、多段階のエージェントセッションを高速化する。同じ実験では、すでに処理した履歴を再利用することで、1ターンの処理時間が22.94秒から3.08秒に短縮された。
複数モジュールとNVLink
複数のGPUを使用するシステムでは、SXM2の利点がより明確になる。NVLinkはアクセラレーター間のデータ交換を高速化し、テンソル並列をより効率的に利用できるようにする。
テンソル並列はPCIe経由でも可能だが、GPU間で大量のデータを交換すると速度が制限される場合がある。
| 構成 | タスク | 結果 |
|---|---|---|
| 2× V100 SXM2 32 GB、NVLink、vLLM 0.6.4 | Qwen2.5-32B、同時32リクエスト | 合計206トークン/秒 |
| 4× V100 SXM2 32 GB、llama.cppフォーク | Qwen3.8-Flash-Next 125B、コンテキスト16千 | 42.2トークン/秒 |
| 4× V100 SXM2 32 GB、同じフォーク | 同じモデル、コンテキスト256千 | 21.8トークン/秒 |
最初のテストで測定されたのは、32件のリクエストを処理する際の合計速度であり、1つの対話の性能ではない。
4基のV100を使用した構成では、1250億の主要パラメーターと、1トークンあたり約60億のアクティブパラメーターを持つMoEモデル、Qwen3.8-Flash-Nextを使用した。約156 GiBの量子化版は、128 GiBのビデオメモリに完全には収まらなかった。一部のデータはサーバーのメインメモリに置かれていた。
この実験は、CUDA 12.8と改変版llama.cppを使用し、Windows Server 2022上で実施された。ハードウェアの可能性を示すものだが、ビデオカード1枚でモデルを標準的に実行する場合よりも、はるかに複雑な設定が必要になる。
Level1Techsの比較では、llama.cppにおいてRadeon AI PRO R9700 32 GB 2枚の構成が、V100 2枚より最大合計性能で32%高い結果を示した。一方、vLLMでテンソル並列を使用すると、V100 2枚は206トークン/秒に達し、その実験におけるR9700の最高結果を58%上回った。
この比較は、特定のソフトウェアバージョン、Qwen2.5-32Bモデル、短いリクエストのバッチ処理を対象としている。これらの比率を別のモデルや長いコンテキストにそのまま適用することはできない。
ゲームとFP64演算
Tesla V100は演算用途を想定した製品だが、エンスージアストはSXM2版でゲームも実行している。あるユーザーテストでは、V100 SXM2 16 GBが、2560×1080の解像度、高設定、アップスケーリングとフレーム生成なしの条件で、Cyberpunk 2077において約78 FPSを実現した。
ただし、このモジュールには映像出力、ハードウェアレイトレーシング、DLSSのサポートがない。ゲームには追加のシステム設定が必要になり、32 GBのHBM2も、同程度の性能を持つゲーミングビデオカードに対する実用上の利点にはならない。
倍精度演算では、V100は7.8 TFLOPSのFP64性能に達し、RTX 4090の約6倍となる。そのため、高いFP64性能が必要な科学計算では、この古いアクセラレーターにも依然として価値がある。
ソフトウェアサポート
NVIDIAは、ドライバーブランチR580を最後にVoltaアーキテクチャーのサポートを制限した。R580の保守は2028年6月まで予定されているが、それ以降のブランチはすでにV100を対象としていない。
CUDA 13では、Volta向けのコンパイルとライブラリのサポートが除外された。適合する最後のCUDA Toolkit系列は12.xとなる。ただし、R580ドライバーは、より古いバージョンのCUDA向けにビルドされたアプリケーションとの互換性を維持している。
この問題は、ニューラルネットワーク向けソフトウェアにも徐々に及んでいる。新しい既成ビルドにはsm_70向けコードが含まれないことがあるため、ユーザーは互換性のあるバージョンを使い続けるか、プログラムを自分でコンパイルしなければならない。
現在、V100はllama.cpp、一部のPyTorchビルド、V100向けに適応されたvLLMのバージョン、Volta向けの実験的プロジェクトで使用できる。ただし、最新GPU向けの最適化がこの世代で常に利用できるとは限らない。
BF16とFP8をハードウェアでサポートしていないことも、モデルと計算形式の選択肢を制限している。
V100 SXM2 32 GBの価格
2018年、MicrowayはV100 SXM2 32 GBの価格として$11 458を掲載していた。現在は新しいモジュールは生産されておらず、中古市場の価格は、廃棄されたサーバー機器の供給状況に大きく左右される。
2026年10月、eBayでは次のような出品が見られる。
| 製品 | 価格 |
|---|---|
| Tesla V100 SXM2 32 GB、モジュール単体 | $658~839 |
| Tesla V100 SXM2 16 GB、モジュール単体 | $150~200 |
| Tesla V100 PCIe 32 GB | $650~900 |
| SXM2-PCIeアダプター | $60~100 |
| NVLink対応、SXM2 2基用ボード | 約$300~500 |
| SXM2用ヒートシンクとファン | 約$45~100 |
これらは個別の出品価格であり、平均的な落札価格ではない。送料、税金、パーツの互換性によって、最終的な費用は大きく変わる可能性がある。
SXM2 32 GBを$658で購入し、$60のアダプターと$60の冷却装置を追加した場合、送料を除いて合計は約$778になる。この価格では、完成品のV100 PCIe 32 GBに対する節約が保証されない。
モジュールを$350~400で見つけた場合は状況が異なる。その場合、システム全体の費用は約$470~560となり、PCIe版に対して明確な価格面の優位性を維持できる。
2モジュール構成では、計算はさらに複雑になる。NVLink対応ボード、追加ケーブル、冷却装置、電源ユニットによって、予算が大幅に増える可能性がある。
競合製品と代替製品
Tesla V100 PCIe 32 GB。 同じメモリ容量と帯域幅を持つ最も近い代替製品。カードをPCIeに直接装着できるが、パッシブ冷却には依然として一定方向のエアフローが必要になる。総費用が同程度なら、単一のアクセラレーターとしてはPCIe版のほうが適している。
Tesla V100 SXM2 16 GB。 32 GB版より大幅に安い。アダプターと冷却装置を含めても、システム全体の費用は約$260~350になる可能性がある。小規模から中規模の量子化モデルには適しているが、16 GBという容量によって、選択できるモデルとコンテキスト長が制限される。NVLinkで2基のモジュールを接続すれば合計32 GBのメモリを利用できるが、どのアプリケーションでも単一のアドレス空間になるわけではない。
GeForce RTX 3090 24 GB。 BF16のハードウェアサポート、最新のCUDAライブラリ、Windowsでの通常の動作を備えた、より汎用性の高いビデオカード。プロンプト処理を含む一部のタスクでは、V100より明らかに高速だ。eBayでは約$1200からの出品が見られる一方、10月末時点で出品の大半は約$1600が下限となっている。大規模モデルに対する主な弱点は、メモリ容量が32 GBではなく24 GBであることだ。
AMD Instinct MI50 32 GB。 32 GBのHBM2と約1 TB/sの帯域幅を備えた代替製品。eBayでは約$650から出品されているが、ほかの販売プラットフォームでは価格が異なる場合がある。主な問題は、古いROCmサポートと、計算ソフトウェアの設定がより複雑なことだ。llama.cppでは、Vulkanを使用するバージョンを含む互換ビルドを利用できるが、CUDAプログラムは適応なしでは動作しない。
購入すべきか
Tesla V100 SXM2 32 GBは、24 GBを超えるビデオメモリを必要とするローカル言語モデルを実行したい人や、冷却システムを自分で構築する用意がある人にとって興味深い製品だ。
モジュール価格が$350~400以下なら、追加のパーツ代を含めてもV100 PCIe 32 GBより有利になる可能性がある。 完成したシステムの価格がPCIeカードに近づくと、SXM2の優位性はほぼなくなる。
複数のアクセラレーターを使用する場合は、NVLink対応ボードのほうが魅力的だ。GPU間の通信を高速化し、テンソル並列の実験に適しているが、より大きな費用と複雑な設定が必要になる。
V100 SXM2の主な制限は、冷却、最大300 Wの消費電力、最新の計算形式に対応していないこと、そして徐々に縮小するソフトウェアサポートだ。ローカルLLM、科学計算、CUDAの実験には、現在でも利用できる。
複雑な構築をせずに1枚のビデオカードが必要なら、V100 PCIe 32 GBを選ぶほうがよい。 SXM2を選ぶ意味があるのは、大幅な節約ができる場合か、NVLinkを利用する必要がある場合に限られる。
GPUの比較
Tesla V100 SXM2 32 GBを他のGPUsと比較
基本
メモリ仕様
ディスプレイとメディア
理論上の性能
その他
ベンチマーク
他のGPUとの比較
関連する GPU の比較


ソーシャルメディアで共有する
または当サイトへのリンクを追加
<a href="https://cputronic.com/index.php/ja/gpu/nvidia-tesla-v100-sxm2-32-gb" target="_blank">NVIDIA Tesla V100 SXM2 32 GB</a>