NVIDIA Tesla V100 PCIe 16 GB

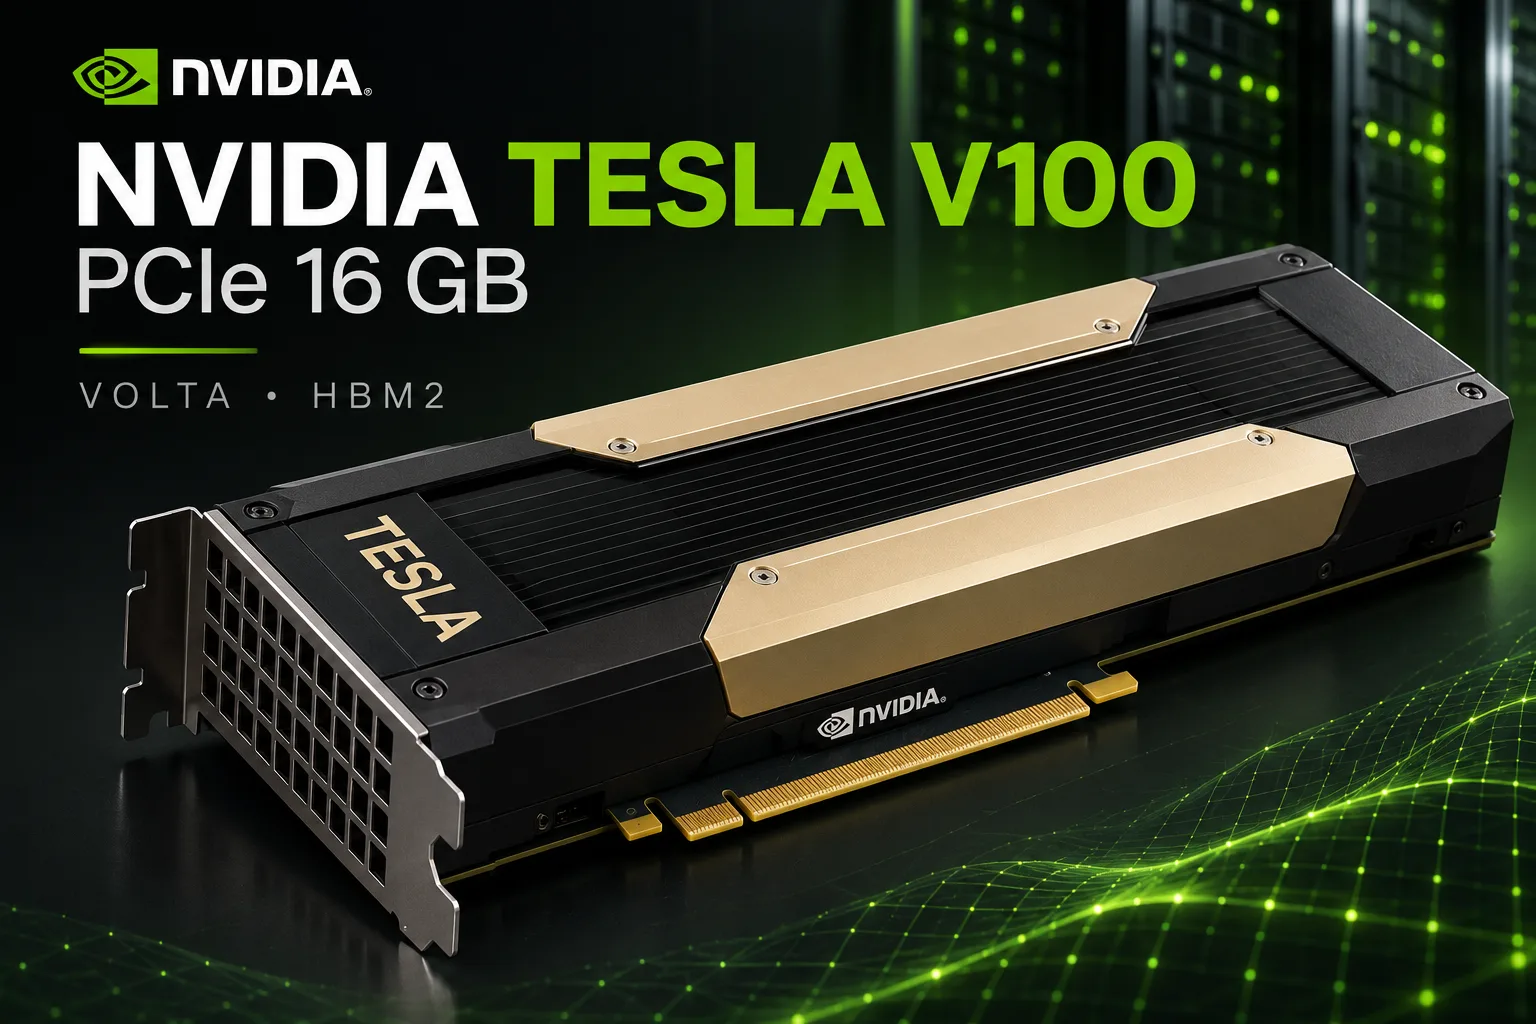
Tesla V100 PCIe 16 GB:低価格で900 GB/sのHBM2、ただしCUDAサポートには制限
Tesla V100 PCIe 16 GBは、2017年に登場したサーバー向けアクセラレーターで、現在でもローカルでのニューラルネットワーク実行や科学計算に興味深い選択肢です。最大の特徴は、GeForce RTX 3090に近い900 GB/sの帯域幅を持つHBM2です。中古市場では数百ドルで購入できますが、安価な出品の多くは完全なPCIeカードではなく、SXM2モジュールである点に注意が必要です。
低価格である一方、いくつかの制約を受け入れなければなりません。V100には映像出力とハードウェアレイトレーシング機能がなく、16 GBのメモリでは大規模言語モデルに不十分です。また、新しいCUDAバージョンのサポートも終了しています。NVIDIAはVoltaをドライバーのR580ブランチに残しており、そのサポートは2028年半ばまで続く予定です。最新のLLMを動かすには、互換性のあるソフトウェアのバージョンを自分で選ぶ必要が生じるケースが増えています。
製品ラインアップにおける位置付け
Tesla V100は、TSMCの12 nmプロセスFFNで製造された、815 mm²のGV100ダイを採用しています。84基のストリーミングマルチプロセッサのうち80基が有効化されており、5120基のCUDAコアと、第1世代の640基のテンソルコアを備えています。4つのHBM2スタックが4096-bitバスで接続されています。
NVIDIAはGV100をベースに、メモリ容量、クロック、インターフェースが異なる複数のアクセラレーターを発売しました。
| モデル | メモリ | 帯域幅 | Boost | TDP | 特徴 |
|---|---|---|---|---|---|
| Tesla V100 PCIe 16 GB | 16 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | PCIe 3.0 x16、NVLinkなし |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | メモリ容量が2倍 |
| Tesla V100 SXM2 16/32 GB | 16/32 GB HBM2 | 900 GB/s | 1530 MHz | 300 W | SXM2、NVLink対応 |
| Tesla V100S PCIe 32 GB | 32 GB HBM2 | 1134 GB/s | 1601 MHz | 250 W | より高速なHBM2 |
| Titan V | 12 GB HBM2 | 653 GB/s | 1455 MHz | 250 W | 映像出力、3072-bitバス |
| Quadro GV100 | 32 GB HBM2 | 870 GB/s | 1627 MHz | 250 W | プロフェッショナルグラフィックス |
16 GBのPCIe版は、FP32で最大14 TFLOPS、FP64で7 TFLOPS、FP16のテンソル演算で112 TFLOPSを発揮します。クロックと電力上限が高いSXM2版と比べると、やや低い数値です。
Voltaは、NVIDIAのアーキテクチャとして初めてテンソルコアを搭載しました。ただし、対応するのはFP16のみで、BF16、TF32、FP8には対応していません。これらのフォーマットがないため、最新のライブラリやモデルでは効率が制限されます。GV100にはハードウェアRTコアもありません。
性能
ローカル言語モデル
トークン生成では、ビデオメモリから重みを読み出す速度が性能を制限することがよくあります。そのため、900 GB/sの帯域幅を持つV100は、はるかに新しいGPUに対しても競争力を維持しています。
比較対象として、llama.cppの開発者が公開した、Q4_0量子化におけるLlama 2 7Bの結果表を利用できます。このテストでは、512トークンのプロンプト処理速度と、FlashAttentionを使わない128トークンの生成速度を測定しています。
| ビデオカード | メモリ | プロンプト処理、トークン/秒 | 生成、トークン/秒 |
|---|---|---|---|
| Tesla P40 | 24 GB GDDR5 | 1007 | 55 |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 3043 | 129 |
| GeForce RTX 3090 | 24 GB GDDR6X | 5175 | 158 |
| GeForce RTX 4090 | 24 GB GDDR6X | 11 993 | 186 |
| GeForce RTX 5090 | 32 GB GDDR7 | 14 073 | 290 |
結果は、複数のユーザーが実施したテストから集められたものです。モデルと主要なパラメーターは同一ですが、llama.cppのバージョン、ドライバー、システム構成は異なる可能性があります。
表でテストされているのはV100 PCIe 32 GBです。16 GB版もクロックとHBM2の帯域幅は同じで、モデル自体のサイズは4 GB未満です。そのため、近い性能が期待されますが、ここには16 GB版を直接測定した結果はありません。
生成速度では、V100はRTX 3090に約18%遅れ、プロンプト処理では41%遅れています。短い対話では差が目立たない場合もありますが、大きな文書や長い会話履歴を処理すると、その差はより明確になります。
RTX 4090はV100の約4倍の速度でプロンプトを処理しますが、生成における優位性は44%にとどまります。これは、メモリ帯域幅だけでは、あらゆるタスクの性能を決められないことを示しています。
V100 PCIe 16 GBの最大の制約はメモリ容量です。このカードは、4-bit量子化した70億~140億パラメーターのモデルに適しています。270億~320億パラメーターのモデルでは、通常、システムメモリへの一部オフロードか、より強い圧縮が必要になります。どちらの場合も、速度、品質、コンテキスト長のいずれかで妥協しなければなりません。
学習と科学計算
V100は、何よりもニューラルネットワークの学習と高性能計算を目的に開発されました。FP16のテンソルコアは現在でも有用ですが、新しいアクセラレーターは、より効率的な計算フォーマット、大容量化されたキャッシュ、最適化されたライブラリを備えています。
特に、BF16を使用するモデルの学習では制約が目立ちます。V100はこのフォーマットをハードウェアでサポートしていないため、最新のPyTorchやその他のフレームワークの構成を、変更なしでVoltaに移行できない場合があります。
一方、倍精度演算では、V100はゲーミング向けGeForceに対して大きな優位性を保っています。FP64性能は7 TFLOPSに達し、RTX 4090の約5.4倍です。
分子動力学、数値モデリング、その他のHPCタスクでは、使用するソフトウェアがVoltaをサポートしている限り、V100は依然として興味深い選択肢です。ただし、カタログ上のFP64性能が高いからといって、特定のプログラムでも同じ優位性が得られるとは限りません。
Tesla V100でゲームはできるのか
V100 PCIeには映像出力がありません。画面を表示するには、別のビデオカードまたはCPU内蔵グラフィックスが必要です。Windowsでは、互換性のあるドライバーを選び、ゲームを演算用アクセラレーター上で起動するよう設定する必要もあります。
愛好家たちは、PCIe変換アダプターを介してV100 SXM2 16 GBのゲーム性能を検証しました。Ryzen 7 5700GEを搭載したシステムで、アップスケーリングとフレーム生成を使わず、高設定にした場合の結果は以下のとおりです。
| ゲーム | 2560×1080、平均FPS | 3440×1440、平均FPS |
|---|---|---|
| Cyberpunk 2077 | ~78 | ~56 |
| Hogwarts Legacy | ~55-60 | ~40 |
| Atomic Heart | ~115 | ~75-80 |
| Red Dead Redemption 2 | ~80 | ~65 |
Cyberpunk 2077では、アクセラレーターの消費電力は約181 Wでした。これらの結果は、Voltaが現在のゲームにもまだ対応できることを示していますが、DLSSとハードウェアレイトレーシングに対応していないため、その能力は大きく制限されます。
重要なのは、これらがPCIe版ではなくSXM2版のテストだという点です。SXM2版のBoostクロックはPCIe版の1380 MHzに対して1530 MHzに達し、電力上限も50 W高くなっています。そのため、PCIe版はより遅い可能性があります。個別の測定なしにFPSの差を特定することはできません。
ゲーム専用にV100を購入するのは割に合いません。通常のGeForceのほうが設置しやすく、最新のグラフィックス技術に対応しており、映像出力のために別のビデオカードを用意する必要もありません。
一般的なPCへの取り付け
SXM2とは異なり、Tesla V100 PCIeは標準的なPCIe x16スロットに直接接続できます。ただし、家庭用PCに取り付けるには、やはり準備が必要です。
電源。 リファレンス仕様のV100 PCIeには、8ピンのCPU EPS12Vコネクターが搭載されています。これは通常の8ピンPCIeコネクターとは異なります。NVIDIAは、適切なEPS12Vケーブルを接続するか、PCIeコネクターを備えた専用変換アダプターを使用する方法を認めています。
初回起動の前に、ケーブルのピン配列と許容負荷を確認する必要があります。コネクターが似ているという理由だけで、適合しないケーブルを接続してはいけません。
冷却。 このカードには、サーバー内部の強いエアフローを前提としたパッシブヒートシンクが搭載されています。一般的なPCケースでは、風を直接当てる別のファンが必要になります。
十分な冷却がない場合、アクセラレーターはクロックを下げたり、過熱したりする可能性があります。確認すべきなのはコア温度だけではなく、長時間負荷をかけた際の動作の安定性も含まれます。
消費電力。 仕様上の上限は250 Wです。nvidia-smiを使えば、許容電力を例えば180 Wまで下げられます。これにより発熱と冷却要件は軽減されますが、性能への影響はタスクによって異なります。
ソフトウェアサポート:最大の制約
NVIDIAは、R580がMaxwell、Pascal、Voltaをサポートする最後のドライバーブランチになることを確認しています。サーバー向けアクセラレーターについては、R580は長期サポートのラインに属し、サポート終了は2028年6月です。
CUDA 13では、compute capabilityがsm_70のVoltaアーキテクチャ向けアプリケーションをコンパイルできなくなりました。最後に互換性を持つCUDA Toolkitの系列は12.xで、12.9も含まれます。
ただし、CUDA 13の登場後にV100が動作しなくなったわけではありません。以前のCUDAバージョンでVolta対応としてビルドされたプログラムは、互換性のあるドライバー上で引き続き起動できます。
問題は、新しいバージョンのプログラムやライブラリにあります。
- llama.cpp。 ソースコード上はsm_70対応版をビルドできますが、新しい最適化がVoltaをサポートしていない可能性があります。
- PyTorch。 V100では、CUDA 12.xと対応するcompute architectureをサポートするビルドを選ぶ必要があります。
- LM StudioとOllama。 互換性はアプリケーションのバージョンと付属するCUDAランタイムに左右されます。一部の機能では、より古いビルドが必要になる場合があります。
- FlashAttention 2。 通常のCUDA実装は新しいアーキテクチャ向けに設計されているため、V100では代替のアテンション処理メカニズムを使う必要があります。
家庭での実験であれば、これは許容できる範囲です。互換性のある環境を維持し、必要なものだけを選択的に更新できます。しかし、業務用サーバーでは制約がより深刻になります。フレームワークの新しいバージョンが、徐々にVoltaのサポートを終了しているためです。
中古市場での価格
V100の価格は、仕様によって大きく異なります。安価なSXM2モジュールはTesla V100の検索結果に含まれることが多いものの、変換アダプターなしでPCに取り付けることはできません。
2026年10月28日時点のeBayの出品状況をまとめると、以下のようになります。
| ビデオカード | 出品価格の下限帯 | 出品価格の中央値 |
|---|---|---|
| Tesla V100 PCIe 16 GB、パッシブ仕様 | $329 | $422 |
| Tesla V100 SXM2 16 GB | $191 | $300 |
| Tesla V100 SXM2 32 GB | $842 | $990 |
| Tesla V100 PCIe 32 GB、パッシブ仕様 | $860 | $960 |
| GeForce RTX 3090 24 GB | $1651 | $1970 |
価格は成立済みの取引ではなく、掲載中の出品を対象としています。V100 PCIe 16 GBの個別の販売例では、約$240-275で取引されたものもありますが、こうした価格で確実に入手できるとは考えられません。
16 GBのPCIe版については、動作確認が可能な正常品で$300-350を目安にするのが妥当です。価格が約$400になると、特に冷却装置と電源ケーブルも別途必要な場合、魅力は低下します。
完成した家庭用システムを用意する費用は、アクセラレーター本体の価格を大きく上回る可能性があります。そのため、V100を他の選択肢と比較する際は、すべての部品の費用を考慮してから判断すべきです。
競合製品と代替製品
Tesla V100 SXM2 16 GB。 モジュール単体はPCIe版より安価ですが、変換アダプター、電源、専用の冷却が必要です。最終的な費用は、完成品のPCIeカードと同程度になる可能性があります。GPUを1基だけ使う場合、SXM2の優位性は通常、複雑な構成を正当化できません。一方、NVLinkを備えた複数モジュール用ボードでは話が異なります。
Tesla V100 PCIe 32 GB。 同じ演算アーキテクチャーとメモリ帯域幅を備えますが、HBM2の容量は2倍です。270億~320億パラメーターの言語モデルには、こちらのほうが大幅に適しています。ただし、価格が$800-1000になると、旧世代アーキテクチャーによる経済的な優位性は、それほど明確ではなくなります。
GeForce RTX 3090 24 GB。 プロンプト処理が高速で、BF16、最新のCUDA最適化、ハードウェアレイトレーシングに対応しています。24 GBのメモリにより、V100 16 GBより大規模なモデルを扱えます。中古市場では約$1200からの出品もありますが、出品の大半はそれより高価です。より汎用性の高いカードですが、追加費用は大きくなります。
GeForce RTX 5060 Ti 16 GB。 新しいアーキテクチャー、最新ライブラリへの対応、映像出力、DLSS 4、メーカー保証を備えています。メモリ帯域幅はV100の900 GB/sに対して448 GB/sと低いものの、この差だけからLLMの速度を直接予測することはできません。最新の演算コアとソフトウェア最適化によって、帯域幅不足を補える可能性があるためです。ゲームや日常用途では、RTX 5060 Tiのほうが適しています。
AMD Instinct MI50 32 GB。 HBM2の容量が2倍で、帯域幅は約1 TB/s、FP64性能も高い代替製品です。個別の出品価格はおよそ$650から始まります。最大の制約は、ROCmのサポートが陳腐化しつつあることと、最新の計算ソフトウェアで問題が生じやすいことです。CUDA向けに作られたソフトウェアでは、通常V100のほうが扱いやすいでしょう。
Tesla P40 24 GB。 GDDR5と24 GBのメモリを搭載した、より古いカードです。llama.cppのテストでは、V100の129トークン/秒に対して約55トークン/秒の生成速度でした。一方、追加の8 GBにより、V100 16 GBには収まらないモデルを起動できます。そのため、速度よりもメモリ容量を重視する場合、P40は依然として代替候補になります。
Tesla V100 PCIe 16 GBを買うべきか
Tesla V100 PCIe 16 GBは、ローカルでのニューラルネットワーク実行、科学計算、CUDAの実験用として、現在でも魅力があります。数百ドルで、900 GB/sのメモリ帯域幅、640基のテンソルコア、7 TFLOPSのFP64性能を手に入れられます。
しかし、16 GBという容量は言語モデルの選択肢を制限し、Voltaのソフトウェアサポートも徐々に縮小しています。このカードには、直接風を当てる冷却、適切な電源、ドライバーとライブラリのバージョンを慎重に選ぶ作業が必要です。
価格が$300-350以下なら、V100 PCIe 16 GBは家庭用の計算環境を構築するうえで良い買い物だと考えられます。 カードが$400以上する場合は、取り付けにかかる費用も含め、SXM2 16 GB、P40 24 GB、より新しいアクセラレーターと比較すべきです。
140億パラメーターまでのモデルであれば、V100の性能で通常は十分です。システムメモリへのオフロードなしで270億~320億パラメーターのモデルをローカル実行したいなら、最初から24-32 GBのメモリを搭載したビデオカードを検討したほうがよいでしょう。
V100は、汎用ビデオカードとしてではなく、具体的な計算タスクのために購入すべき製品です。多くの実験に対応できるだけの性能はまだありますが、今後数年間にわたって最新ソフトウェアが完全にサポートされるとは、もはや期待できません。
GPUの比較
Tesla V100 PCIe 16 GBを他のGPUsと比較
基本
メモリ仕様
ディスプレイとメディア
理論上の性能
その他
ベンチマーク
他のGPUとの比較
関連する GPU の比較


ソーシャルメディアで共有する
または当サイトへのリンクを追加
<a href="https://cputronic.com/index.php/ja/gpu/nvidia-tesla-v100-pcie-16-gb" target="_blank">NVIDIA Tesla V100 PCIe 16 GB</a>