NVIDIA Tesla P100 PCIe 12 GB

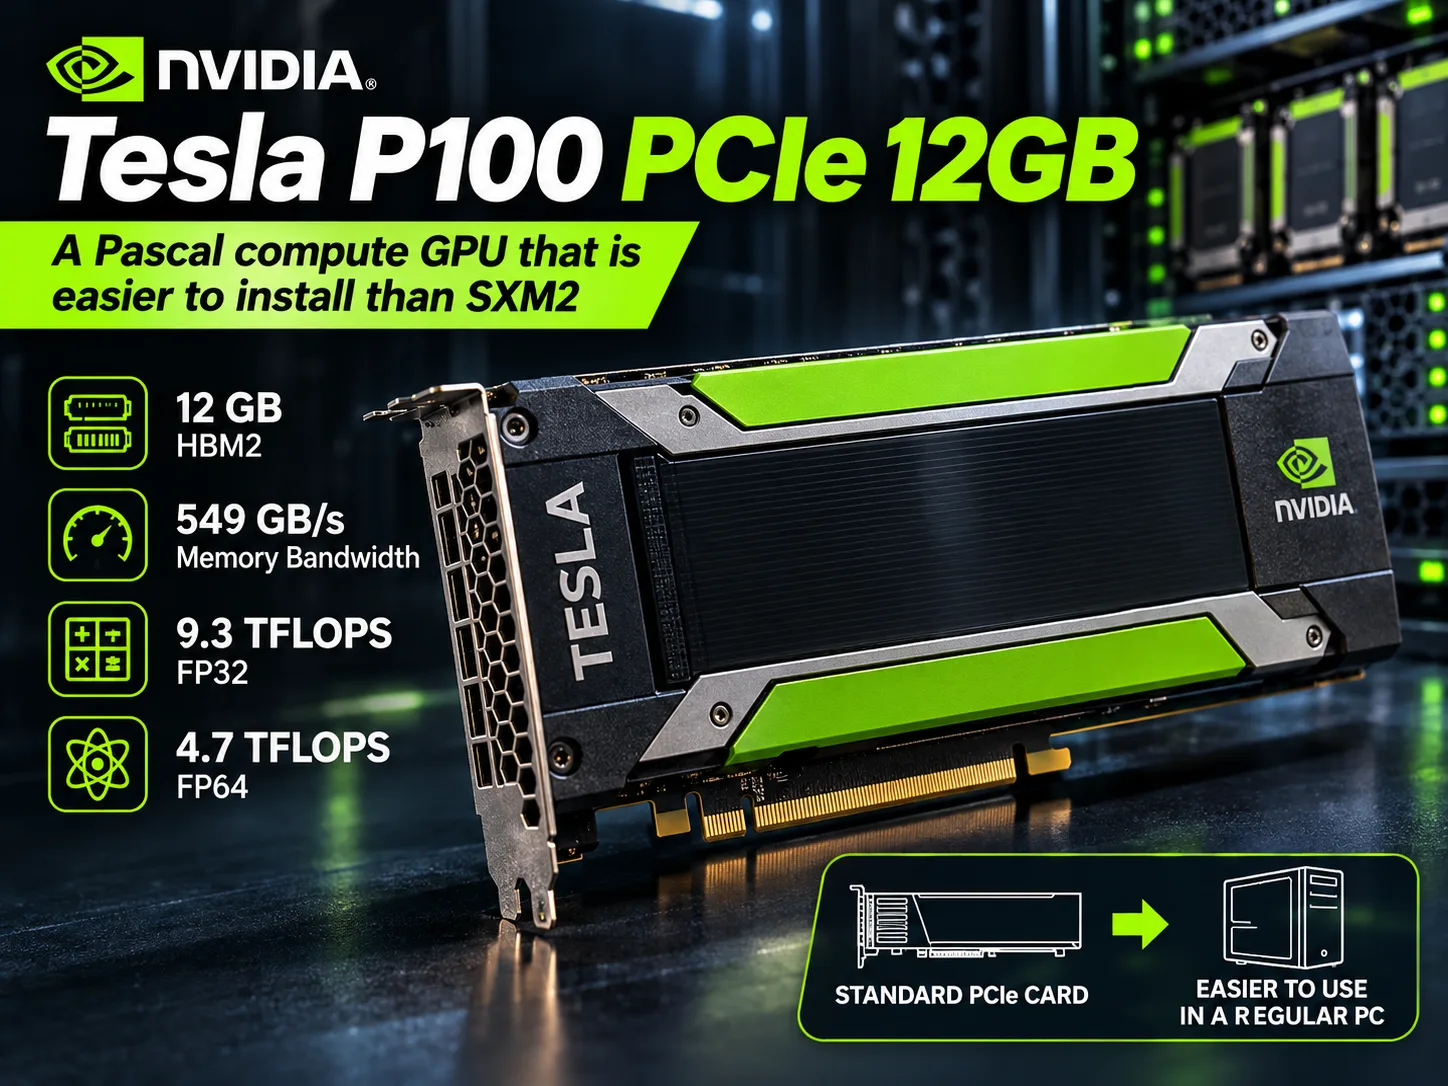
Tesla P100 PCIe 12 GB:サポート終了時期が決まった$80のFP64計算機
Tesla P100は、Pascalアーキテクチャを採用したNVIDIA初のアクセラレーターで、2016~2017年にはスーパーコンピューターやニューラルネットワークの学習に使われる主要なカードの1つだった。当時、PCIe向けの12 GB版は約$4600で販売されていた。現在は退役サーバーから引き揚げられたカードがeBayで$70~140で販売されており、低価格帯のゲーミングビデオカードより安い。
このカードが買われる理由は、倍精度演算性能とHBM2メモリだ。FP64では4.7 TFLOPSを発揮し、RTX 4090を上回る。ただし下位版はメモリ面で不利だ。4つあるHBM2スタックのうち1つが無効化されているため、容量と帯域幅はP100 16 GBより25%低い。Pascalのソフトウェアサポートは、R580ドライバーブランチとともに2028年半ばに終了する。
ラインアップ内での位置付けとアーキテクチャ
Tesla P100はすべて、610 mm²の16 nmダイであるGP100を採用している。このダイは、4つのHBM2スタックとともにCoWoS基板上に搭載される。フルチップの3840基のCUDAコアのうち、P100で有効なのは3584基だ。PCIe版は、TDP 250 Wで1190~1329 MHzで動作する。
12 GB版は、メモリスタックを1つ無効化した同じ基板の製品だ。コアと動作周波数は変わっていないため、演算性能は上位モデルと同じである。
| モデル | メモリ | バス | メモリ帯域幅 | FP64 | FP16 | TDP |
|---|---|---|---|---|---|---|
| Tesla P100 PCIe 12 GB | 12 GB HBM2 | 3072 bit | 549 GB/s | 4.7 TFLOPS | 18.7 TFLOPS | 250 W |
| Tesla P100 PCIe 16 GB | 16 GB HBM2 | 4096 bit | 732 GB/s | 4.7 TFLOPS | 18.7 TFLOPS | 250 W |
| Tesla P100 SXM2 | 16 GB HBM2 | 4096 bit | 732 GB/s | 5.3 TFLOPS | 21.2 TFLOPS | 300 W |
| Tesla P40 | 24 GB GDDR5 | 384 bit | 347 GB/s | FP32の1/32 | FP32の1/64 | 250 W |
GeForceにはGP100チップは採用されなかった。ワークステーション向けの近縁製品は、ビデオ出力を備えたQuadro GP100だ。GTX 1080 TiとTesla P40は、別のダイであるGP102を採用している。GP100はFP32の半分の速度でFP64を処理し、FP16はFP32の2倍の速度で処理する。一方、GP102では両モードともほぼゼロまで制限されている。
ただし、GP100(Compute Capability 6.0)には、GP102が備えるDP4A命令がない。DP4Aは整数のスカラー積に使われる命令だ。量子化ニューラルネットワークでは、この違いが2016年当時に考えられていた以上に重要になった。
P100にテンソルコアはない。テンソルコアが登場したのは、2017年のVoltaアーキテクチャ採用Tesla V100からだ。
パフォーマンス
ゲームには向かない。ビデオ出力を備えておらず、2枚目のビデオカード経由で映像を出力していたエンスージアストからも、データセンター向けドライバーへの不満が出ており、P100はゲームには勧められていない。現在でも使える用途は、ローカル言語モデルと倍精度計算だ。
llama.cppコミュニティによるCUDA向けのまとめ(Llama 2 7B、Q4_0、Flash Attentionなし):
| アクセラレーター | メモリ | プロンプト処理、トークン/秒 | 生成、トークン/秒 |
|---|---|---|---|
| RTX 3090 | 24 GB GDDR6X | 5174 | 158 |
| Tesla V100 | 32 GB HBM2 | 3043 | 129 |
| RTX 2080 Ti | 11 GB GDDR6 | 2890 | 107 |
| GTX 1080 Ti | 11 GB GDDR5X | 1084 | 62 |
| Tesla P100 PCIe 16 GB | 16 GB HBM2 | 761 | 58.4 |
| Tesla P40 | 24 GB GDDR5 | 1007 | 54.7 |
| Tesla T4 | 16 GB GDDR6 | 1219 | 46.4 |
P100の生成速度はGTX 1080 TiやP40と同程度だ。プロンプト処理はRTX 2080 Tiの3.8倍遅く、同じP40よりも遅い。チャットで短い入力を使うなら許容できるが、長い文書では、応答前にモデルがテキストを「読む」時間が明らかに長くなる。
2026年10月に、ComputingForGeeksがllama.cppの最新版で行ったテストでも同じ結果が出た。Q4_K_MのQwen3 8Bでは、P100 16 GBが38.4トークン/秒だったのに対し、P40は47トークン/秒だった。P100のメモリ帯域幅は2倍近く高速であるにもかかわらずだ。原因はDP4Aがないことで、Compute Capability 6.0ではllama.cppの量子化カーネルが低速な経路を通るためである。
そのため、12 GB版で削減されたメモリバスは、言語モデルではほとんど足かせにならない。Llama 2 7Bのテストでは、P100 16 GBが約220 GB/sを使用しており、ピーク帯域幅の3分の1未満にすぎない。つまり、ボトルネックは演算性能だ。llama.cppには12 GB版の個別測定結果はないが、小型モデルでは生成速度が16 GB版に近くなるはずだ。12 GB版の問題は容量にある。gpt-oss-20bや、14Bを超える高密度モデルは収まらない。
FP64では状況が逆になる。RTX 4090の倍精度性能は約1.3 TFLOPSで、RTX 3090はP100の10分の1しかない。FP64性能で近いのは、次世代のサーバー向けカードだけだ。V100 PCIeは7 TFLOPS、AMD Instinct MI50は6.6 TFLOPSを実現する。格子法や流体力学など、FP64の処理がメモリ帯域幅に制約される計算では、12 GB版は上位モデルに最大25%遅れる。
具体的なシステムでの結果
12 GB版そのものを対象にした公開テストはほとんどないため、表には同じチップを搭載する16 GBモデルの結果も含めている。
| システム | 構成 | P100のバージョン | テスト | 結果 |
|---|---|---|---|---|
| Uniwide RB228H | 2× Xeon E5-2699 v4 | PCIe 12 GB | SPEC ACCEL OpenCL, base | 5.15 |
| Database Martのホスティングサーバー | 2× Xeon E5-2660 v2、128 GB DDR3 | PCIe 16 GB | Ollama、Llama 2 7B | 49.7トークン/秒 |
| レンタルしたvast.aiのノード | 不明 | PCIe 16 GB | llama.cpp、Qwen3 8B Q4_K_M | 38.4トークン/秒 |
49.7トークン/秒と38.4トークン/秒の違いは、サーバーではなくモデルと量子化によるものだ。モデル全体がビデオメモリに収まるなら、CPUは生成速度にほとんど影響しない。2013年のXeon E5 v2を搭載したプラットフォームでも、カードの足を引っ張ることはない。
アイドル時の消費電力は、P100が28 W、P40が11 Wだ。LLM負荷時には、P100のピーク消費電力は211 Wに達する。
出回っている場所、価格、入手性
P100を搭載した新品の製品は販売されていない。かつては、Dell PowerEdge R730、R740、C4130、C4140、Cisco UCS C240 M5、C220 M5SX、HPE ProLiantの搭載オプションとして提供されていた。現在はそこから中古市場に流れてきており、通常はケーブルが付属しない。
| 種類 | 状態 | 価格 |
|---|---|---|
| Tesla P100 PCIe 12 GB | 中古、大量出品 | $70~100 |
| Tesla P100 PCIe 12 GB | 中古、動作確認・返品対応付き | $110~165 |
| Tesla P100 PCIe 16 GB | 中古、中国からのロット品 | $118~130 |
| Tesla P100 PCIe 16 GB | 再生品、Amazon | 約$155 |
通常のPCにカードを取り付けるには、いくつか追加で購入する必要がある。
| 必要なもの | 用途 | 価格 |
|---|---|---|
| シュラウドとターボファン | パッシブ冷却仕様のため | $20から+ファン |
| 8-pin EPS変換アダプター | PCIeではなくCPU用のコネクター | 約$13 |
| 内蔵グラフィックスまたは2枚目のカード | ビデオ出力がないため | - |
BIOSではAbove 4G Decodingを有効にする必要がある。P100をBlackwell世代のカードと同じシステムで動作させることはできない。両者には異なるNVIDIAカーネルモジュールが必要だからだ。すぐ使える状態のP100 12 GBを用意すると、最終的な費用は$110~150になる。
競合製品と代替品
Tesla P100 PCIe 16 GB(約$130~155)。チップは同じで、メモリが4 GB多く、帯域幅は3分の1高い。$40~60を追加すれば、gpt-oss-20b、通常のコンテキスト長を確保した14Bモデル、そしてメモリ帯域幅がボトルネックになるタスクでの本来の速度が得られる。下位版が有利なのは、容量が重要でないFP64計算に限られる。その用途では計算性能が同じで、価格は安い。
Tesla P40 24 GB(約$300~350)。メモリ容量は2倍で、DP4Aも備えている。Q4なら32Bモデルが丸ごと収まり、約12トークン/秒で生成できる。FP16とFP64は実質的に使えないため、計算用途には向かない。14Bを超えるモデルには、どのP100よりも有用だ。
Tesla V100 PCIe 16 GB(約$365)。テンソルコアを搭載し、プロンプト処理は3~4倍高速で、FP64性能は7 TFLOPSに達する。サポート終了時期はPascalと同じだ。3倍の金額を払えば、同じ寿命で、明らかに高速なカードが手に入る。
GeForce RTX 3060 12 GB(中古で約$300~320)。メモリ容量は同じだが、現行のCUDA、vLLM、そして今後のPyTorchのバージョンが動作する。ビデオ出力と一般的な冷却機構を備え、消費電力は170 Wだ。テンソルコアによってプロンプト処理も大幅に高速化される。倍精度性能は名ばかりだ。数年間サポートされるソフトウェアを使える一般的なビデオカードが必要なら、RTX 3060の方が有利だが、価格は3倍になる。
結論
言語モデルでは、P100 12 GBのテキスト生成速度はGTX 1080 Tiと同程度で、プロンプト処理はRTX 2080 Tiの3~4倍遅い。4ビット量子化した7~14Bモデルや、古いサーバーでOllamaとllama.cppを試すには十分だ。14Bを超えるモデルは収まらず、長いプロンプトの処理も遅い。vLLMはサポートされず、PyTorchはPascal向け既成ビルドの提供を終了すると発表している。ドライバーも2028年に提供が終了する。これに250 Wの消費電力と、騒音の大きいターボファンが加わる。
このカードに$80を超えて払うべきではない。14Bを超えるモデルが必要ならP40を、2028年以降も動作するソフトウェアが必要ならRTX 3060 12 GBを選ぶとよい。
倍精度計算用としては、$70~80のP100 12 GBにほとんど競合製品がない。ニューラルネットワーク用途なら、$50を追加して16 GB版を選ぶ方がよい。
GPUの比較
Tesla P100 PCIe 12 GBを他のGPUsと比較
基本
メモリ仕様
ディスプレイとメディア
理論上の性能
その他
ベンチマーク
他のGPUとの比較
ソーシャルメディアで共有する
または当サイトへのリンクを追加
<a href="https://cputronic.com/index.php/ja/gpu/nvidia-tesla-p100-pcie-12-gb" target="_blank">NVIDIA Tesla P100 PCIe 12 GB</a>