NVIDIA Tesla V100 SXM3 32 GB
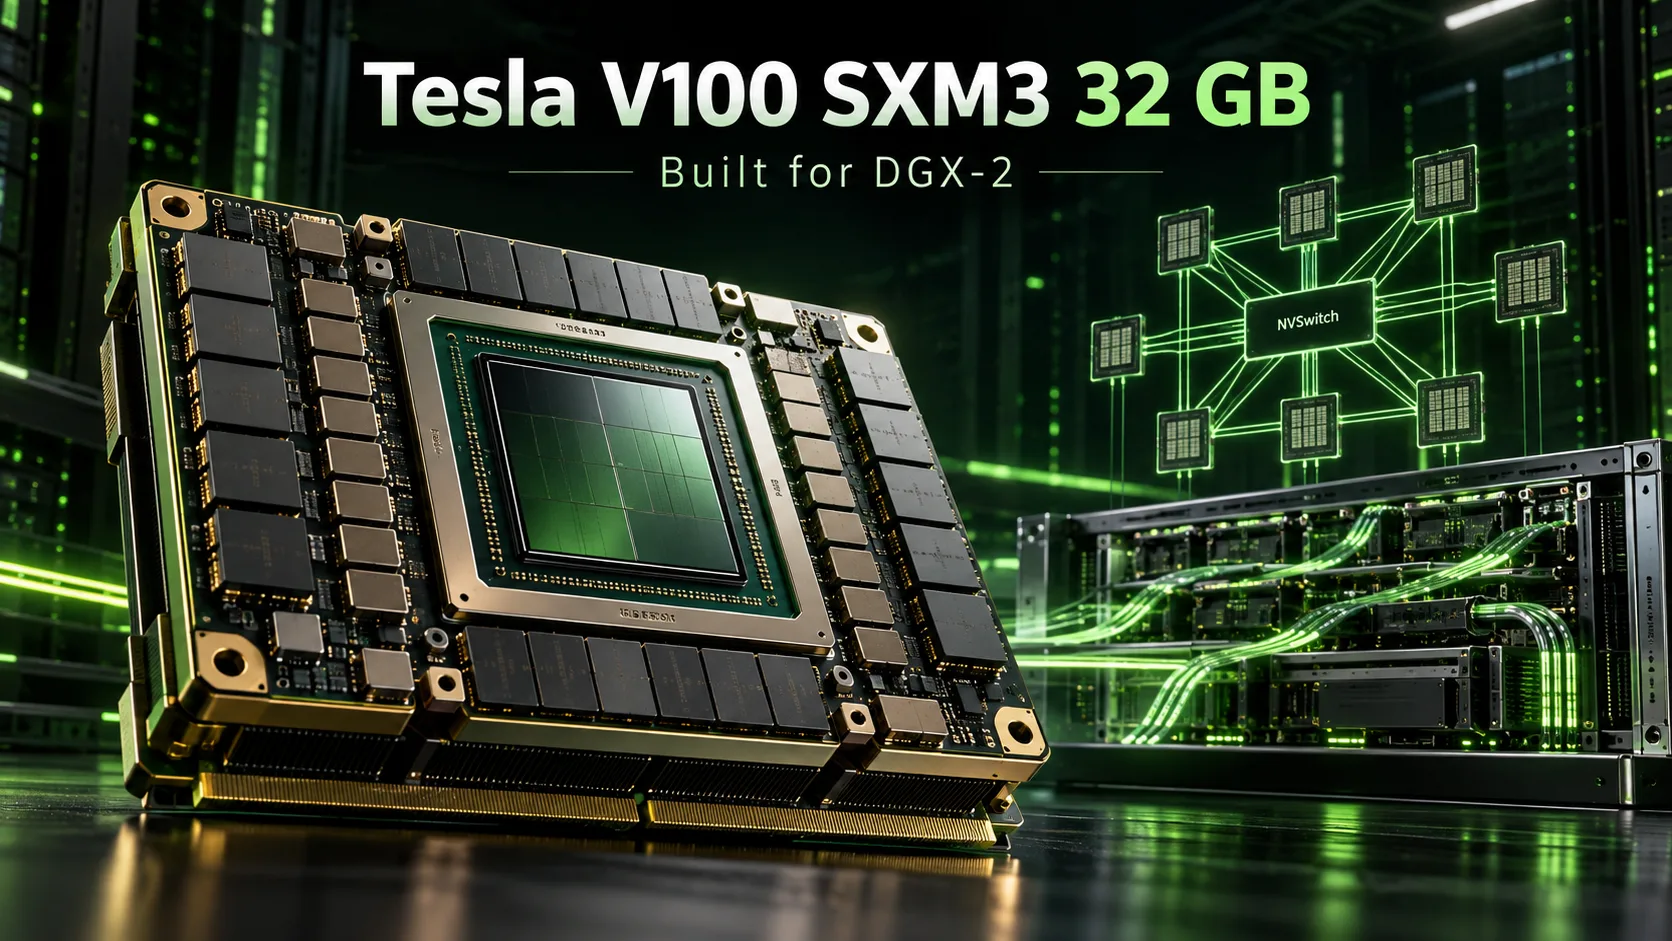
Tesla V100 SXM3 32 GB: più potente della SXM2, ma molto più difficile da utilizzare
Tesla V100 SXM3 32 GB è un modulo di calcolo NVIDIA per il supercomputer DGX-2 e i server basati sulla piattaforma HGX-2. NVIDIA presentò DGX-2 nel marzo 2018. Il sistema si basava su 16 acceleratori con architettura Volta, collegati tramite switch NVSwitch. Rispetto alla normale V100 SXM2, la nuova versione si distingueva per frequenze più elevate, maggiore banda passante della memoria e un limite di potenza di 350 W.
La SXM3 supera la SXM2 nelle caratteristiche, ma è molto meno adatta all’assemblaggio autonomo. Il modulo utilizza un connettore speciale e richiede un sistema di alimentazione e raffreddamento compatibile, mentre il suo funzionamento al di fuori di una piattaforma server è praticamente non verificato. Anche se fosse possibile collegare la SXM3 a un normale computer, il modesto vantaggio in termini di velocità difficilmente giustificherebbe i costi.
Posizione nella gamma
| Modello | Memoria | Banda passante | Boost | Potenza |
|---|---|---|---|---|
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 900 GB/s | 1380 MHz | 250 W |
| Tesla V100 SXM2 32 GB | 32 GB HBM2 | 900 GB/s | 1530 MHz | 300 W |
| Tesla V100 SXM3 32 GB | 32 GB HBM2 | 981 GB/s | 1597 MHz | 350 W |
| Tesla V100 SXM3 32 GB H | 32 GB HBM2 | 1134 GB/s | 1702 MHz | 450 W |
Tutte e quattro le versioni utilizzano lo stesso die GV100 con 5120 core CUDA e 640 Tensor Core. La differenza riguarda le frequenze, le impostazioni di alimentazione e il metodo di collegamento.
La SXM3 standard raggiunge circa 16,4 TFLOPS in FP32 e 8,2 TFLOPS in FP64. La banda passante della memoria è superiore del 9% rispetto alla SXM2, mentre la frequenza della GPU è aumentata di circa il 4%. Queste differenze danno alla SXM3 un vantaggio nei calcoli e nei carichi di lavoro limitati dalla velocità della memoria, anche se l’incremento effettivo dipende dal carico.
Per DGX-2H, NVIDIA preparò una versione più potente, la SXM3-H. Il suo limite di potenza è stato portato a 450 W, mentre la banda passante della memoria raggiunge 1134 GB/s. È la versione V100 più prestante nel formato SXM.
DGX-2 e NVSwitch
La principale novità di DGX-2 non fu l’aumento della frequenza della GPU, bensì il modo in cui gli acceleratori venivano collegati.
Nel DGX-1, otto acceleratori SXM2 erano collegati direttamente tramite NVLink. La topologia limitava lo scambio di dati tra singole coppie di GPU. Nel DGX-2, sedici moduli SXM3 furono collegati a dodici switch NVSwitch, garantendo una connessione ad alta velocità tra tutti gli acceleratori.
Il sistema disponeva complessivamente di 512 GB di memoria HBM2. Ogni GPU poteva accedere alla memoria delle altre, ma questo non trasformava i sedici acceleratori in un’unica GPU con un buffer locale condiviso. Le latenze di accesso alla memoria remota restavano più elevate e le applicazioni richiedevano il supporto al calcolo distribuito.
La banda passante dell’interconnessione tra le due metà del sistema raggiungeva 2,4 TB/s. Per l’addestramento di reti neurali di grandi dimensioni, questo era più importante del modesto aumento della frequenza dei singoli moduli.
DGX-2 offriva circa 2 PFLOPS sui Tensor Core, consumava fino a 10 kW e costava $399 000 al lancio. NVIDIA ha continuato a sviluppare l’architettura con NVSwitch nelle generazioni successive di DGX, incluso DGX A100.
Prestazioni nei carichi di lavoro moderni
Esistono pochissimi test indipendenti della V100 SXM3 con i moderni modelli linguistici. La maggior parte dei risultati disponibili è stata ottenuta su SXM2 e PCIe, quindi non è ancora possibile determinare con precisione il vantaggio della SXM3 nella generazione del testo.
Come riferimento, una Tesla V100 SXM2 32 GB raggiunge circa 32 token/s durante la generazione con Qwen3.6-27B nel formato Q4_K_M utilizzando llama.cpp. Si tratta del risultato di una singola scheda video, non di un sistema con più GPU.
La SXM3 dispone di una banda passante della memoria superiore del 9%, quindi in teoria potrebbe essere più veloce durante la generazione. Tuttavia, non è corretto trasferire direttamente questa percentuale alla velocità di generazione dei token. Il risultato dipende dalla quantizzazione, dalle dimensioni del contesto, dal motore software e dalle caratteristiche del modello.
Nei carichi di lavoro FP32 e FP64, anche le frequenze più elevate offrono un vantaggio. Tuttavia, l’architettura Volta è inferiore agli acceleratori più recenti per quanto riguarda l’insieme dei formati di calcolo supportati.
Principali limitazioni software:
- CUDA: l’architettura di calcolo sm_70 è supportata fino a CUDA 12.9. A partire da CUDA 13, non è più disponibile la compilazione di nuovi kernel GPU per Volta.
- Driver: R580 è l’ultimo ramo di NVIDIA con supporto a Volta.
- BF16: il supporto hardware è assente, limitando la compatibilità con gli strumenti moderni per l’addestramento delle reti neurali.
- FlashAttention 2: l’implementazione ufficiale non supporta Volta. È necessario utilizzare altri meccanismi di attenzione.
La V100 è ancora in grado di eseguire LLM locali, ma l’avvio di nuovi modelli e librerie richiede talvolta build speciali.
È possibile utilizzare la SXM3 in un normale computer?
A differenza di una scheda PCIe, il modulo SXM3 non si installa direttamente nello slot della scheda madre. È progettato per schede server specializzate con il connettore, il sistema di alimentazione e il raffreddamento appropriati.
Sul mercato dell’usato si trovano annunci per adattatori da SXM3 a PCIe dal costo di circa $200-300. Tuttavia, alcuni riportano codici prodotto relativi alla SXM2. Le conferme indipendenti del funzionamento stabile di veri moduli SXM3 con questi adattatori non sono sufficienti.
Prima dell’acquisto è necessario verificare:
- Se la scheda supporta proprio SXM3 e non SXM2.
- Se il sistema di alimentazione è in grado di sostenere un carico fino a 350 W.
- Come è organizzato il raffreddamento del modulo.
- Se la GPU viene rilevata dal driver NVIDIA e supera un test prolungato sotto carico.
Una semplice foto della scheda o una dichiarazione del venditore sulla compatibilità non sono sufficienti. È consigliabile ottenere i risultati di nvidia-smi, un test CUDA e una conferma del funzionamento stabile proprio con una V100 SXM3.
All’interno di DGX-2 e HGX-2 questi problemi non si presentano. Tuttavia, acquistare un intero server per alcuni acceleratori obsoleti è difficile da giustificare. DGX-2 richiede un’infrastruttura di alimentazione e raffreddamento ad alta capacità, mentre la sua efficienza energetica è inferiore a quella dei sistemi moderni basati su A100 e GPU più recenti.
Alternative
Tesla V100 SXM2 32 GB. È l’alternativa più vicina, con la stessa quantità di memoria. Sul mercato dell’usato si sono viste vendite a circa $450-700, anche se le offerte attuali possono essere molto più costose. Per la SXM2 esistono adattatori PCIe e schede modificate già pronte con raffreddamento. È comunque necessario considerare il costo dell’adattatore e la qualità della modifica.
Tesla V100 PCIe 32 GB. È una soluzione più semplice per un server compatibile con PCIe. In base alle transazioni concluse, il riferimento è di circa $650-850, ma nell’autunno 2026 molti annunci partono da $850. La scheda è inferiore alla SXM3 per frequenza e banda passante della memoria, ma non richiede schede madri SXM speciali. Anche in questo caso sono necessari un’alimentazione adeguata e un raffreddamento forzato.
Conclusioni
Tesla V100 SXM3 32 GB supera la SXM2 per frequenze e banda passante della memoria, ma i suoi vantaggi si perdono quasi completamente di fronte alle difficoltà di collegamento.
Per il proprietario di un DGX-2 o di un server HGX-2, il modulo resta un utile componente di ricambio. Per un’assemblaggio autonomo, è interessante soltanto come esperimento, che richiede la verifica della compatibilità dell’adattatore, dell’alimentazione e del raffreddamento.
Se serve una V100 con 32 GB di memoria per le reti neurali locali, è più ragionevole scegliere una SXM2 con un adattatore collaudato oppure una versione PCIe già pronta. La SXM3 va acquistata solo in presenza di una piattaforma server compatibile o di un kit di collegamento funzionante e verificato.
Confronto di GPU
Confronta Tesla V100 SXM3 32 GB con altri GPUs
Di base
Specifiche della memoria
Display e multimedia
Prestazioni teoriche
Varie
Classifiche
Rispetto ad altre GPU
Condividi sui social media
Oppure linkaci
<a href="https://cputronic.com/index.php/it/gpu/nvidia-tesla-v100-sxm3-32-gb" target="_blank">NVIDIA Tesla V100 SXM3 32 GB</a>