NVIDIA Tesla V100 SXM2 32 GB
Tesla V100 SXM2 32 GB: molta memoria per le reti neurali, ma assemblaggio complesso
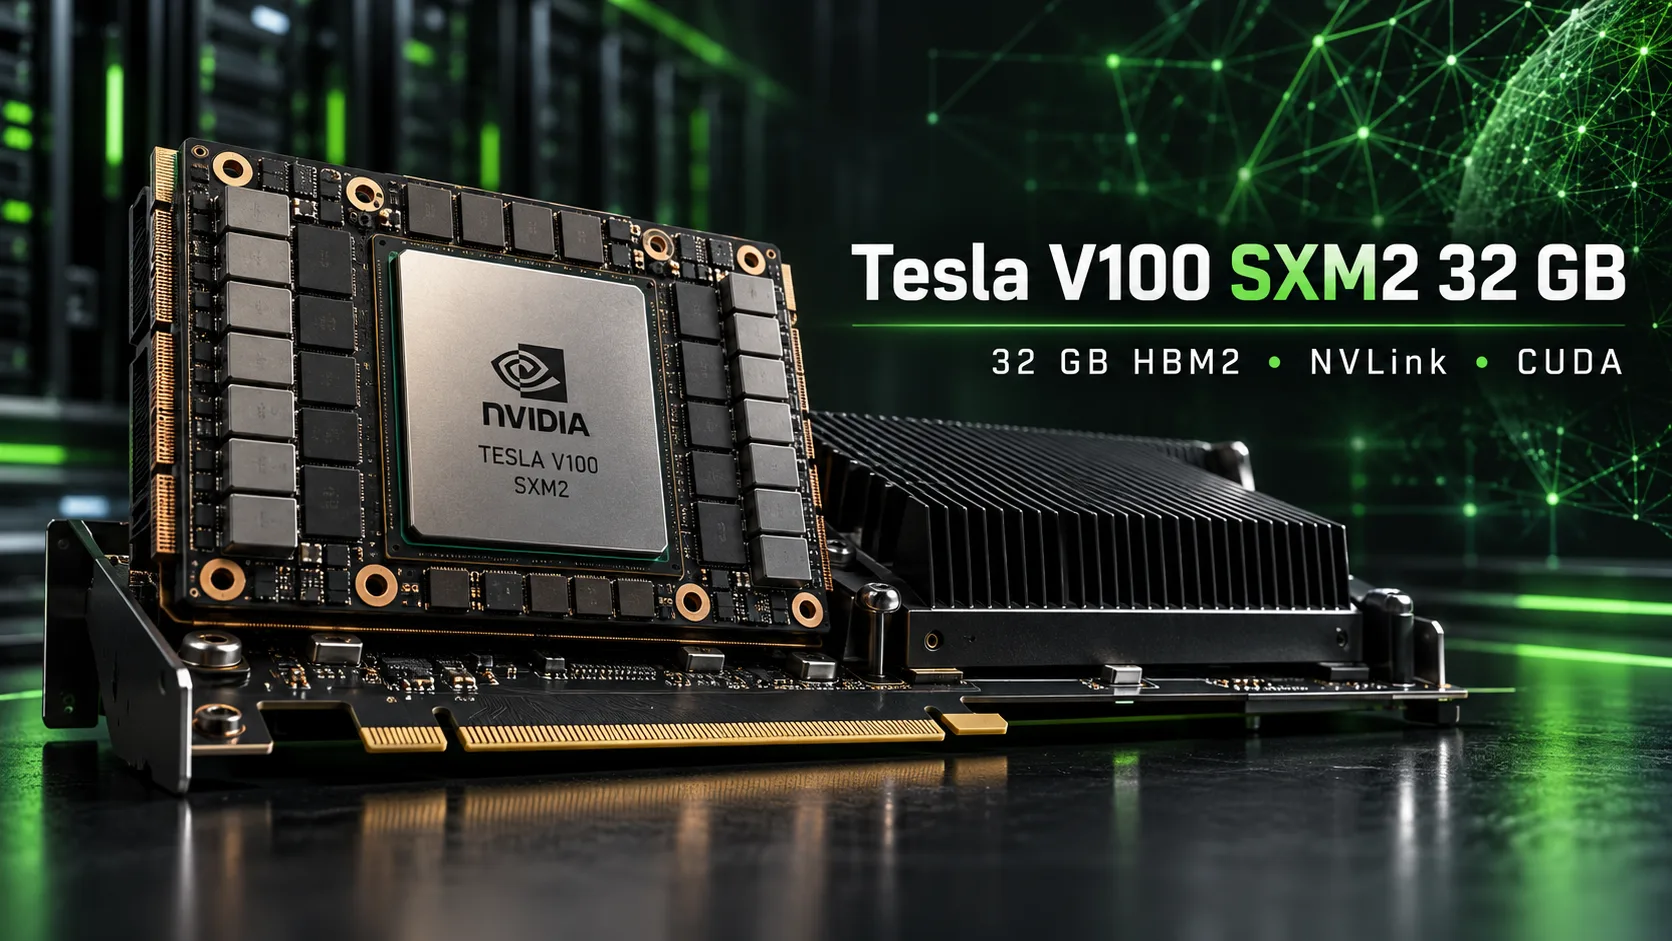
Tesla V100 SXM2 32 GB è un modulo di calcolo per server con 32 GB di memoria HBM2, che può essere collegato a un normale PC tramite un adattatore. Le sue prestazioni sono simili a quelle della Tesla V100 PCIe, ma consente di collegare più acceleratori tramite NVLink. Sul mercato dell’usato questi moduli a volte costano meno delle schede PCIe complete, anche se il risparmio dipende dal costo dell’adattatore e del sistema di raffreddamento.
NVIDIA ha presentato la versione da 32 GB nel marzo 2018. Il prezzo iniziale era di circa $11 500. Oggi i moduli vengono venduti dopo la dismissione dei server e attirano gli appassionati che hanno bisogno di più di 24 GB di memoria video per i modelli linguistici locali.
Tuttavia, SXM2 non si installa direttamente in uno slot PCIe e richiede alimentazione e raffreddamento separati. Un’ulteriore limitazione riguarda il supporto software: NVIDIA sta concludendo lo sviluppo dei driver per l’architettura Volta e CUDA 13 non supporta più la compilazione delle applicazioni per V100.
Posizione nella gamma
Tesla V100 SXM2 è basata sul die GV100 a 12 nm, con 5120 core CUDA e 640 Tensor Core. La memoria HBM2 è collegata tramite un bus a 4096 bit. Rispetto alla versione PCIe, il modulo differisce per frequenze, consumi e interfaccia.
| Modello | Memoria | Larghezza di banda | Boost | TDP | Interfaccia |
|---|---|---|---|---|---|
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | PCIe 3.0 x16 |
| Tesla V100 SXM2 16 GB | 16 GB HBM2 | 900 GB/s | 1530 MHz | 300 W | SXM2, NVLink 2.0 |
| Tesla V100 SXM2 32 GB | 32 GB HBM2 | 900 GB/s | 1530 MHz | 300 W | SXM2, NVLink 2.0 |
Le prestazioni dichiarate di SXM2 arrivano a 15,7 TFLOPS in FP32, 7,8 TFLOPS in FP64 e 125 TFLOPS sui Tensor Core in FP16.
Sei linee NVLink 2.0 garantiscono fino a 300 GB/s di larghezza di banda bidirezionale complessiva. È molto più di quanto offra PCIe 3.0, ma la velocità effettiva di scambio tra due GPU dipende dal numero di linee che le collegano.
I moduli sono stati utilizzati nei sistemi server NVIDIA DGX-1 e nelle configurazioni cloud AWS p3dn. Sul mercato dell’usato si trovano esemplari con i part number 699-2G503-0203-200 e 699-2G503-0204-200, oltre alle versioni server HPE P05912-001.
Come installare il modulo in un normale PC
Adattatore SXM2-PCIe. Le schede per un singolo modulo costano circa $60-100. Si collegano a PCIe 3.0 x16 e in genere richiedono alimentazione aggiuntiva tramite due connettori a 8 pin. Prima dell’acquisto è necessario verificare la compatibilità dell’adattatore proprio con V100 SXM2 e il relativo schema di alimentazione.
Un normale adattatore non offre il supporto NVLink. Con questo tipo di collegamento V100 funziona come acceleratore indipendente e i vantaggi di SXM2 si limitano alla frequenza più elevata e al limite di potenza dichiarato.
Schede per più moduli. Per collegare due o quattro V100 sono disponibili schede speciali con le linee NVLink instradate. Le varianti per due moduli si trovano a circa $300-500. In alcune configurazioni il collegamento alla scheda madre avviene tramite uno switch PCIe e cavi speciali.
Prima dell’acquisto è necessario verificare lo schema dei collegamenti tra i moduli: la presenza di due connettori SXM2 non garantisce di per sé il funzionamento di NVLink.
Raffreddamento. V100 SXM2 è progettata per un sistema di raffreddamento da server, quindi un normale dissipatore senza un flusso d’aria intenso non è sufficiente. Con un TDP di 300 W è necessario scegliere un dissipatore adatto, garantire un flusso d’aria direzionato e controllare le temperature durante i carichi prolungati.
Per gli assemblaggi domestici si utilizzano ventole separate con convogliatori, anche realizzati con una stampante 3D. Ridurre il limite di potenza tramite nvidia-smi aiuta a diminuire temperatura e rumore, ma può limitare le prestazioni.
Sistema operativo. Per un sistema domestico è preferibile Linux: è più semplice trovare istruzioni, driver e build specializzate. Anche Windows è supportato, comprese alcune configurazioni sperimentali con più V100, ma la compatibilità deve essere verificata separatamente.
In Linux è importante installare il modulo proprietario del driver NVIDIA. A partire dal ramo 560 viene proposto per impostazione predefinita il modulo open del kernel, che supporta solo le architetture Turing e successive. Non è adatto a Volta.
Prestazioni nei modelli linguistici
Un singolo modulo con 32 GB di memoria
Durante la generazione dei token, la velocità è spesso limitata dalla larghezza di banda della memoria video. SXM2 e PCIe offrono lo stesso valore, 900 GB/s, quindi in questi carichi il vantaggio di SXM2 è generalmente ridotto.
In un test dell’utente, su una singola V100 SXM2 32 GB il modello Qwen3.6-27B è stato eseguito in llama.cpp con diverse varianti di quantizzazione.
| Quantizzazione | Generazione, token/s |
|---|---|
| Q4_K_M | 32,2 |
| Q5_K_M | 29,1 |
| Q6_K | 25,1 |
| Q8_0 | 22,8 |
Il test è stato eseguito in un singolo thread, generando da 128 a 2048 token. Si tratta dei risultati di una configurazione specifica, non di una velocità garantita per qualsiasi V100.
Il vantaggio principale della versione da 32 GB è la possibilità di collocare interamente Qwen3.6-27B in Q8_0. Su una scheda video con 24 GB la memoria non è sufficiente per questa quantizzazione.
Tuttavia, i pesi Q8_0 occupano quasi tutta la memoria video disponibile. Per le conversazioni lunghe è preferibile scegliere Q4_K_M o Q5_K_M, lasciando più spazio alla cache KV.
Contesto lungo e build ottimizzate
Con un contesto lungo le prestazioni diminuiscono sensibilmente. Gli appassionati cercano di ridurre queste perdite modificando llama.cpp e utilizzando la decodifica speculativa MTP.
In un test pubblicato, con Qwen3.8-27B Q4_K_M su una singola V100 SXM2 32 GB sono stati ottenuti i seguenti risultati:
| Build di llama.cpp | Contesto 1k, token/s | Contesto 128k, token/s |
|---|---|---|
| Standard | 36,0 | 16,5 |
| Con patch per Volta, senza MTP | 35,2 | 23,8 |
| Con patch e MTP | 65,1 | 42,2 |
Con un contesto di 128 mila token, la build ottimizzata con MTP è risultata 2,6 volte più veloce di quella standard. Si tratta però del risultato di una configurazione speciale, che dipende dal modello, dalle richieste e dall’efficienza della decodifica speculativa.
Anche la cache del prompt accelera le sessioni agentiche composte da più passaggi. Nello stesso esperimento, il tempo di elaborazione di un singolo turno è diminuito da 22,94 a 3,08 secondi grazie al riutilizzo della cronologia già elaborata.
Più moduli e NVLink
Nei sistemi con più GPU i vantaggi di SXM2 diventano più evidenti. NVLink accelera lo scambio dei dati tra gli acceleratori e consente di utilizzare in modo più efficiente il parallelismo tensoriale.
Il parallelismo tensoriale è possibile anche tramite PCIe, ma lo scambio intenso di dati tra le GPU può limitarne la velocità.
| Configurazione | Carico | Risultato |
|---|---|---|
| 2× V100 SXM2 32 GB, NVLink, vLLM 0.6.4 | Qwen2.5-32B, 32 richieste simultanee | 206 token/s complessivi |
| 4× V100 SXM2 32 GB, fork di llama.cpp | Qwen3.8-Flash-Next 125B, contesto 16k | 42,2 token/s |
| 4× V100 SXM2 32 GB, stesso fork | Stesso modello, contesto 256k | 21,8 token/s |
Nel primo test è stata misurata la velocità complessiva di gestione di 32 richieste, non le prestazioni di una singola conversazione.
Nella configurazione con quattro V100 è stato utilizzato il modello MoE Qwen3.8-Flash-Next, con 125 miliardi di parametri principali e circa 6 miliardi di parametri attivi per token. La sua versione quantizzata, con un volume di circa 156 GiB, non entrava interamente nei 128 GiB di memoria video. Una parte dei dati si trovava nella memoria RAM del server.
L’esperimento è stato condotto su Windows Server 2022 con CUDA 12.8 e una versione modificata di llama.cpp. Dimostra le possibilità dell’hardware, ma richiede una configurazione molto più complessa rispetto all’esecuzione standard di un modello su una singola scheda video.
In un confronto di Level1Techs, una coppia di Radeon AI PRO R9700 32 GB in llama.cpp ha mostrato prestazioni massime complessive superiori del 32% rispetto a una coppia di V100. Tuttavia, utilizzando vLLM con parallelismo tensoriale, due V100 hanno raggiunto 206 token/s, superando del 58% il miglior risultato delle R9700 in quell’esperimento.
Il confronto riguarda versioni specifiche del software, il modello Qwen2.5-32B e l’elaborazione in batch di richieste brevi. Queste percentuali non possono essere trasferite ad altri modelli o a contesti lunghi.
Giochi e calcoli in FP64
Sebbene Tesla V100 sia destinata ai calcoli, gli appassionati hanno eseguito anche giochi sulla versione SXM2. In un test dell’utente, V100 SXM2 16 GB ha raggiunto circa 78 FPS in Cyberpunk 2077 alla risoluzione di 2560×1080 e con impostazioni elevate, senza upscaling né generazione dei fotogrammi.
Il modulo, tuttavia, non dispone di uscite video, ray tracing hardware né supporto DLSS. Per i giochi è necessaria una configurazione aggiuntiva del sistema e i 32 GB di HBM2 non offrono un vantaggio pratico rispetto alle schede video da gioco con prestazioni comparabili.
Nei calcoli a doppia precisione V100 raggiunge 7,8 TFLOPS in FP64, circa sei volte più della RTX 4090. Per questo il vecchio acceleratore rimane interessante per i calcoli scientifici che richiedono elevate prestazioni in FP64.
Supporto software
NVIDIA ha limitato il supporto dell’architettura Volta al ramo di driver R580. La manutenzione è prevista fino a giugno 2028, ma i rami successivi non sono già più progettati per V100.
CUDA 13 ha escluso la compilazione e il supporto delle librerie per Volta. L’ultima linea compatibile di CUDA Toolkit è la 12.x. Il driver R580 mantiene comunque la compatibilità con le applicazioni compilate per versioni precedenti di CUDA.
Il problema riguarda gradualmente anche il software per le reti neurali. Le nuove build pronte all’uso potrebbero non includere il codice per l’architettura sm_70, costringendo gli utenti a rimanere su versioni compatibili o a compilare autonomamente i programmi.
Attualmente V100 può essere utilizzata con llama.cpp, alcune build di PyTorch, versioni adattate di vLLM e progetti sperimentali per Volta. Tuttavia, le ottimizzazioni per le GPU moderne non sono sempre disponibili su questa generazione.
L’assenza del supporto hardware per BF16 e FP8 limita inoltre la scelta dei modelli e dei formati di calcolo.
Quanto costa V100 SXM2 32 GB
Nel 2018 Microway indicava per V100 SXM2 32 GB un prezzo di $11 458. Oggi i moduli nuovi non vengono più prodotti e il mercato dell’usato dipende fortemente dalle forniture di apparecchiature server dismesse.
Nell’ottobre 2026 su eBay si trovano le seguenti offerte:
| Hardware | Prezzo |
|---|---|
| Tesla V100 SXM2 32 GB, modulo singolo | $658-839 |
| Tesla V100 SXM2 16 GB, modulo singolo | $150-200 |
| Tesla V100 PCIe 32 GB | $650-900 |
| Adattatore SXM2-PCIe | $60-100 |
| Scheda per due SXM2 con NVLink | circa $300-500 |
| Dissipatore e ventola per SXM2 | circa $45-100 |
Si tratta dei prezzi di singoli annunci, non dei prezzi medi di vendita. Spedizione, tasse e compatibilità dei componenti possono modificare sensibilmente il costo finale.
Se si acquista una SXM2 32 GB a $658, si aggiungono un adattatore da $60 e un sistema di raffreddamento da $60, il totale è di circa $778, senza considerare la spedizione. A questo prezzo il risparmio rispetto a una V100 PCIe 32 GB completa non è più garantito.
La situazione cambia se si riesce a trovare il modulo a $350-400. In questo caso l’assemblaggio completo può costare circa $470-560, mantenendo un vantaggio significativo rispetto alla versione PCIe.
Per un sistema con due moduli il calcolo è ancora più complesso. Una scheda con NVLink, i cavi aggiuntivi, il sistema di raffreddamento e l’alimentatore possono aumentare sensibilmente il budget.
Concorrenti e alternative
Tesla V100 PCIe 32 GB. È l’alternativa più vicina, con la stessa quantità e la stessa larghezza di banda della memoria. La scheda si installa direttamente in PCIe, anche se il raffreddamento passivo richiede comunque un flusso d’aria direzionato. A parità di costo complessivo, la versione PCIe è preferibile per un acceleratore singolo.
Tesla V100 SXM2 16 GB. È molto più economica della variante da 32 GB. Con adattatore e raffreddamento, l’assemblaggio può costare circa $260-350. È adatta ai modelli quantizzati piccoli e medi, ma 16 GB limitano la scelta dei modelli e la lunghezza del contesto. Due moduli con NVLink offrono 32 GB di memoria complessiva, ma non si trasformano in uno spazio di indirizzamento unico per qualsiasi applicazione.
GeForce RTX 3090 24 GB. È una scheda video più versatile, con supporto hardware per BF16, librerie CUDA moderne e normale funzionamento in Windows. In alcuni carichi di elaborazione dei prompt è sensibilmente più veloce di V100. Su eBay si trovano offerte a partire da circa $1200, mentre il limite inferiore della maggior parte degli annunci a fine ottobre è intorno a $1600. Il principale svantaggio per i modelli più grandi sono i 24 GB di memoria invece di 32 GB.
AMD Instinct MI50 32 GB. È un’alternativa con 32 GB di HBM2 e una larghezza di banda di circa 1 TB/s. Su eBay le offerte partono da circa $650, anche se i prezzi su altri marketplace possono differire. Il problema principale è il supporto ROCm obsoleto e la configurazione più complessa del software di calcolo. Per llama.cpp si possono utilizzare build compatibili, comprese quelle basate su Vulkan, ma i programmi CUDA non funzioneranno senza adattamenti.
Vale la pena acquistarla?
Tesla V100 SXM2 32 GB è interessante per chi vuole eseguire modelli linguistici locali che richiedono più di 24 GB di memoria video ed è disposto a realizzare autonomamente il sistema di raffreddamento.
Con un prezzo del modulo fino a $350-400, l’acquisto può essere più conveniente di una V100 PCIe 32 GB anche considerando i componenti aggiuntivi. Se il costo dell’assemblaggio completo si avvicina a quello di una scheda PCIe, il vantaggio di SXM2 scompare quasi del tutto.
Per più acceleratori sono più interessanti le schede con NVLink. Accelerano lo scambio di dati tra le GPU e sono adatte agli esperimenti con il parallelismo tensoriale, ma richiedono costi e configurazioni più complessi.
I principali limiti di V100 SXM2 sono il raffreddamento, il consumo fino a 300 W, l’assenza dei moderni formati di calcolo e il supporto software in progressiva riduzione. Il modulo è ancora utilizzabile per LLM locali, calcoli scientifici ed esperimenti con CUDA.
Se serve una sola scheda video senza un assemblaggio complesso, è meglio scegliere V100 PCIe 32 GB. SXM2 è giustificata solo in presenza di un risparmio significativo o della necessità di utilizzare NVLink.
Confronto di GPU
Confronta Tesla V100 SXM2 32 GB con altri GPUs
Di base
Specifiche della memoria
Display e multimedia
Prestazioni teoriche
Varie
Classifiche
Rispetto ad altre GPU
Confronti tra GPU correlati


Condividi sui social media
Oppure linkaci
<a href="https://cputronic.com/index.php/it/gpu/nvidia-tesla-v100-sxm2-32-gb" target="_blank">NVIDIA Tesla V100 SXM2 32 GB</a>