NVIDIA Tesla V100 PCIe 32 GB
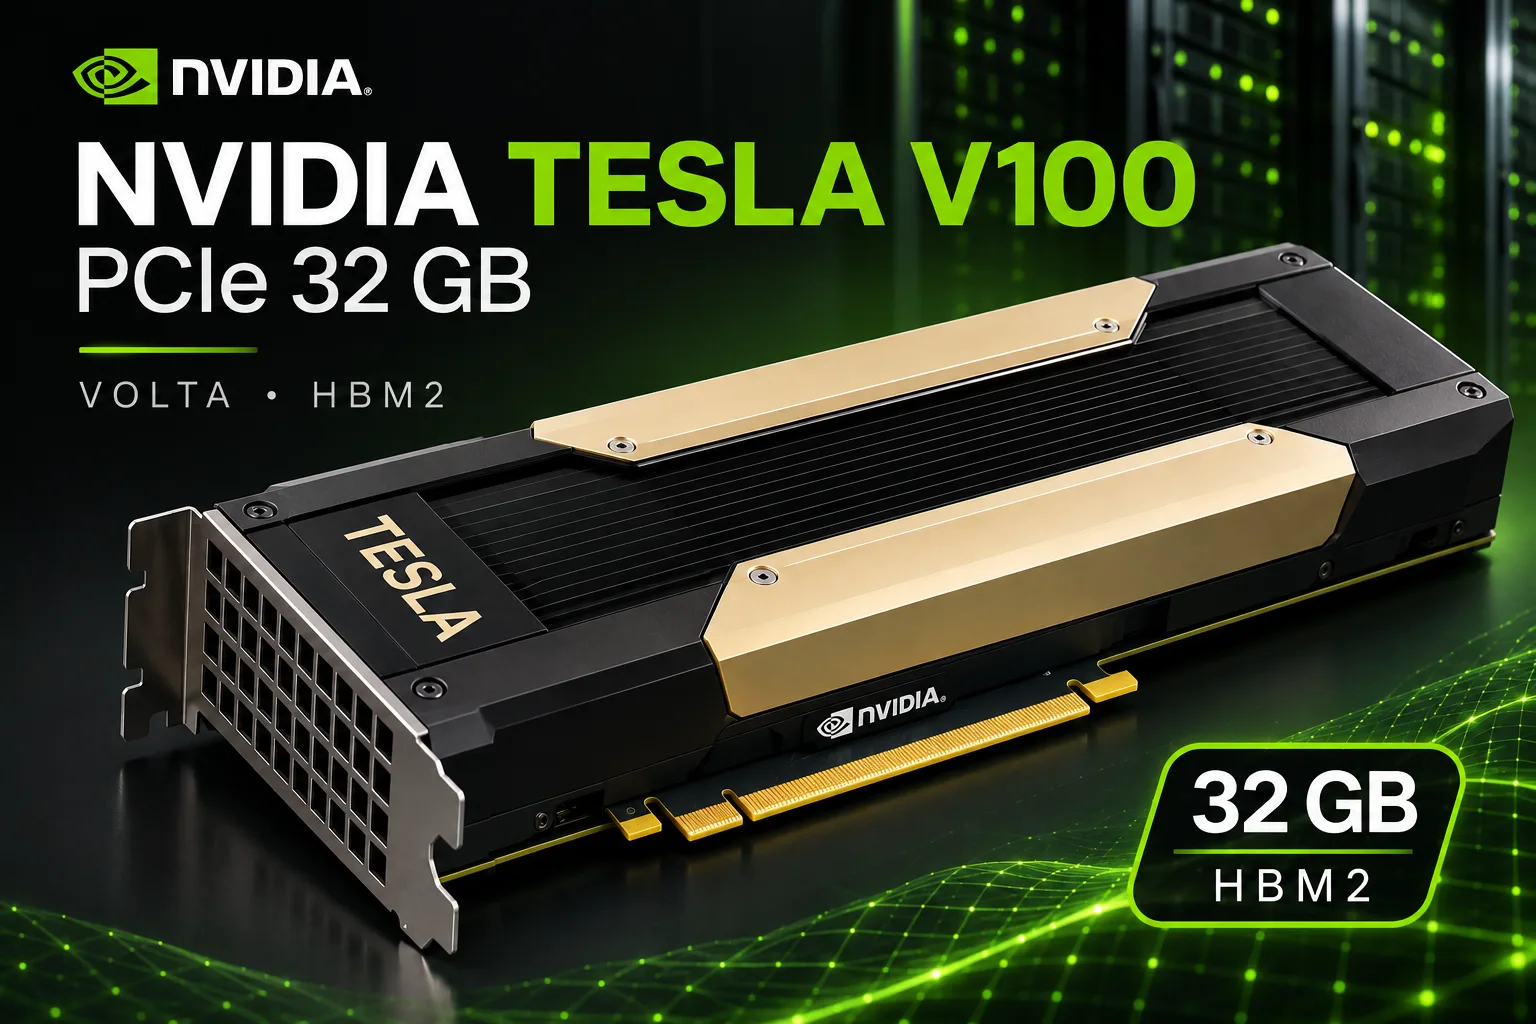
Tesla V100 PCIe 32 GB: memoria per modelli da 27 miliardi di parametri, ma con un sovrapprezzo per il connettore PCIe
Tesla V100 PCIe 32 GB è la versione dell’acceleratore server V100 con il doppio della memoria. NVIDIA l’ha lanciata nel marzo 2018 a un prezzo di circa $11 500. Oggi le schede dismesse vengono vendute su eBay a circa $700.
Il die, le frequenze e la larghezza di banda di 900 GB/s sono gli stessi della versione da 16 GB. Ma nel 2026 conta soprattutto la capacità. I 32 GB sono sufficienti per modelli densi da 27-32 miliardi di parametri con quantizzazione a 4 bit e contesto lungo, sui quali la V100 raggiunge circa 30 token al secondo.
Gli svantaggi sono due. Volta è rimasta senza nuovi driver e senza CUDA 13. Inoltre, la versione PCIe costa quasi tre volte più della variante da 16 GB e sensibilmente più del modulo SXM2 della stessa capacità.
Posizione nella gamma
Tutte le V100 sono basate sul die GV100: processo produttivo TSMC a 12 nm, 5120 CUDA core e 640 Tensor Core di prima generazione, quattro stack HBM2 su un bus a 4096 bit. Le versioni da 32 GB e i modelli più vicini sono:
| Modello | Memoria | Larghezza di banda | Boost | TDP | Caratteristiche |
|---|---|---|---|---|---|
| Tesla V100 PCIe 16 GB | 16 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | la stessa scheda con metà della memoria |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | dissipatore passivo, senza NVLink e uscite video |
| Tesla V100 SXM2 32 GB | 32 GB HBM2 | 900 GB/s | 1530 MHz | 300 W | connettore server SXM2, NVLink |
| Tesla V100S PCIe 32 GB | 32 GB HBM2 | 1134 GB/s | 1601 MHz | 250 W | aggiornamento del 2019 |
| Quadro GV100 | 32 GB HBM2 | 870 GB/s | 1627 MHz | 250 W | uscite video, driver professionale |
Le prestazioni dichiarate della versione PCIe sono di 14 TFLOPS in FP32, 7 TFLOPS in FP64 e 112 TFLOPS sui Tensor Core. I Tensor Core funzionano solo con FP16. Su Volta non sono presenti RT Core, BF16 né TF32.
Negli annunci la stessa scheda reference compare con diversi codici prodotto: PNY TCSV100M-32GB-PB, Dell 490-BENZ e 0HR5WD, HPE Q9U36A, Lenovo 4X67A12088, Cisco UCSC-GPU-V100-32=.
Prestazioni
Modelli linguistici
La velocità di generazione dei token è limitata dalla larghezza di banda della memoria. Per questo, sui modelli più piccoli la V100 da 32 GB funziona esattamente come quella da 16 GB. Misurazioni degli sviluppatori di llama.cpp sulla stessa versione del codice:
| Scheda | Memoria | gpt-oss 20B, prompt (pp2048), tok/s | gpt-oss 20B, generazione (tg128), tok/s | Llama 8B Q4_0, generazione, tok/s |
|---|---|---|---|---|
| Tesla P40 | 24 GB GDDR5 | 1362 | 65 | 52 |
| Instinct MI50/MI60 | 32 GB HBM2 | 1066 | 144 | - |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 2436 | 151 | 128 |
| GeForce RTX 3090 | 24 GB GDDR6X | 5824 | 210 | 155 |
| GeForce RTX 4090 | 24 GB GDDR6X | 13 127 | 264 | 179 |
| GeForce RTX 5090 | 32 GB GDDR7 | 21 011 | 412 | 282 |
Su gpt-oss 20B la V100 genera il 28% più lentamente della RTX 3090 e alla pari con la scheda AMD. Il test non specifica se abbia partecipato una MI50 o una MI60. La V100 elabora il prompt 2,3 volte più velocemente della scheda AMD, ma 2,4 volte più lentamente della 3090.
Questa scheda viene acquistata per i 32 GB, destinati a modelli densi da 27 miliardi di parametri. Di seguito sono riportati i risultati degli utenti: llama.cpp, una richiesta, senza accelerazioni. Le righe con SXM2 valgono anche per la versione PCIe: la memoria è la stessa e la generazione è limitata proprio da essa. Sono direttamente confrontabili le righe con Qwen3.6 27B Q4_K_M.
| Configurazione | Modello e quantizzazione | Generazione, tok/s | Prompt, tok/s |
|---|---|---|---|
| V100 PCIe 32 GB | Qwen3.8 27B, UD-Q4_K_XL | 33,4 | 826 |
| V100 SXM2 32 GB | Qwen3.6 27B, Q4_K_M | 32,2 | - |
| V100 SXM2 32 GB | Qwen3.6 27B, Q8_0 | 22,8 | - |
| RTX 5090 | Qwen3.6 27B, Q4_K_M | 77 | - |
Una velocità di 32-33 token al secondo su un modello da 27B a 4 bit è sufficiente per chat e attività agentiche. La RTX 5090 è 2,4 volte più veloce, ma costa quasi 9 volte di più.
Le tecniche software incidono più della scelta tra PCIe e SXM2. Con MTP, cioè la previsione di più token per ogni passaggio, Qwen3.8 27B passa da 33 a 57 token al secondo. L’incremento è maggiore sul codice e minore sulla prosa. In un singolo flusso, il fork di vLLM è il 10% più lento di llama.cpp. In compenso, con quattro richieste simultanee raggiunge complessivamente 110 token al secondo, contro 75,7.
Con l’aumentare del contesto, la velocità diminuisce: da 33,4 token al secondo con contesto vuoto a 28 con 32 mila token e 15,8 con 131 mila. Bisogna tenere sotto controllo anche il raffreddamento. Un proprietario ha rilevato che la scheda scendeva a 15,7 token al secondo finché non ha portato al massimo la velocità delle ventole del server.
In uno dei test la V100 si è dimostrata più efficiente della RTX 4070. Su Qwen3.5 4B ha prodotto 107 token al secondo a 154 W, mentre la 4070 ha raggiunto 91 token a 173 W, cioè il 30% di token in meno per joule. La 4070 elabora il prompt più velocemente: 5860 token al secondo contro 4445.
Addestramento, calcoli e giochi
I 32 GB permettono di fare il fine-tuning in FP16 di modelli più grandi, ma senza BF16 e FlashAttention 2 le moderne pipeline di addestramento devono essere rielaborate. Secondo le misurazioni di Lambda sulle versioni SXM2, A100 è da 1,6 a 3,4 volte più veloce nell’addestramento.
In FP64 la V100 è ancora molto forte. I suoi 7 TFLOPS sono circa cinque volte quelli della RTX 4090, mentre i 32 GB sono sufficienti per grandi griglie destinate alla CFD e alla dinamica molecolare.
La scheda non è adatta ai giochi. Non dispone di uscite video, DLSS o ray tracing e le sue prestazioni sono leggermente inferiori a quelle della RTX 4060 Ti.
Supporto software
Il ramo di driver R580 è l’ultimo con supporto a Volta. CUDA 13 non compila per questa architettura, quindi rimane CUDA 12.x. Le build precompilate di llama.cpp e LM Studio stanno gradualmente perdendo il supporto alla V100. Un proprietario ha constatato che la quantizzazione della cache KV è passata silenziosamente alla CPU proprio a causa dell’assenza di Volta in CUDA 13.
La piattaforma è mantenuta in vita dagli appassionati: fork di vLLM per sm_70, il port di ExLlamaV3 e build di llama.cpp con MTP. Per gli esperimenti domestici è sufficiente. In un sistema di produzione dipenderete da quanto a lungo gli autori continueranno a supportarle.
Prezzi e dove acquistarla
Le V100 nuove non vengono più prodotte da tempo; oggi la scheda è disponibile solo usata.
| Offerta | Configurazione | Prezzo |
|---|---|---|
| eBay USA, limite inferiore (ottobre 2026) | V100 PCIe 32 GB | ~$685-695 |
| eBay USA, media degli annunci attivi | V100 PCIe 32 GB | ~$920 |
| Amazon / Newegg (ottobre 2026) | V100 PCIe 32 GB | $799 / $839 |
| Singoli venditori esteri | V100 PCIe 32 GB | $400-500 |
| Modulo SXM2 + adattatore | V100 SXM2 32 GB | ~$250-600 |
| IT Creations | V100S PCIe 32 GB | $8937 |
| TechMikeNY, Dell PowerEdge R740 | server con una V100 PCIe 32 GB | $12 156 |
Il limite inferiore su eBay è quasi invariato dall’inizio dell’anno: circa $707 a febbraio, circa $685 oggi. La scheda si trova a meno di $500 solo presso singoli venditori esteri. Questi lotti, come quelli più economici su eBay, normalmente non includono alcuna garanzia. Al prezzo bisogna aggiungere una ventola con convogliatore: senza il flusso d’aria di un server, il dissipatore passivo si surriscalda.
I rivenditori e gli assemblatori di server chiedono un ordine di grandezza in più. In una configurazione server si paga soprattutto per processori, memoria e unità di archiviazione.
Concorrenti e alternative
Tesla V100 SXM2 32 GB con adattatore. Lo stesso die e la stessa capacità, frequenza superiore del 10%, per $250-600 insieme all’adattatore. Gli svantaggi sono l’assemblaggio fai da te, la ventola di serie rumorosa e i 300 W sotto carico. Per un PC domestico è il modo più economico per ottenere 32 GB di HBM2.
Due V100 PCIe da 16 GB. Circa $470 per gli stessi 32 GB. llama.cpp dividerà il modello tra i vari layer e la generazione rimarrà al livello di una sola scheda. Servono due slot x16 e un alimentatore con un margine di 500 W.
GeForce RTX 3090. Nella generazione è più veloce del 20-40%, elabora il prompt 2,4 volte più rapidamente e offre inoltre BF16, FlashAttention e driver con supporto. Un modello 27B a 4 bit entra nei suoi 24 GB, ma con meno margine per il contesto; un 32B in Q5-Q6 invece non ci sta più. Costa circa $1386, il doppio della V100.
GeForce RTX 5090. Gli stessi 32 GB e una velocità molto superiore. A causa della carenza di memoria costa da $6000, a fronte di un prezzo consigliato di $1999. Sono circa $190 per gigabyte contro i $22 della V100.
AMD Instinct MI50 32 GB. Generazione allo stesso livello della V100, mentre l’elaborazione del prompt è più lenta di oltre due volte. Costa $120-210 presso i fornitori su Alibaba e $500-650 su eBay. Funzionano in modo stabile su questa scheda soprattutto llama.cpp e il PyTorch di base.
Conclusioni
Secondo gli standard moderni, la V100 PCIe 32 GB è un acceleratore di calcolo lento con una memoria ampia e veloce. È sufficiente per mantenere in memoria un modello da 27-32 miliardi di parametri con contesto lungo e lavorarci a un ritmo confortevole. I limiti emergono con i prompt lunghi, l’addestramento e il software. La scheda non è adatta ai sistemi di produzione.
Un prezzo ragionevole per la versione PCIe è fino a $450-500. Agli attuali $700 è meno conveniente del modulo SXM2 da 32 GB con adattatore. Il sovrapprezzo della PCIe è giustificato solo se la scheda viene installata in un server rack come il Dell R740 o l’HPE DL380: lì non è possibile montare l’adattatore e il flusso d’aria di serie risolve il problema del raffreddamento.
Se 24 GB sono sufficienti e serve velocità con un supporto software adeguato, conviene spendere qualcosa in più per una RTX 3090. Se invece serve la massima memoria al minimo prezzo, sono più convenienti la V100 SXM2 32 GB o la MI50.
Confronto di GPU
Confronta Tesla V100 PCIe 32 GB con altri GPUs
Di base
Specifiche della memoria
Display e multimedia
Prestazioni teoriche
Varie
Classifiche
Rispetto ad altre GPU
Confronti tra GPU correlati


Condividi sui social media
Oppure linkaci
<a href="https://cputronic.com/index.php/it/gpu/nvidia-tesla-v100-pcie-32-gb" target="_blank">NVIDIA Tesla V100 PCIe 32 GB</a>