NVIDIA Tesla V100 PCIe 16 GB
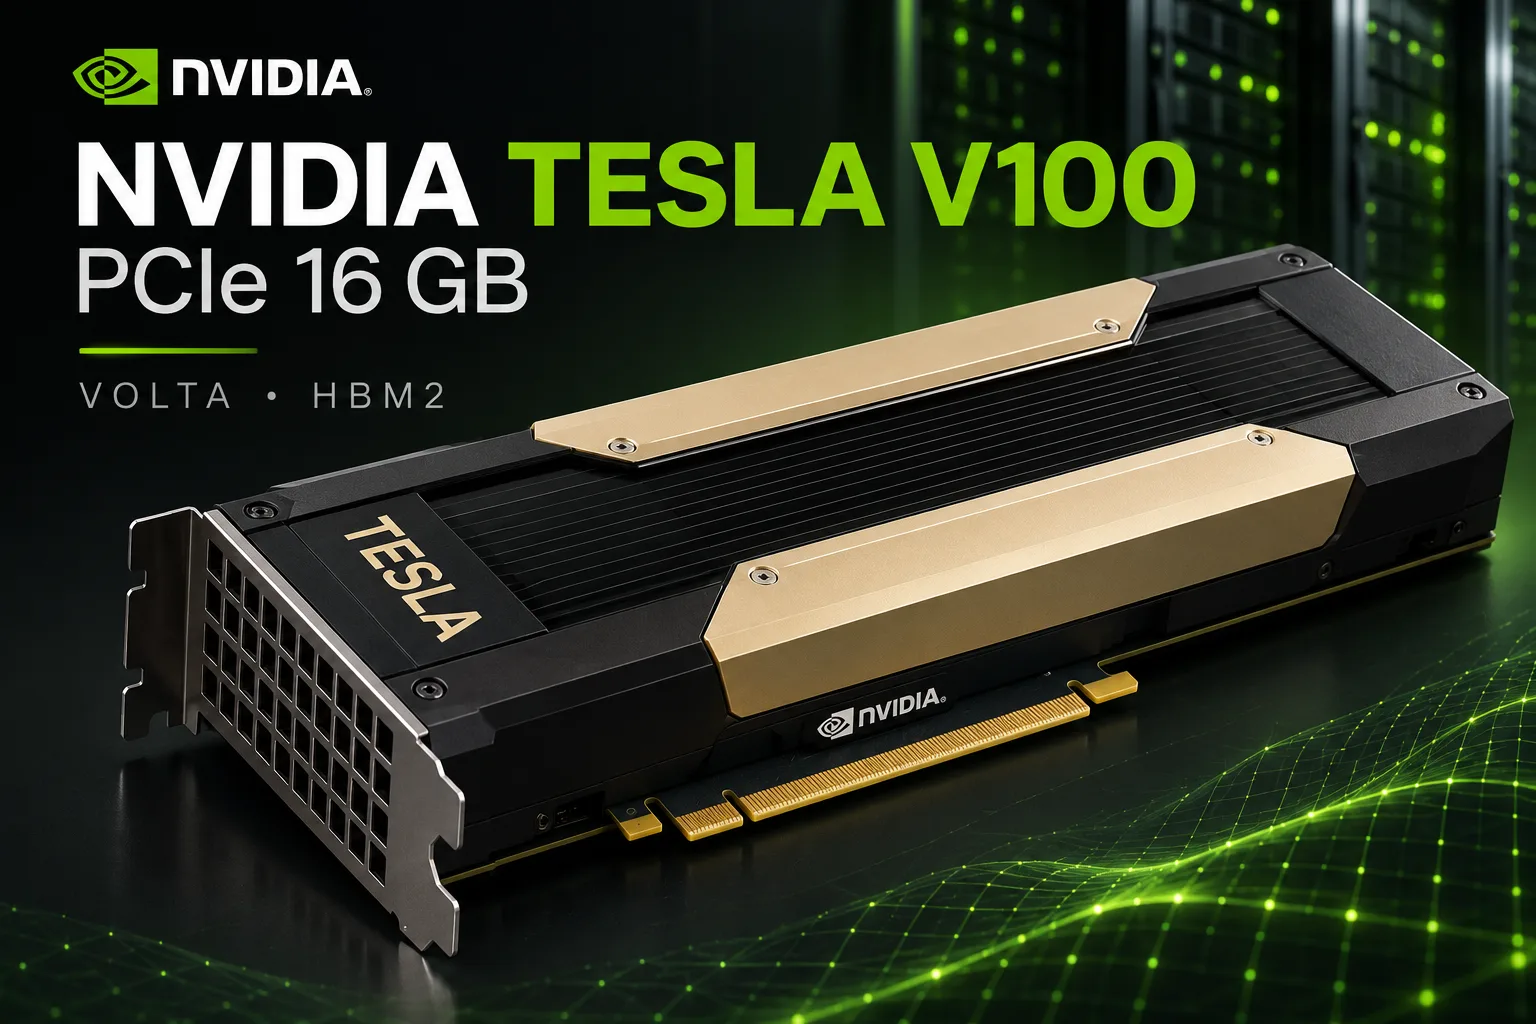
Tesla V100 PCIe 16 GB: 900 GB/s di HBM2 a poco prezzo, ma con supporto CUDA limitato
Tesla V100 PCIe 16 GB è un acceleratore server del 2017, ancora interessante per le reti neurali locali e i calcoli scientifici. Il suo principale punto di forza è la memoria HBM2 con una larghezza di banda di 900 GB/s, quasi pari a quella della GeForce RTX 3090. Sul mercato dell’usato la scheda costa alcune centinaia di dollari, anche se le offerte più economiche spesso riguardano moduli SXM2 e non vere schede PCIe.
Il prezzo contenuto impone alcuni compromessi. La V100 non dispone di uscite video né di ray tracing hardware, 16 GB di memoria non bastano per i modelli linguistici di grandi dimensioni e il supporto alle versioni più recenti di CUDA è terminato. NVIDIA ha lasciato Volta nel ramo di driver R580, il cui supporto proseguirà fino alla metà del 2028. Per eseguire gli LLM moderni è sempre più spesso necessario individuare autonomamente versioni compatibili dei vari software.
Posizione nella gamma
Tesla V100 è basata sul die GV100 con una superficie di 815 mm², prodotto con il processo produttivo TSMC FFN a 12 nm. Degli 84 streaming multiprocessor, 80 sono attivi, per un totale di 5120 CUDA core e 640 tensor core di prima generazione. I quattro stack di HBM2 sono collegati tramite un bus a 4096 bit.
Sulla base del GV100, NVIDIA ha prodotto diversi acceleratori con quantità di memoria, frequenze e interfacce differenti.
| Modello | Memoria | Larghezza di banda | Boost | TDP | Caratteristiche |
|---|---|---|---|---|---|
| Tesla V100 PCIe 16 GB | 16 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | PCIe 3.0 x16, senza NVLink |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | Quantità di memoria raddoppiata |
| Tesla V100 SXM2 16/32 GB | 16/32 GB HBM2 | 900 GB/s | 1530 MHz | 300 W | SXM2, supporto NVLink |
| Tesla V100S PCIe 32 GB | 32 GB HBM2 | 1134 GB/s | 1601 MHz | 250 W | HBM2 più veloce |
| Titan V | 12 GB HBM2 | 653 GB/s | 1455 MHz | 250 W | Uscite video, bus a 3072 bit |
| Quadro GV100 | 32 GB HBM2 | 870 GB/s | 1627 MHz | 250 W | Grafica professionale |
La versione PCIe da 16 GB raggiunge 14 TFLOPS in FP32, 7 TFLOPS in FP64 e 112 TFLOPS nei calcoli tensoriali FP16. Sono valori leggermente inferiori a quelli della SXM2, che dispone di una frequenza e di un limite di potenza superiori.
Volta è stata la prima architettura NVIDIA a introdurre i tensor core. Tuttavia, questi supportano soltanto FP16 e non funzionano con BF16, TF32 e FP8. L’assenza di questi formati limita l’efficienza delle librerie e dei modelli moderni. Anche il GV100 non dispone di RT core hardware.
Prestazioni
Modelli linguistici locali
Durante la generazione dei token, le prestazioni sono spesso limitate dalla velocità di lettura dei pesi dalla memoria video. Per questo motivo, la V100, con i suoi 900 GB/s, rimane competitiva anche rispetto a GPU molto più recenti.
Per un confronto si può utilizzare la tabella dei risultati di Llama 2 7B con quantizzazione Q4_0 pubblicata dagli sviluppatori di llama.cpp. La tabella misura la velocità di elaborazione di un prompt di 512 token e la generazione di 128 token senza FlashAttention.
| Scheda video | Memoria | Elaborazione del prompt, token/s | Generazione, token/s |
|---|---|---|---|
| Tesla P40 | 24 GB GDDR5 | 1007 | 55 |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 3043 | 129 |
| GeForce RTX 3090 | 24 GB GDDR6X | 5175 | 158 |
| GeForce RTX 4090 | 24 GB GDDR6X | 11 993 | 186 |
| GeForce RTX 5090 | 32 GB GDDR7 | 14 073 | 290 |
I risultati sono stati raccolti dai test di utenti diversi. Il modello e i parametri principali sono gli stessi, ma le versioni di llama.cpp, i driver e le configurazioni dei sistemi possono differire.
Nella tabella è stata testata una V100 PCIe 32 GB. La versione da 16 GB ha le stesse frequenze e la stessa larghezza di banda HBM2, mentre il modello occupa meno di 4 GB. Per questo ci si aspetta una prestazione simile, anche se qui non è disponibile una misurazione diretta della versione da 16 GB.
In fase di generazione, la V100 è più lenta della RTX 3090 di circa il 18%, mentre nell’elaborazione del prompt il divario è del 41%. Per una conversazione breve la differenza non è sempre significativa, ma diventa più evidente durante l’elaborazione di documenti voluminosi e di una cronologia conversazionale lunga.
La RTX 4090 elabora il prompt quasi quattro volte più velocemente della V100, anche se nella generazione il vantaggio è soltanto del 44%. Questo dimostra perché la sola larghezza di banda della memoria non determina le prestazioni in tutte le attività.
Il principale limite della V100 PCIe 16 GB è la quantità di memoria. La scheda è adatta ai modelli da 7-14 miliardi di parametri con quantizzazione a 4 bit. I modelli da 27-32 miliardi di parametri richiedono solitamente lo scaricamento parziale nella memoria RAM oppure una compressione più aggressiva. In entrambi i casi è necessario accettare compromessi in termini di velocità, qualità o lunghezza del contesto.
Addestramento e calcoli scientifici
V100 è stata progettata soprattutto per l’addestramento delle reti neurali e per il calcolo ad alte prestazioni. I tensor core FP16 rimangono utili, ma i nuovi acceleratori hanno ricevuto formati di calcolo più efficienti, cache più grandi e librerie ottimizzate.
I limiti sono particolarmente evidenti durante l’addestramento di modelli che utilizzano BF16. La V100 non supporta questo formato a livello hardware, quindi non tutte le configurazioni moderne di PyTorch e di altri framework possono essere trasferite su Volta senza modifiche.
Nei calcoli a doppia precisione, invece, la scheda conserva un vantaggio significativo rispetto alle GeForce da gioco. Le sue prestazioni raggiungono 7 TFLOPS in FP64, circa 5,4 volte più della RTX 4090.
Per la dinamica molecolare, la modellazione numerica e altre attività HPC, V100 rimane interessante se il software utilizzato supporta Volta. Tuttavia, l’elevata velocità nominale in FP64 non garantisce di per sé un vantaggio equivalente in un programma specifico.
È possibile giocare con Tesla V100?
La V100 PCIe non dispone di uscite video. Per visualizzare le immagini è necessaria un’altra scheda video oppure la grafica integrata del processore. In Windows è inoltre necessario scegliere un driver compatibile e configurare l’avvio dei giochi sull’acceleratore di calcolo.
Gli appassionati hanno verificato le capacità di gioco della V100 SXM2 16 GB tramite un adattatore PCIe. In un sistema con Ryzen 7 5700GE, la scheda ha ottenuto i seguenti risultati con impostazioni elevate, senza upscaling né generazione dei fotogrammi.
| Gioco | 2560×1080, FPS medi | 3440×1440, FPS medi |
|---|---|---|
| Cyberpunk 2077 | ~78 | ~56 |
| Hogwarts Legacy | ~55-60 | ~40 |
| Atomic Heart | ~115 | ~75-80 |
| Red Dead Redemption 2 | ~80 | ~65 |
In Cyberpunk 2077, il consumo energetico dell’acceleratore era di circa 181 W. I risultati mostrano che Volta è ancora in grado di gestire i giochi moderni, anche se l’assenza di DLSS e del ray tracing hardware ne limita notevolmente le possibilità.
È importante sottolineare che si tratta di test della SXM2, non della PCIe. La SXM2 raggiunge una frequenza Boost di 1530 MHz contro i 1380 MHz della PCIe e ha un limite di potenza superiore di 50 W. Per questo la versione PCIe potrebbe essere più lenta. Senza misurazioni separate non è possibile determinare la differenza in FPS.
Acquistare una V100 appositamente per giocare non è conveniente. Una GeForce tradizionale è più semplice da installare, supporta le moderne tecnologie grafiche e non richiede una scheda video aggiuntiva per visualizzare le immagini.
Installazione in un computer comune
A differenza della SXM2, Tesla V100 PCIe si collega direttamente a uno slot PCIe x16 standard. Tuttavia, installarla in un PC domestico richiede comunque una certa preparazione.
Alimentazione. La V100 PCIe di riferimento dispone di un connettore CPU EPS12V a 8 pin. È diverso dal normale connettore PCIe a 8 pin. NVIDIA consente di collegare un cavo EPS12V adeguato oppure di utilizzare un adattatore speciale con connettori PCIe.
Prima della prima accensione è necessario verificare il pinout e il carico massimo consentito dai cavi. Non bisogna collegare un cavo inadatto solo perché il connettore sembra uguale.
Raffreddamento. La scheda è dotata di un dissipatore passivo progettato per un flusso d’aria intenso all’interno di un server. In un normale case sarà necessaria una ventola separata con un flusso d’aria diretto.
Senza un raffreddamento adeguato, l’acceleratore può ridurre le frequenze o surriscaldarsi. È necessario controllare non solo la temperatura del core, ma anche la stabilità operativa sotto carico prolungato.
Consumi. Il limite nominale è di 250 W. Tramite nvidia-smi è possibile ridurre la potenza consentita, per esempio fino a 180 W. Questo ridurrà il calore prodotto e i requisiti di raffreddamento, ma l’impatto sulle prestazioni dipende dall’attività.
Supporto software: il limite principale
NVIDIA ha confermato che R580 sarà l’ultimo ramo di driver con supporto a Maxwell, Pascal e Volta. Per gli acceleratori server, appartiene alla linea con supporto a lungo termine, la cui manutenzione terminerà nel giugno 2028.
CUDA 13 non consente più di compilare applicazioni per l’architettura Volta con capacità di calcolo sm_70. L’ultima linea compatibile di CUDA Toolkit è la 12.x, inclusa la versione 12.9.
La V100, tuttavia, non ha smesso di funzionare dopo l’uscita di CUDA 13. I programmi compilati con supporto a Volta nelle versioni precedenti di CUDA continuano ad avviarsi con driver compatibili.
Il problema riguarda le nuove versioni dei programmi e delle librerie:
- llama.cpp. Il codice sorgente consente di compilare versioni compatibili con sm_70, ma le nuove ottimizzazioni potrebbero non supportare Volta.
- PyTorch. Per la V100 è necessario scegliere build con supporto a CUDA 12.x e alle corrispondenti architetture di calcolo.
- LM Studio e Ollama. La compatibilità dipende dalla versione dell’applicazione e dal CUDA runtime incluso. Alcune funzioni potrebbero richiedere build più vecchie.
- FlashAttention 2. L’implementazione CUDA standard è progettata per architetture più recenti, quindi sulla V100 è necessario utilizzare meccanismi alternativi per l’elaborazione dell’attenzione.
Per gli esperimenti domestici è una situazione accettabile: è possibile conservare un ambiente compatibile e aggiornarlo selettivamente. Per un server di produzione, invece, i limiti sono più seri, perché le nuove versioni dei framework smettono progressivamente di supportare Volta.
Prezzi sul mercato dell’usato
Il prezzo della V100 varia notevolmente in base alla versione. I moduli SXM2 economici finiscono spesso nei risultati generici della ricerca di Tesla V100, anche se non è possibile installarli in un PC senza un adattatore.
Secondo il riepilogo delle offerte su eBay del 28 ottobre 2026, la situazione è la seguente:
| Scheda video | Fascia minima delle offerte | Mediana degli annunci |
|---|---|---|
| Tesla V100 PCIe 16 GB, versione passiva | $329 | $422 |
| Tesla V100 SXM2 16 GB | $191 | $300 |
| Tesla V100 SXM2 32 GB | $842 | $990 |
| Tesla V100 PCIe 32 GB, versione passiva | $860 | $960 |
| GeForce RTX 3090 24 GB | $1651 | $1970 |
I prezzi si riferiscono agli annunci attivi e non alle transazioni concluse. Alcune Tesla V100 PCIe 16 GB sono state vendute per circa $240-275, ma tali offerte non possono essere considerate sicuramente disponibili.
Per la versione PCIe da 16 GB è ragionevole considerare un prezzo di $300-350 per una scheda funzionante e verificabile. Intorno ai $400, l’acquisto diventa meno interessante, soprattutto se sono necessari anche un sistema di raffreddamento e un cavo di alimentazione.
Il costo di un sistema domestico completo può risultare sensibilmente superiore al prezzo del solo acceleratore. Per questo il confronto della V100 con le alternative dovrebbe tenere conto di tutti i componenti.
Concorrenti e alternative
Tesla V100 SXM2 16 GB. Il modulo in sé costa meno della versione PCIe, ma richiede un adattatore, un sistema di alimentazione e un raffreddamento separato. Il costo complessivo può risultare paragonabile a quello di una scheda PCIe completa. Per una singola GPU, il vantaggio della SXM2 di solito non giustifica la complessità dell’assemblaggio. Il discorso cambia per le schede multi-modulo con NVLink.
Tesla V100 PCIe 32 GB. Offre la stessa architettura di calcolo e la stessa larghezza di banda della memoria, ma il doppio della HBM2. È molto più adatta ai modelli linguistici da 27-32 miliardi di parametri. Tuttavia, con un prezzo di $800-1000, il vantaggio economico della vecchia architettura non è più così evidente.
GeForce RTX 3090 24 GB. È più veloce nell’elaborazione dei prompt, supporta BF16, le ottimizzazioni CUDA moderne e il ray tracing hardware. I suoi 24 GB consentono di lavorare con modelli più grandi rispetto alla V100 16 GB. Sul mercato dell’usato si trovano annunci a partire da circa $1200, anche se la maggior parte delle offerte è più costosa. È una scheda più versatile, ma il sovrapprezzo è significativo.
GeForce RTX 5060 Ti 16 GB. Offre un’architettura più recente, il supporto alle librerie attuali, uscite video, DLSS 4 e la garanzia del produttore. La larghezza di banda della memoria è inferiore: 448 GB/s contro i 900 GB/s della V100. Tuttavia, non è possibile prevedere direttamente la velocità degli LLM sulla base di questa differenza: i core di calcolo moderni e le ottimizzazioni software possono compensare la minore larghezza di banda. Per i giochi e l’uso quotidiano, RTX 5060 Ti è preferibile.
AMD Instinct MI50 32 GB. È un’alternativa con il doppio della HBM2, una larghezza di banda di circa 1 TB/s e prestazioni FP64 elevate. I prezzi dei singoli annunci partono da circa $650. Il principale limite è il supporto ROCm in fase di obsolescenza e la difficoltà di utilizzo con il software di calcolo moderno. Per i programmi progettati per CUDA, la V100 è solitamente più semplice.
Tesla P40 24 GB. È una scheda più vecchia con GDDR5 e 24 GB di memoria. Nel test di llama.cpp genera circa 55 token/s contro i 129 della V100. Tuttavia, gli 8 GB aggiuntivi consentono di eseguire modelli che non entrano nella V100 16 GB. Per questo la P40 rimane un’alternativa quando la quantità di memoria è più importante della velocità.
Conviene acquistare Tesla V100 PCIe 16 GB?
Tesla V100 PCIe 16 GB rimane interessante per le reti neurali locali, i calcoli scientifici e gli esperimenti con CUDA. Per alcune centinaia di dollari, l’acquirente ottiene una larghezza di banda della memoria di 900 GB/s, 640 tensor core e 7 TFLOPS in FP64.
Tuttavia, i 16 GB limitano la scelta dei modelli linguistici e il supporto software a Volta si sta progressivamente riducendo. La scheda richiede un raffreddamento diretto, un’alimentazione adeguata e una scelta attenta delle versioni di driver e librerie.
A un prezzo fino a $300-350, Tesla V100 PCIe 16 GB può essere considerata un buon acquisto per un sistema di calcolo domestico. Se la scheda costa $400 o più, è necessario confrontarla con la SXM2 16 GB, la P40 24 GB e acceleratori più moderni, tenendo conto dei costi di installazione.
Per i modelli fino a 14 miliardi di parametri, le capacità della V100 sono generalmente sufficienti. Se l’obiettivo è eseguire localmente modelli da 27-32 miliardi di parametri senza scaricarli nella memoria RAM, è meglio prendere subito in considerazione una scheda video con 24-32 GB di memoria.
La V100 va acquistata per specifiche attività di calcolo, non come scheda video universale. Le sue prestazioni sono ancora sufficienti per molti esperimenti, ma nei prossimi anni non sarà più possibile contare sul pieno supporto del nuovo software.
Confronto di GPU
Confronta Tesla V100 PCIe 16 GB con altri GPUs
Di base
Specifiche della memoria
Display e multimedia
Prestazioni teoriche
Varie
Classifiche
Rispetto ad altre GPU
Confronti tra GPU correlati


Condividi sui social media
Oppure linkaci
<a href="https://cputronic.com/index.php/it/gpu/nvidia-tesla-v100-pcie-16-gb" target="_blank">NVIDIA Tesla V100 PCIe 16 GB</a>