NVIDIA Tesla P100 SXM2
NVIDIA Tesla P100 SXM2: una GPU server economica, ma difficile da installare in un PC comune
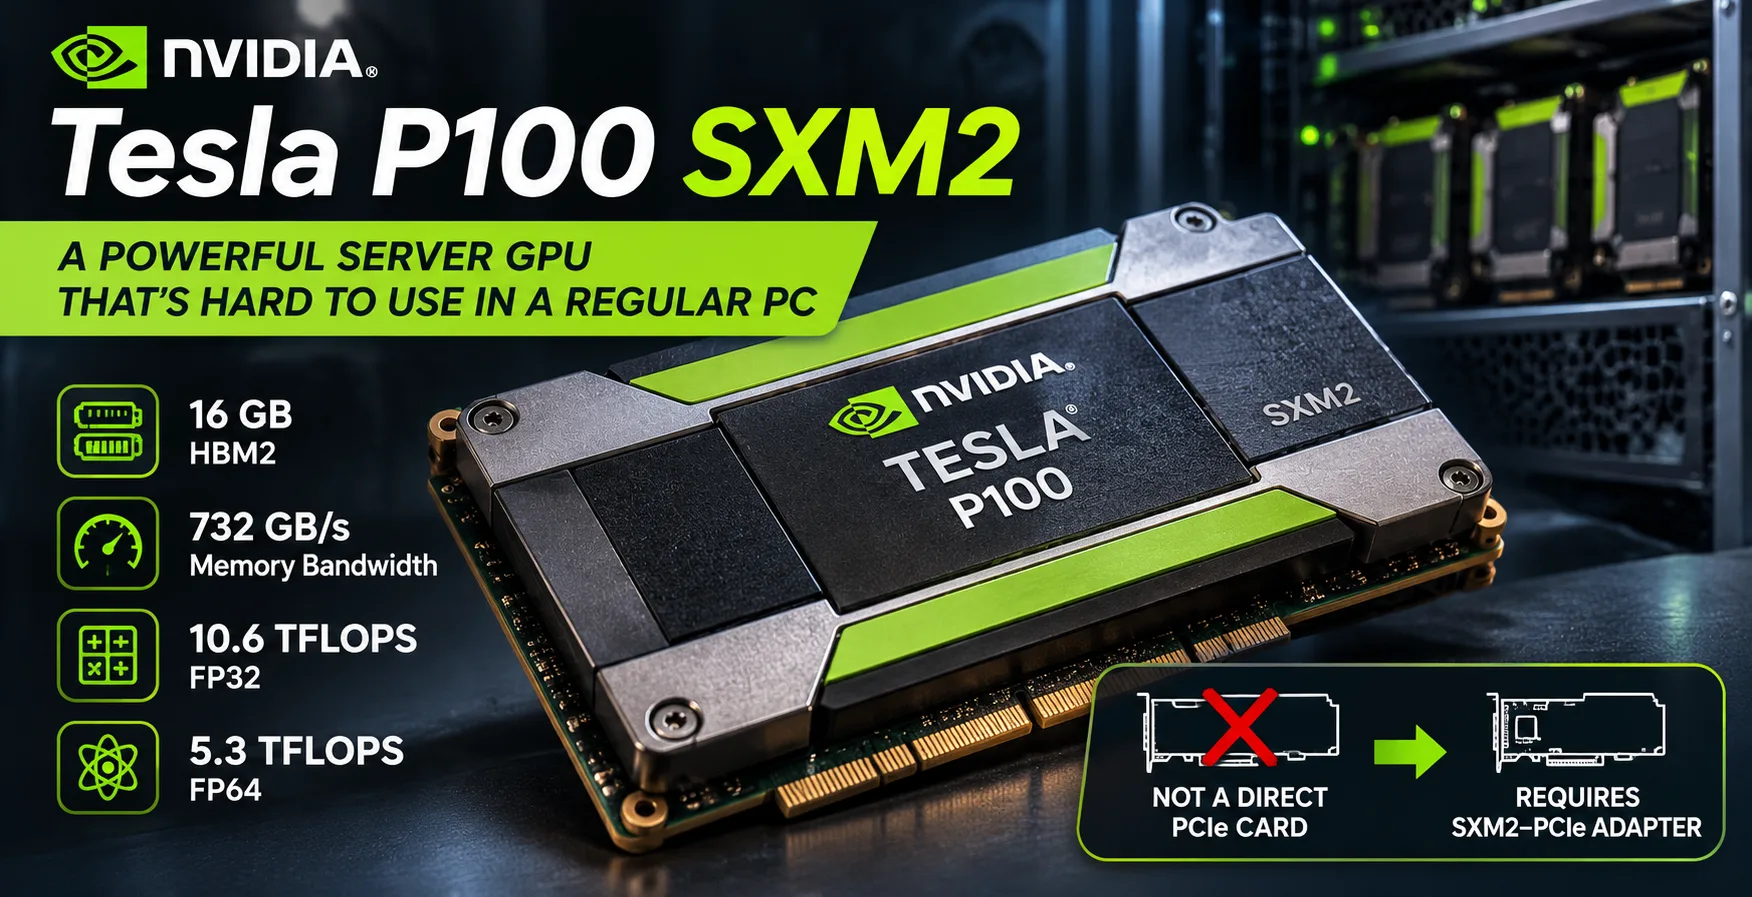
La NVIDIA Tesla P100 SXM2 attira gli appassionati grazie alla combinazione di 16 GB di memoria HBM2, elevate prestazioni in FP64 e prezzo contenuto sul mercato dell’usato. Tuttavia, questo acceleratore del 2016 presenta un grave inconveniente: invece del connettore PCIe standard utilizza il connettore server SXM2. Per installarlo in un computer comune servono un adattatore, un sistema di raffreddamento separato e una verifica della compatibilità. Di conseguenza, il modulo economico può costare più di una versione PCIe più semplice da utilizzare.
Perché è difficile collegare SXM2 a un PC comune
La Tesla P100 SXM2 è stata progettata per server specializzati, compresi i sistemi NVIDIA DGX. Non dispone di un connettore PCIe standard e non può essere installata direttamente nello slot della scheda madre.
Sul mercato dell’usato si trovano adattatori da SXM2 a PCIe, ma la presenza del connettore adatto non garantisce di per sé il funzionamento. Prima dell’acquisto è necessario risolvere diversi aspetti:
- Alimentazione. L’acceleratore consuma fino a 300 W. L’adattatore deve fornire al modulo l’alimentazione necessaria.
- Raffreddamento. SXM2 è progettato per un sistema di raffreddamento server. In un case comune serve un dissipatore compatibile con un flusso d’aria sufficientemente potente.
- Compatibilità. È necessario verificare il supporto dello specifico modulo da parte dell’adattatore, della scheda madre e del driver.
- Assenza di uscite video. La Tesla P100 non è progettata per il collegamento diretto di un monitor.
I costi aggiuntivi possono annullare completamente il vantaggio dell’acquisto. Secondo una stima del mercato dell’usato statunitense per agosto 2026, i moduli P100 SXM2 funzionanti venivano venduti a circa $47-60. A settembre, invece, uno degli adattatori SXM2-PCIe con supporto dichiarato per P100 era offerto a circa $109, senza considerare i costi aggiuntivi per il raffreddamento e la spedizione.
In un esempio del genere, il costo dell’adattatore è quasi il doppio di quello dell’acceleratore stesso. Perciò non ha senso valutare l’acquisto di una SXM2 considerando soltanto il prezzo del modulo.
Differenze tra Tesla P100 SXM2 e P100 PCIe
Entrambe le versioni sono basate sulla stessa GPU GP100 con architettura Pascal. Dispongono di 3584 CUDA core ciascuna, mentre le varianti con 16 GB di HBM2 offrono la stessa larghezza di banda della memoria, pari a 732 GB/s.
Le differenze principali riguardano frequenze, alimentazione e collegamento.
| Caratteristica | Tesla P100 SXM2 | Tesla P100 PCIe 16 GB |
|---|---|---|
| Collegamento | SXM2 | PCIe 3.0 x16 |
| Frequenza base | 1328 MHz | 1126 MHz |
| Frequenza Boost | 1480 MHz | 1303 MHz |
| Interconnessione GPU | NVLink, fino a 160 GB/s | PCIe 3.0 |
| Potenza massima | 300 W | 250 W |
Le frequenze più elevate garantiscono alla SXM2 un vantaggio di circa il 14% nelle prestazioni di calcolo teoriche FP32. Tuttavia, la potenza massima è superiore di 50 W.
Un altro vantaggio della SXM2 è NVLink, che consente agli acceleratori di scambiarsi dati. Questa funzione è utile nei server multiprocessore compatibili. Quando viene installata tramite un normale adattatore PCIe, però, il vantaggio di NVLink viene perso.
Per un singolo acceleratore in un PC desktop, i vantaggi della SXM2 rispetto alla PCIe sono relativamente ridotti.
Prestazioni e benchmark
La GP100 si distingue dalla maggior parte delle GPU consumer per l’elevata velocità dei calcoli in virgola mobile a doppia precisione FP64. Nella Tesla P100 SXM2 raggiunge 5,3 TFLOPS, rendendo l’acceleratore adatto ai calcoli scientifici e alla modellazione numerica.
Per il confronto sono stati utilizzati i risultati di Geekbench 7 OpenCL e le prestazioni di calcolo teoriche di alcune specifiche schede video.
| Scheda video | Geekbench 7 OpenCL | FP32, TFLOPS | FP64, TFLOPS |
|---|---|---|---|
| NVIDIA Tesla V100 SXM2 16 GB | 152 601 | 15,7 | 7,8 |
| NVIDIA GeForce RTX 3060 | 88 251 | 12,7 | 0,20 |
| NVIDIA Tesla P100 SXM2 16 GB | 87 454 | 10,6 | 5,3 |
| NVIDIA Tesla P100 PCIe 16 GB | 71 673 | 9,3 | 4,7 |
| NVIDIA Tesla T4 16 GB | 61 276 | 8,1 | ~0,25 |
Geekbench 7 OpenCL: risultati della classifica pubblica di Geekbench per ottobre 2026; un punteggio più alto è migliore. FP32 e FP64 sono valori teorici, non risultati di Geekbench. Sono riportati per confrontare le capacità di calcolo delle architetture.
In Geekbench, la P100 SXM2 ottiene circa il 22% di punti in più rispetto alla versione PCIe da 16 GB. La differenza è più evidente di quanto lascino intendere le specifiche dichiarate, ma i risultati sono stati ottenuti su sistemi diversi e non consentono di considerare garantito un incremento di questo tipo.
La situazione è più interessante nel confronto con la GeForce RTX 3060. I punteggi delle due schede in Geekbench sono praticamente identici, mentre in FP64 la Tesla server supera teoricamente la RTX 3060 di oltre 26 volte. Il motivo è la configurazione specializzata delle unità di calcolo della GP100, progettata anche per i carichi scientifici.
Tuttavia, risultati OpenCL simili non significano prestazioni equivalenti nei giochi, nel rendering o nelle reti neurali.
La Tesla V100 SXM2 è sensibilmente più veloce della P100 grazie all’architettura Volta, al maggior numero di unità di calcolo e alla più elevata larghezza di banda della memoria. Inoltre, la V100 integra i Tensor Core, assenti in Pascal.
Per quali attività è ancora adatta la P100 SXM2
Nonostante l’età, la GP100 non può essere considerata inutile. Conserva alcuni vantaggi nei carichi di lavoro capaci di sfruttare le caratteristiche dell’architettura:
- Calcoli scientifici e modellazione con uso intensivo di FP64.
- Calcoli CUDA con software compatibile.
- Elaborazione di grandi quantità di dati, per la quale è utile l’elevata larghezza di banda della HBM2.
- Esperimenti con GPU server e configurazioni multiprocessore NVLink.
Nelle operazioni FP16, la P100 SXM2 raggiunge teoricamente 21,2 TFLOPS. Tuttavia, questo valore non deve essere confrontato direttamente con le prestazioni dei Tensor Core degli acceleratori più moderni. Le differenze nell’architettura e nell’insieme di operazioni supportate sono troppo ampie.
Modelli linguistici locali e limiti di CUDA nel 2026
La presenza di 16 GB di memoria video rende la P100 interessante per l’esecuzione locale di modelli linguistici. Per esempio, modelli quantizzati con 7-8 miliardi di parametri possono essere caricati interamente nella memoria dell’acceleratore con impostazioni adeguate.
Tuttavia, la quantità di memoria è soltanto una delle caratteristiche che determinano la praticità d’uso degli LLM.
La GP100 appartiene all’architettura Pascal, con compute capability CUDA 6.0. L’ultima versione di CUDA Toolkit a supportare la compilazione di programmi per Pascal è la 12.9. In CUDA 13 il supporto a questa architettura durante la compilazione di nuove applicazioni è stato interrotto. L’ultimo ramo dei driver NVIDIA con supporto a Pascal è R580.
Questo non significa che i vecchi programmi abbiano smesso improvvisamente di funzionare. Tuttavia, le versioni più recenti delle librerie di machine learning possono richiedere un’architettura più moderna. Per eseguire alcuni modelli è necessario installare versioni meno recenti del software oppure compilare autonomamente componenti compatibili.
L’assenza dei Tensor Core limita la velocità dei moderni calcoli per le reti neurali. Perciò una P100 SXM2 con i suoi 16 GB di HBM2 non è necessariamente più veloce di una RTX consumer con una quantità inferiore di memoria.
Per gli LLM locali è più importante verificare il supporto dello specifico modello e dell’ambiente software, invece di basarsi sui valori FP16 o sulla larghezza di banda della memoria.
Vale la pena acquistare una Tesla P100 SXM2 nel 2026?
Se si dispone già di un server con connettori SXM2 compatibili, la Tesla P100 rimane adatta ai calcoli FP64 e all’utilizzo di software CUDA meno recente. Il prezzo contenuto sul mercato dell’usato la rende interessante per sistemi di questo tipo.
In un normale computer desktop, la situazione è diversa. L’incremento delle prestazioni rispetto alla P100 PCIe è ridotto, mentre i costi per adattatore, raffreddamento e alimentazione possono superare il prezzo dell’acceleratore stesso.
Per gli esperimenti con gli LLM locali è più comodo utilizzare una GeForce RTX più moderna, dotata di Tensor Core e compatibile con il software attuale. Se invece serve proprio l’architettura GP100, la versione PCIe da 16 GB evita la necessità di cercare un adattatore SXM2, anche se richiede comunque un potente flusso d’aria diretto.
Conclusione: la Tesla P100 SXM2 è ancora un acceleratore FP64 dalle prestazioni elevate, ma rappresenta una scelta poco adatta per una build economica basata su un normale PC. L’acquisto è giustificato se si dispone di hardware compatibile o per un esperimento tecnico. Risparmiare sull’acquisto del modulo per poi spendere di più per collegarlo, in genere, non conviene.
Confronto di GPU
Confronta Tesla P100 SXM2 con altri GPUs
Di base
Specifiche della memoria
Display e multimedia
Prestazioni teoriche
Varie
Classifiche
Rispetto ad altre GPU
Confronti tra GPU correlati

Condividi sui social media
Oppure linkaci
<a href="https://cputronic.com/index.php/it/gpu/nvidia-tesla-p100-sxm2" target="_blank">NVIDIA Tesla P100 SXM2</a>