NVIDIA Tesla P100 PCIe 12 GB
Tesla P100 PCIe 12 GB: calcolatrice FP64 da 80 dollari con data di dismissione
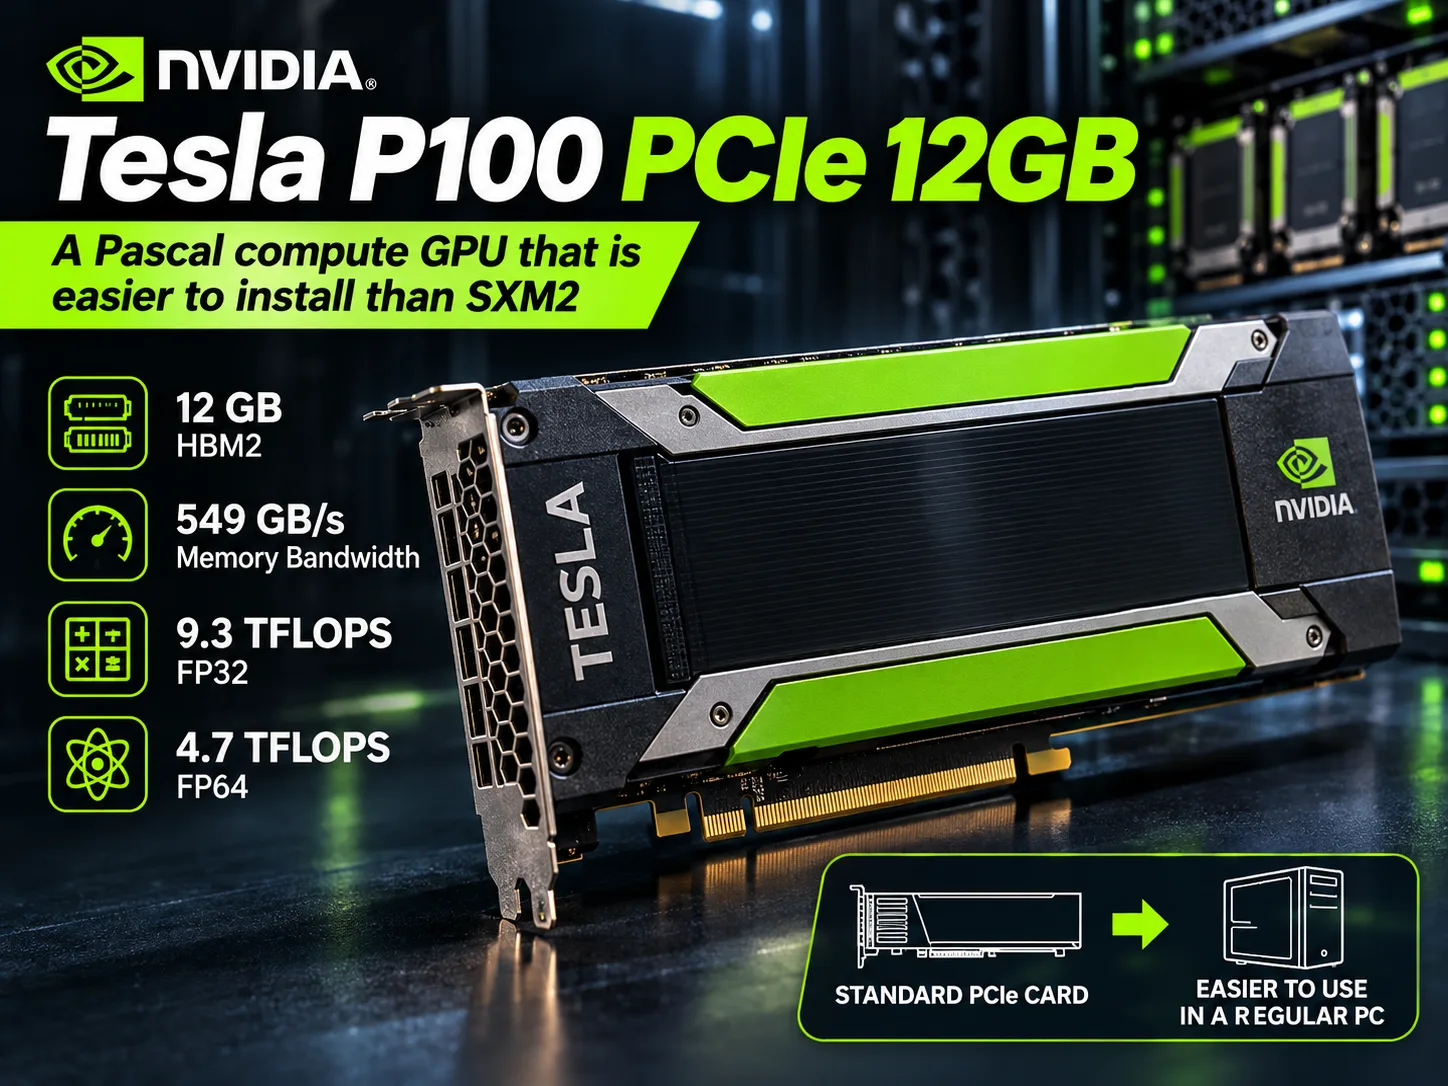
Tesla P100 è il primo acceleratore NVIDIA basato sull’architettura Pascal e, nel 2016-2017, era una delle schede principali per i supercomputer e l’addestramento delle reti neurali. All’epoca, la versione PCIe da 12 GB costava circa $4600. Oggi queste schede provengono da server dismessi e vengono vendute su eBay a $70-140, meno di una scheda video da gioco economica.
La si compra per la doppia precisione e la memoria HBM2. In FP64 raggiunge 4,7 TFLOPS, più di una RTX 4090. La versione più piccola è svantaggiata sul fronte della memoria: uno dei quattro stack HBM2 è disattivato, quindi capacità e banda passante sono inferiori di un quarto rispetto alla P100 da 16 GB. L’intero supporto software per Pascal terminerà insieme al ramo di driver R580, a metà del 2028.
Posizione nella gamma e architettura
Tutte le Tesla P100 sono costruite sul GP100, un die a 16 nm da 610 mm² montato su un interposer CoWoS insieme a quattro stack HBM2. Dei 3840 CUDA core del chip completo, nella P100 ne sono attivi 3584. La versione PCIe opera a 1190-1329 MHz con un TDP di 250 W.
La versione da 12 GB è la stessa scheda con uno stack di memoria disattivato. Il chip e le frequenze non sono cambiati, quindi la potenza di calcolo è identica a quella del modello superiore.
| Modello | Memoria | Bus | Banda passante | FP64 | FP16 | TDP |
|---|---|---|---|---|---|---|
| Tesla P100 PCIe 12 GB | 12 GB HBM2 | 3072 bit | 549 GB/s | 4,7 TFLOPS | 18,7 TFLOPS | 250 W |
| Tesla P100 PCIe 16 GB | 16 GB HBM2 | 4096 bit | 732 GB/s | 4,7 TFLOPS | 18,7 TFLOPS | 250 W |
| Tesla P100 SXM2 | 16 GB HBM2 | 4096 bit | 732 GB/s | 5,3 TFLOPS | 21,2 TFLOPS | 300 W |
| Tesla P40 | 24 GB GDDR5 | 384 bit | 347 GB/s | 1/32 di FP32 | 1/64 di FP32 | 250 W |
Il chip GP100 non è arrivato sulle GeForce. Il suo parente più vicino per le workstation è la Quadro GP100, dotata di uscite video. GTX 1080 Ti e Tesla P40 sono basate su un altro die, il GP102. Il GP100 calcola in FP64 alla metà della velocità dell’FP32 e in FP16 al doppio della velocità; nel GP102 entrambe le modalità sono praticamente ridotte a zero. Il GP100, però, con compute capability 6.0, non dispone delle istruzioni DP4A per il prodotto scalare intero, presenti nel GP102. Per le reti neurali quantizzate, questo si è rivelato più importante di quanto sembrasse nel 2016.
La P100 non ha Tensor Core. Sono comparsi nel 2017 con la Tesla V100 basata sull’architettura Volta.
Prestazioni
La scheda non è adatta ai giochi. Non dispone di uscite video e gli appassionati che hanno provato a visualizzare l’immagine attraverso una seconda scheda video lamentano i driver per datacenter e sconsigliano la P100 per il gaming. Dove invece continua a essere utile è nei modelli linguistici locali e nei calcoli in doppia precisione.
Tabella riepilogativa della community di llama.cpp per CUDA (Llama 2 7B, Q4_0, senza Flash Attention):
| Acceleratore | Memoria | Elaborazione del prompt, tok/s | Generazione, tok/s |
|---|---|---|---|
| RTX 3090 | 24 GB GDDR6X | 5174 | 158 |
| Tesla V100 | 32 GB HBM2 | 3043 | 129 |
| RTX 2080 Ti | 11 GB GDDR6 | 2890 | 107 |
| GTX 1080 Ti | 11 GB GDDR5X | 1084 | 62 |
| Tesla P100 PCIe 16 GB | 16 GB HBM2 | 761 | 58,4 |
| Tesla P40 | 24 GB GDDR5 | 1007 | 54,7 |
| Tesla T4 | 16 GB GDDR6 | 1219 | 46,4 |
La P100 genera testo a un livello paragonabile a quello della GTX 1080 Ti e della P40. Elabora il prompt 3,8 volte più lentamente della RTX 2080 Ti ed è più lenta della stessa P40. Con richieste brevi in chat è un limite accettabile, ma con documenti lunghi il modello impiega sensibilmente più tempo a “leggere” il testo prima di rispondere.
Un test di ComputingForGeeks condotto su una versione aggiornata di llama.cpp nell’ottobre 2026 ha mostrato lo stesso risultato. Con Qwen3 8B in Q4_K_M, la P100 da 16 GB ha raggiunto 38,4 tok/s contro i 47 della P40, nonostante la memoria della P100 sia due volte più veloce. Il motivo è l’assenza di DP4A: con compute capability 6.0, i kernel quantizzati di llama.cpp seguono un percorso lento.
Per questo, il bus ridotto della versione da 12 GB incide poco sui modelli linguistici. Nel test con Llama 2 7B, la P100 da 16 GB raggiunge circa 220 GB/s, meno di un terzo della sua banda passante di picco: è quindi limitata dai calcoli. Non esistono misurazioni separate della versione più piccola con llama.cpp, ma sui modelli di dimensioni ridotte la sua velocità di generazione dovrebbe essere vicina a quella del modello da 16 GB. Il problema dei 12 GB è la capacità: gpt-oss-20b e i modelli densi più grandi di 14B non entrano nella memoria.
Con l’FP64 la situazione è opposta. Una RTX 4090 raggiunge circa 1,3 TFLOPS in doppia precisione, mentre la RTX 3090 offre un valore dieci volte inferiore a quello della P100. Le schede server della generazione successiva sono le uniche relativamente vicine: la V100 PCIe con 7 TFLOPS e la AMD Instinct MI50 con 6,6 TFLOPS. Nei calcoli in cui l’FP64 è limitato dalla memoria, per esempio nei metodi a griglia e nella fluidodinamica, la versione da 12 GB sarà più lenta del modello superiore fino al 25%.
Risultati in sistemi specifici
Esistono pochissimi test pubblicati proprio sulla versione da 12 GB, quindi la tabella include anche i risultati del modello da 16 GB con lo stesso chip.
| Sistema | Configurazione | Versione P100 | Test | Risultato |
|---|---|---|---|---|
| Uniwide RB228H | 2× Xeon E5-2699 v4 | PCIe 12 GB | SPEC ACCEL OpenCL, base | 5,15 |
| Server di hosting Database Mart | 2× Xeon E5-2660 v2, 128 GB DDR3 | PCIe 16 GB | Ollama, Llama 2 7B | 49,7 tok/s |
| Nodo noleggiato su vast.ai | n/d | PCIe 16 GB | llama.cpp, Qwen3 8B Q4_K_M | 38,4 tok/s |
La differenza tra 49,7 e 38,4 tok/s è spiegata dal modello e dalla quantizzazione, non dal server. Se il modello entra interamente nella memoria video, il processore incide poco sulla velocità di generazione e persino una piattaforma con Xeon E5 v2 del 2013 non rallenta la scheda.
In idle, la P100 consuma 28 W e la P40 11 W. Sotto carico LLM, il consumo di picco della P100 arriva a 211 W.
Dove si trova, prezzi e disponibilità
Non vengono venduti dispositivi nuovi con la P100. A suo tempo la scheda era disponibile come opzione per i server Dell PowerEdge R730, R740, C4130 e C4140, Cisco UCS C240 M5 e C220 M5SX e HPE ProLiant. È da questi sistemi che arriva sul mercato dell’usato, di solito senza cavi.
| Variante | Condizioni | Prezzo |
|---|---|---|
| Tesla P100 PCIe 12 GB | usata, lotti numerosi | $70-100 |
| Tesla P100 PCIe 12 GB | usata, testata e con reso | $110-165 |
| Tesla P100 PCIe 16 GB | usata, lotti dalla Cina | $118-130 |
| Tesla P100 PCIe 16 GB | ricondizionata, Amazon | circa $155 |
Per installare la scheda in un normale PC bisogna acquistare alcuni componenti aggiuntivi:
| Cosa serve | Perché | Prezzo |
|---|---|---|
| Convogliatore e ventola a turbina | il raffreddamento è passivo | da $20, più la ventola |
| Adattatore per 8-pin EPS | è un connettore per processori, non PCIe | circa $13 |
| Grafica integrata o seconda scheda video | non ci sono uscite video | - |
Nel BIOS deve essere attivata l’opzione Above 4G Decoding. Non è possibile installare una P100 nello stesso sistema di una scheda Blackwell: richiedono moduli del kernel NVIDIA diversi. Alla fine, una P100 da 12 GB pronta per l’uso viene a costare $110-150.
Concorrenti e alternative
Tesla P100 PCIe 16 GB (circa $130-155). Il chip è lo stesso, la memoria è più abbondante di 4 GB e la banda passante è superiore di un terzo. I $40-60 aggiuntivi permettono di usare gpt-oss-20b, modelli 14B con un contesto normale e la massima velocità nei carichi limitati dalla memoria. La versione più piccola rimane più conveniente solo per i calcoli FP64 in cui la capacità non è importante: offre le stesse prestazioni e costa meno.
Tesla P40 24 GB (circa $300-350). Ha il doppio della memoria e supporta DP4A; i modelli 32B in Q4 entrano interamente nella memoria e generano circa 12 tok/s. Di fatto non dispone di FP16 né di FP64, quindi la P40 non è adatta ai calcoli. Per i modelli più grandi di 14B è più utile di qualsiasi P100.
Tesla V100 PCIe 16 GB (circa $365). Dispone di Tensor Core, elabora il prompt da 3 a 4 volte più velocemente e raggiunge 7 TFLOPS in FP64. Il supporto terminerà come quello di Pascal. Per un prezzo triplo si ottiene una scheda sensibilmente più veloce, ma con la stessa durata del supporto.
GeForce RTX 3060 12 GB (circa $300-320 usata). Ha la stessa quantità di memoria, ma supporta CUDA aggiornato, vLLM e le future versioni di PyTorch. Dispone di uscite video e di un sistema di raffreddamento tradizionale, con un consumo di 170 W. I Tensor Core accelerano sensibilmente l’elaborazione del prompt. La doppia precisione è simbolica. Se serve una scheda video normale con software che continuerà a essere supportato per diversi anni, la RTX 3060 è più conveniente, anche se costa tre volte tanto.
Conclusioni
Nei modelli linguistici, la P100 da 12 GB genera testo come una GTX 1080 Ti, mentre elabora il prompt da 3 a 4 volte più lentamente di una RTX 2080 Ti. È sufficiente per modelli 7-14B con quantizzazione a 4 bit e per sperimentare con Ollama e llama.cpp su un vecchio server. I modelli più grandi di 14B non entrano nella memoria, mentre i prompt lunghi vengono elaborati lentamente. vLLM non è supportato, PyTorch ha annunciato la fine delle build precompilate per Pascal e i driver non verranno più pubblicati nel 2028. A questo si aggiungono 250 W di consumo e una rumorosa ventola a turbina.
Non conviene pagare più di $80 per questa scheda. Se servono modelli più grandi di 14B, bisogna orientarsi sulla P40; se serve un software che continui a funzionare dopo il 2028, sulla RTX 3060 12 GB.
Per i calcoli in doppia precisione, a $70-80 la P100 da 12 GB ha quasi pochi concorrenti. Per le reti neurali è meglio aggiungere $50 e scegliere la versione da 16 GB.
Confronto di GPU
Confronta Tesla P100 PCIe 12 GB con altri GPUs
Di base
Specifiche della memoria
Display e multimedia
Prestazioni teoriche
Varie
Classifiche
Rispetto ad altre GPU
Condividi sui social media
Oppure linkaci
<a href="https://cputronic.com/index.php/it/gpu/nvidia-tesla-p100-pcie-12-gb" target="_blank">NVIDIA Tesla P100 PCIe 12 GB</a>