NVIDIA Tesla V100 SXM3 32 GB

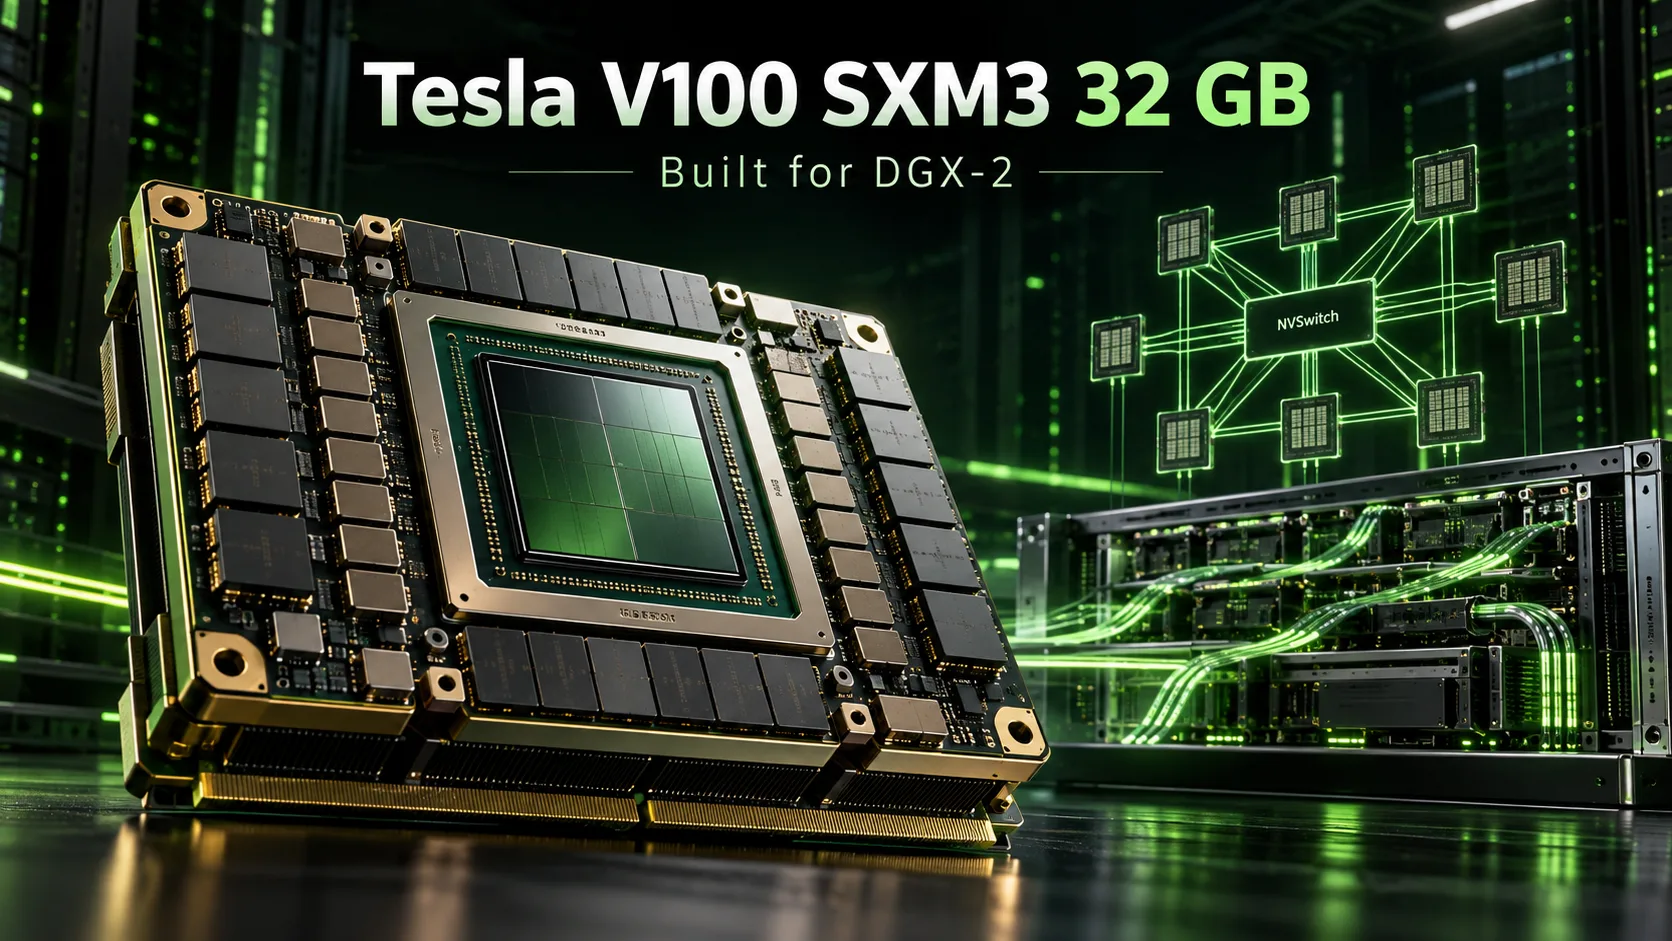
Tesla V100 SXM3 32 Go : plus puissante que la SXM2, mais bien plus difficile à utiliser
La Tesla V100 SXM3 32 Go est un module de calcul NVIDIA destiné au supercalculateur DGX-2 et aux serveurs basés sur la plateforme HGX-2. NVIDIA a présenté le DGX-2 en mars 2018. Celui-ci reposait sur 16 accélérateurs à architecture Volta, reliés par des commutateurs NVSwitch. Par rapport à la V100 SXM2 classique, cette nouvelle version se distinguait par des fréquences plus élevées, une bande passante mémoire supérieure et une limite de puissance de 350 W.
La SXM3 est supérieure à la SXM2 en termes de caractéristiques, mais elle convient nettement moins à une intégration personnelle. Le module utilise un connecteur spécifique, exige une alimentation et un refroidissement compatibles, et son fonctionnement en dehors d’une plateforme serveur est pratiquement non vérifié. Même s’il était possible de connecter une SXM3 à un ordinateur classique, son léger avantage en performances justifierait difficilement les coûts engagés.
Positionnement dans la gamme
| Modèle | Mémoire | Bande passante | Boost | Puissance |
|---|---|---|---|---|
| Tesla V100 PCIe 32 Go | 32 Go de HBM2 | 900 Go/s | 1380 MHz | 250 W |
| Tesla V100 SXM2 32 Go | 32 Go de HBM2 | 900 Go/s | 1530 MHz | 300 W |
| Tesla V100 SXM3 32 Go | 32 Go de HBM2 | 981 Go/s | 1597 MHz | 350 W |
| Tesla V100 SXM3 32 Go H | 32 Go de HBM2 | 1134 Go/s | 1702 MHz | 450 W |
Les quatre versions utilisent le même die GV100 avec 5120 cœurs CUDA et 640 cœurs tensoriels. La différence réside dans les fréquences, les réglages de puissance et le mode de connexion.
La SXM3 standard atteint environ 16,4 TFLOPS en FP32 et 8,2 TFLOPS en FP64. Sa bande passante mémoire est supérieure de 9 % à celle de la SXM2, tandis que la fréquence du GPU augmente d’environ 4 %. Ces différences donnent à la SXM3 un avantage dans les calculs et les tâches limitées par la vitesse de la mémoire, même si le gain réel dépend de la charge de travail.
Pour le DGX-2H, NVIDIA a préparé une variante SXM3-H plus puissante. Sa limite de puissance passe à 450 W et sa bande passante mémoire atteint 1134 Go/s. Il s’agit de la version V100 la plus performante au format SXM.
DGX-2 et NVSwitch
La principale innovation du DGX-2 ne résidait pas dans l’augmentation de la fréquence du GPU, mais dans la manière de relier les accélérateurs.
Dans le DGX-1, huit accélérateurs SXM2 étaient connectés directement via NVLink. Cette topologie limitait les échanges de données entre certaines paires de GPU. Dans le DGX-2, seize modules SXM3 étaient reliés à douze commutateurs NVSwitch, assurant une liaison à haut débit entre tous les accélérateurs.
Le système disposait de 512 Go de mémoire HBM2 au total. Chaque GPU pouvait accéder à la mémoire des autres, mais cela ne transformait pas les seize accélérateurs en un seul GPU doté d’un tampon local partagé. Les latences d’accès à la mémoire distante restaient plus élevées, et les applications devaient prendre en charge le calcul distribué.
La bande passante de l’interconnexion entre les deux moitiés du système atteignait 2,4 To/s. Pour l’entraînement de grands réseaux neuronaux, cet élément était plus important que le léger gain de fréquence de chaque module.
Le DGX-2 offrait environ 2 PFLOPS avec les cœurs tensoriels, consommait jusqu’à 10 kW et coûtait $399 000 à son lancement. NVIDIA a continué à développer l’architecture NVSwitch dans les générations suivantes de DGX, notamment avec le DGX A100.
Performances dans les tâches modernes
Il n’existe pratiquement aucun test indépendant de la V100 SXM3 dans les modèles de langage modernes. La plupart des résultats disponibles ont été obtenus sur des versions SXM2 et PCIe ; il est donc impossible de déterminer précisément l’avantage de la SXM3 en génération de texte pour le moment.
À titre indicatif, une Tesla V100 SXM2 32 Go produit environ 32 tokens/s lors de la génération avec Qwen3.6-27B au format Q4_K_M, à l’aide de llama.cpp. Il s’agit du résultat obtenu avec une seule carte graphique, et non avec un système composé de plusieurs GPU.
La SXM3 dispose d’une bande passante mémoire supérieure de 9 % ; elle pourrait donc théoriquement être plus rapide en génération. Toutefois, il serait incorrect de transposer directement ce pourcentage à la vitesse de génération des tokens. Le résultat dépend de la quantification, de la taille du contexte, du moteur logiciel et des caractéristiques du modèle.
Dans les tâches FP32 et FP64, les fréquences plus élevées apportent également un avantage. En revanche, l’architecture Volta est inférieure aux accélérateurs plus récents en ce qui concerne l’éventail des formats de calcul pris en charge.
Principales limitations logicielles :
- CUDA : l’architecture de calcul sm_70 est prise en charge jusqu’à CUDA 12.9. À partir de CUDA 13, la compilation de nouveaux noyaux GPU pour Volta n’est plus disponible.
- Pilotes : R580 est la dernière branche de NVIDIA à prendre en charge Volta.
- BF16 : la prise en charge matérielle est absente, ce qui limite la compatibilité avec les outils modernes d’entraînement des réseaux neuronaux.
- FlashAttention 2 : l’implémentation officielle ne prend pas en charge Volta. Il faut utiliser d’autres mécanismes d’attention.
La V100 reste capable de faire fonctionner des LLM locaux, mais le lancement de nouveaux modèles et de nouvelles bibliothèques nécessite parfois des versions compilées spécialement.
Peut-on utiliser une SXM3 dans un ordinateur classique ?
Contrairement à une carte PCIe, le module SXM3 ne s’installe pas directement dans un connecteur de carte mère. Il est conçu pour des cartes serveur spécialisées dotées du connecteur, du système d’alimentation et du refroidissement appropriés.
On trouve sur le marché de l’occasion des annonces proposant des adaptateurs SXM3-PCIe pour environ $200-300. Toutefois, certains d’entre eux comportent des références de pièces correspondant à la SXM2. Les confirmations indépendantes d’un fonctionnement stable de véritables modules SXM3 avec ces adaptateurs sont insuffisantes.
Avant l’achat, il faut vérifier :
- Si la carte prend bien en charge la SXM3, et non la SXM2.
- Si le système d’alimentation peut supporter une charge allant jusqu’à 350 W.
- Comment le refroidissement du module est assuré.
- Si le GPU est reconnu par le pilote NVIDIA et s’il supporte une charge prolongée.
Une simple photo de la carte ou une déclaration de compatibilité du vendeur ne suffit pas. Il est préférable d’obtenir les résultats de nvidia-smi, un test CUDA et la confirmation d’un fonctionnement stable précisément avec une V100 SXM3.
Dans un DGX-2 ou un HGX-2, ces problèmes ne se posent pas. En revanche, acheter un serveur complet pour quelques accélérateurs obsolètes est difficilement justifiable. Le DGX-2 nécessite une infrastructure d’alimentation et de refroidissement puissante, et son efficacité énergétique est inférieure à celle des systèmes modernes équipés de GPU A100 ou plus récents.
Alternatives
Tesla V100 SXM2 32 Go. L’alternative la plus proche, avec la même quantité de mémoire. Sur le marché de l’occasion, des exemplaires se sont vendus autour de $450-700, même si les offres actuelles peuvent être nettement plus chères. Il existe des adaptateurs SXM2 vers PCIe ainsi que des cartes modifiées prêtes à l’emploi avec refroidissement. Il faut néanmoins tenir compte du prix de l’adaptateur et de la qualité de la modification.
Tesla V100 PCIe 32 Go. Une solution plus simple pour un serveur compatible PCIe. D’après les transactions finalisées, il faut compter environ $650-850, mais à l’automne 2026, de nombreuses annonces commencent à $850. La carte est inférieure à la SXM3 en fréquence et en bande passante mémoire, mais elle n’exige pas de carte mère SXM spécifique. Elle nécessite tout de même une alimentation adaptée et un refroidissement actif.
Conclusion
La Tesla V100 SXM3 32 Go surpasse la SXM2 en fréquence et en bande passante mémoire, mais ses avantages disparaissent presque entièrement face aux difficultés de connexion.
Pour le propriétaire d’un DGX-2 ou d’un serveur HGX-2, le module reste une pièce de rechange utile. Pour une intégration personnelle, il ne présente un intérêt qu’en tant qu’expérimentation nécessitant de vérifier la compatibilité de l’adaptateur, de l’alimentation et du refroidissement.
Si vous avez besoin d’une V100 dotée de 32 Go de mémoire pour des réseaux neuronaux locaux, il est plus raisonnable de choisir une SXM2 avec un adaptateur éprouvé ou une version PCIe prête à l’emploi. La SXM3 ne vaut la peine d’être achetée que si vous disposez d’une plateforme serveur compatible ou d’un ensemble de connexion fonctionnel dont le bon fonctionnement a été confirmé.
Comparaison de GPU
Comparer Tesla V100 SXM3 32 GB avec d’autres GPUs
Basique
Spécifications de la mémoire
Affichage et multimédia
Performance théorique
Divers
Benchmarks
Comparé aux autres GPU
Partager sur les réseaux sociaux
Ou créez un lien vers nous
<a href="https://cputronic.com/index.php/fr/gpu/nvidia-tesla-v100-sxm3-32-gb" target="_blank">NVIDIA Tesla V100 SXM3 32 GB</a>