NVIDIA Tesla P100 SXM2

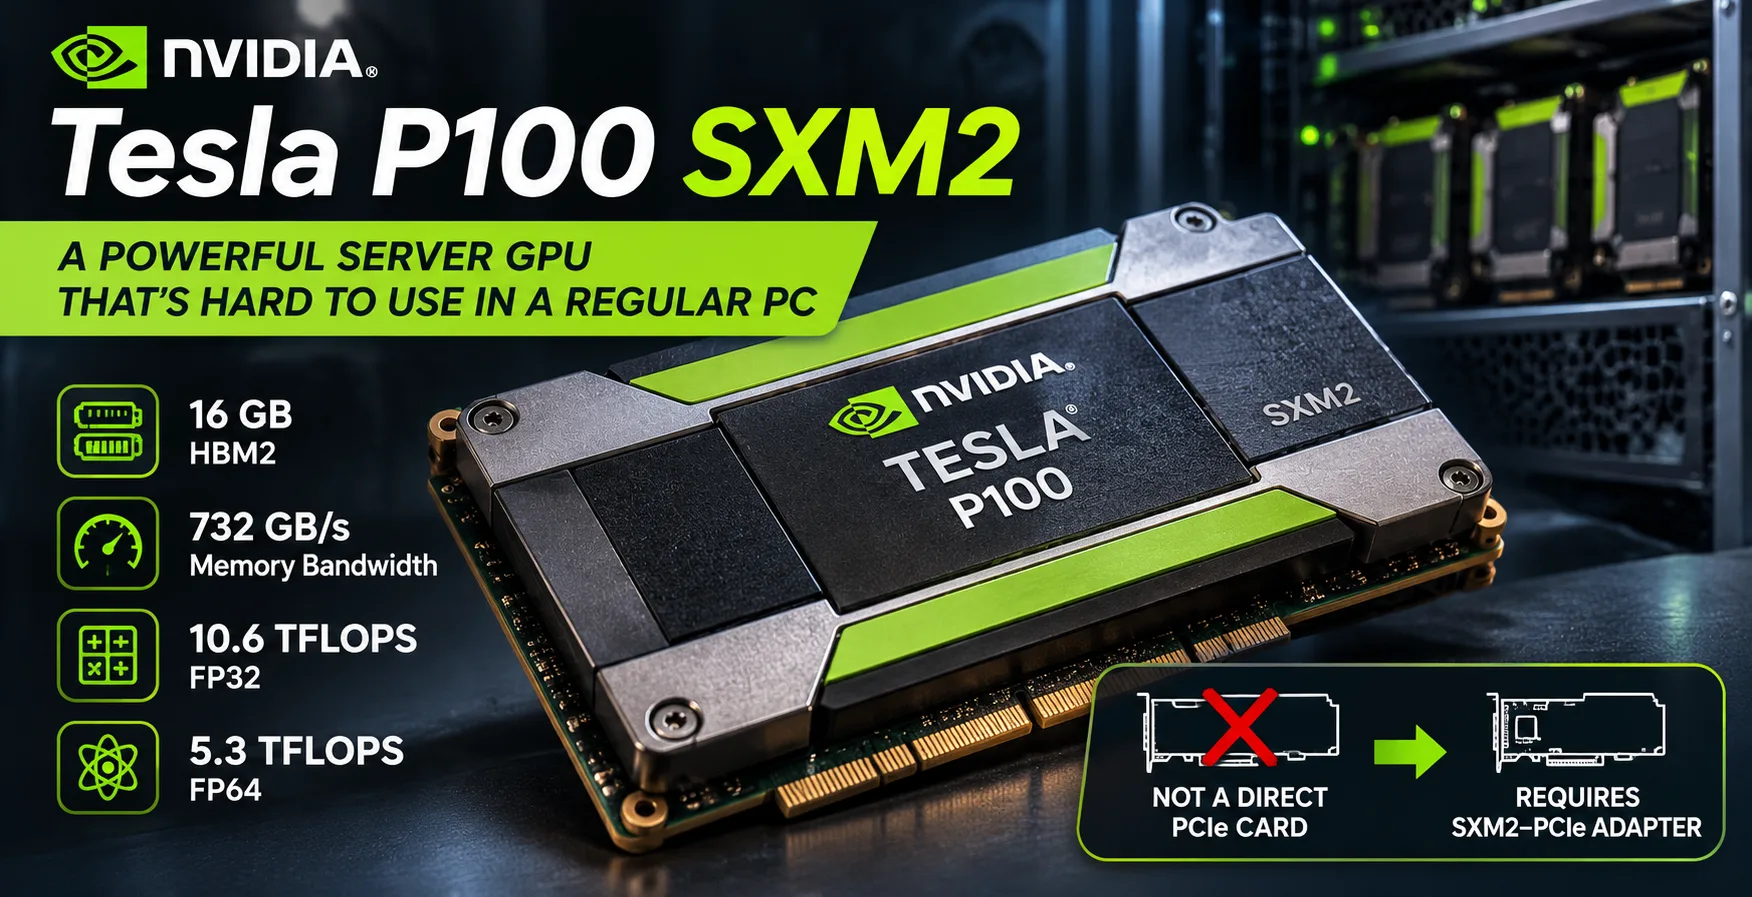
NVIDIA Tesla P100 SXM2 : un GPU serveur bon marché, mais difficile à installer dans un PC classique
La NVIDIA Tesla P100 SXM2 attire les passionnés grâce à ses 16 GB de mémoire HBM2, ses hautes performances en FP64 et son faible prix sur le marché de l’occasion. Mais cet accélérateur de 2016 présente un sérieux inconvénient : au lieu d’un connecteur PCIe standard, il utilise le connecteur serveur SXM2. Pour l’installer dans un ordinateur classique, il faut un adaptateur, un système de refroidissement séparé et une vérification de la compatibilité. Au final, ce module bon marché peut coûter plus cher qu’une version PCIe plus facile à utiliser.
Pourquoi le SXM2 est difficile à connecter à un PC classique
La Tesla P100 SXM2 a été conçue pour des serveurs spécialisés, notamment les systèmes NVIDIA DGX. Elle ne possède pas de connecteur PCIe standard et ne peut pas être installée directement dans un slot de carte mère.
On trouve des adaptateurs SXM2-PCIe sur le marché de l’occasion, mais la présence d’un connecteur adapté ne garantit pas à elle seule le bon fonctionnement de l’ensemble. Avant l’achat, plusieurs questions doivent être résolues :
- Alimentation. L’accélérateur consomme jusqu’à 300 W. L’adaptateur doit fournir l’alimentation nécessaire au module.
- Refroidissement. Le SXM2 est prévu pour un système de refroidissement serveur. Dans un boîtier classique, il faut un dissipateur compatible avec une ventilation suffisamment puissante.
- Compatibilité. Il est nécessaire de vérifier la prise en charge du module concerné par l’adaptateur, la carte mère et le pilote.
- Absence de sorties vidéo. La Tesla P100 n’est pas conçue pour connecter directement un moniteur.
Les dépenses supplémentaires peuvent totalement annuler l’intérêt de l’achat. Selon une estimation du marché américain de l’occasion en août 2026, les modules P100 SXM2 fonctionnels se vendaient environ $47-60. En parallèle, l’un des adaptateurs SXM2-PCIe annonçant la prise en charge de la P100 était proposé en septembre à environ $109, sans compter les frais supplémentaires liés au refroidissement et à la livraison.
Dans cet exemple, le prix de l’adaptateur dépasse presque du double celui de l’accélérateur lui-même. Il est donc inutile d’évaluer l’achat d’une SXM2 en se basant uniquement sur le prix du module.
Différences entre la Tesla P100 SXM2 et la P100 PCIe
Les deux versions reposent sur le même processeur graphique GP100 à architecture Pascal. Elles disposent chacune de 3584 cœurs CUDA, tandis que les variantes dotées de 16 GB de HBM2 offrent la même bande passante mémoire de 732 GB/s.
Les principales différences concernent les fréquences, l’alimentation et la connexion.
| Caractéristique | Tesla P100 SXM2 | Tesla P100 PCIe 16 GB |
|---|---|---|
| Connexion | SXM2 | PCIe 3.0 x16 |
| Fréquence de base | 1328 MHz | 1126 MHz |
| Fréquence Boost | 1480 MHz | 1303 MHz |
| Interconnexion GPU | NVLink, jusqu’à 160 GB/s | PCIe 3.0 |
| Puissance maximale | 300 W | 250 W |
Ses fréquences plus élevées donnent à la SXM2 un avantage d’environ 14 % en performances de calcul théoriques FP32. En revanche, sa puissance maximale est supérieure de 50 W.
Le NVLink constitue un autre avantage de la SXM2 : il permet aux accélérateurs d’échanger des données entre eux. Cette possibilité est utile dans les serveurs multiprocesseurs compatibles. Lorsqu’elle est installée via un simple adaptateur PCIe, la SXM2 perd l’avantage du NVLink.
Pour un accélérateur unique dans un PC de bureau, les avantages de la SXM2 par rapport à la PCIe restent relativement limités.
Performances et benchmarks
Le GP100 se distingue de la plupart des GPU grand public par sa vitesse élevée en calculs double précision FP64. Avec la Tesla P100 SXM2, celle-ci atteint 5,3 TFLOPS, ce qui rend l’accélérateur adapté aux calculs scientifiques et à la modélisation numérique.
La comparaison utilise les résultats de Geekbench 7 OpenCL ainsi que les performances de calcul théoriques de plusieurs cartes graphiques précises.
| Carte graphique | Geekbench 7 OpenCL | FP32, TFLOPS | FP64, TFLOPS |
|---|---|---|---|
| NVIDIA Tesla V100 SXM2 16 GB | 152 601 | 15,7 | 7,8 |
| NVIDIA GeForce RTX 3060 | 88 251 | 12,7 | 0,20 |
| NVIDIA Tesla P100 SXM2 16 GB | 87 454 | 10,6 | 5,3 |
| NVIDIA Tesla P100 PCIe 16 GB | 71 673 | 9,3 | 4,7 |
| NVIDIA Tesla T4 16 GB | 61 276 | 8,1 | ~0,25 |
Geekbench 7 OpenCL : résultats du classement public de Geekbench en octobre 2026, le score le plus élevé étant le meilleur. Les valeurs FP32 et FP64 sont des indicateurs théoriques, et non des résultats de Geekbench. Elles sont fournies pour comparer les capacités de calcul des architectures.
Dans Geekbench, la P100 SXM2 obtient environ 22 % de points de plus que la version PCIe de 16 GB. La différence est plus importante que ne le laissent supposer les caractéristiques officielles, mais les résultats ont été obtenus sur des systèmes différents et ne permettent pas de considérer cette progression comme garantie.
La comparaison avec la GeForce RTX 3060 est plus intéressante. Leurs scores Geekbench sont pratiquement identiques, mais en FP64, la Tesla serveur dépasse théoriquement la RTX 3060 de plus de 26 fois. Cela s’explique par la configuration spécialisée des unités de calcul du GP100, conçue notamment pour les tâches scientifiques.
Toutefois, des résultats OpenCL proches ne signifient pas que les performances sont équivalentes dans les jeux, le rendu ou les réseaux neuronaux.
La Tesla V100 SXM2 est nettement plus rapide que la P100 grâce à l’architecture Volta, à un plus grand nombre d’unités de calcul et à une bande passante mémoire supérieure. De plus, la V100 dispose de Tensor Cores, absents de Pascal.
À quelles tâches la P100 SXM2 reste-t-elle adaptée ?
Malgré son âge, le GP100 ne peut pas être considéré comme inutile. Il conserve des avantages dans les tâches capables d’exploiter les particularités de son architecture :
- Calculs scientifiques et modélisation faisant largement appel au FP64.
- Calculs CUDA avec des logiciels compatibles.
- Traitement de jeux de données pour lequel la haute bande passante de la HBM2 est utile.
- Expérimentations avec des GPU serveur et des configurations multiprocesseurs NVLink.
En FP16, la P100 SXM2 atteint théoriquement 21,2 TFLOPS. Il ne faut toutefois pas comparer directement cette valeur aux performances des Tensor Cores d’accélérateurs plus récents. Les différences d’architecture et d’ensemble d’opérations prises en charge sont trop importantes.
Modèles d’IA locaux et limitations de CUDA en 2026
La présence de 16 GB de mémoire vidéo rend la P100 intéressante pour exécuter des modèles de langage locaux. Par exemple, des modèles quantifiés de 7 à 8 milliards de paramètres peuvent être entièrement chargés dans la mémoire de l’accélérateur avec des réglages appropriés.
Mais la quantité de mémoire n’est qu’une des caractéristiques qui déterminent la facilité d’utilisation des LLM.
Le GP100 repose sur l’architecture Pascal, avec un niveau de capacités de calcul CUDA de 6.0. La dernière version de CUDA Toolkit prenant en charge la compilation de programmes pour Pascal est la 12.9. Avec CUDA 13, la prise en charge de cette architecture lors de la compilation de nouvelles applications a été abandonnée. La dernière branche des pilotes NVIDIA prenant en charge Pascal est la R580.
Cela ne signifie pas que les anciens programmes ont soudainement cessé de fonctionner. Cependant, les nouvelles versions des bibliothèques de machine learning peuvent exiger une architecture plus moderne. Pour exécuter certains modèles, il faut installer d’anciennes versions des logiciels ou compiler soi-même des composants compatibles.
L’absence de Tensor Cores limite la vitesse des calculs neuronaux modernes. Ainsi, une P100 SXM2 avec ses 16 GB de HBM2 ne sera pas nécessairement plus rapide qu’une RTX grand public dotée d’une quantité de mémoire inférieure.
Pour les LLM locaux, il est plus important de vérifier la prise en charge du modèle concerné et de l’environnement logiciel que de se fier aux valeurs FP16 ou à la bande passante mémoire.
Faut-il acheter une Tesla P100 SXM2 en 2026 ?
Si un serveur équipé de connecteurs SXM2 compatibles est déjà disponible, la Tesla P100 reste adaptée aux calculs FP64 et à l’utilisation d’anciens logiciels CUDA. Son faible prix sur le marché de l’occasion la rend intéressante pour ce type de système.
La situation est différente dans un ordinateur de bureau classique. Le gain de performances par rapport à une P100 PCIe est limité, tandis que les dépenses liées à l’adaptateur, au refroidissement et à l’alimentation peuvent dépasser le prix de l’accélérateur lui-même.
Pour expérimenter avec des LLM locaux, il est plus pratique d’utiliser une GeForce RTX plus récente, dotée de Tensor Cores et compatible avec les logiciels actuels. Si l’architecture GP100 est précisément recherchée, la version PCIe 16 GB évite de devoir trouver un adaptateur SXM2, même si elle nécessite elle aussi une ventilation dirigée et puissante.
Conclusion : la Tesla P100 SXM2 reste un accélérateur FP64 performant, mais c’est un mauvais choix pour une configuration bon marché dans un PC classique. Son achat se justifie si l’on dispose d’un équipement compatible ou pour mener une expérimentation technique. Économiser sur l’achat du module lui-même pour ensuite payer davantage son intégration est généralement une mauvaise affaire.
Comparaison de GPU
Comparer Tesla P100 SXM2 avec d’autres GPUs
Basique
Spécifications de la mémoire
Affichage et multimédia
Performance théorique
Divers
Benchmarks
Comparé aux autres GPU
Comparaisons de GPU associées

Partager sur les réseaux sociaux
Ou créez un lien vers nous
<a href="https://cputronic.com/index.php/fr/gpu/nvidia-tesla-p100-sxm2" target="_blank">NVIDIA Tesla P100 SXM2</a>