NVIDIA Tesla P100 PCIe 12 GB

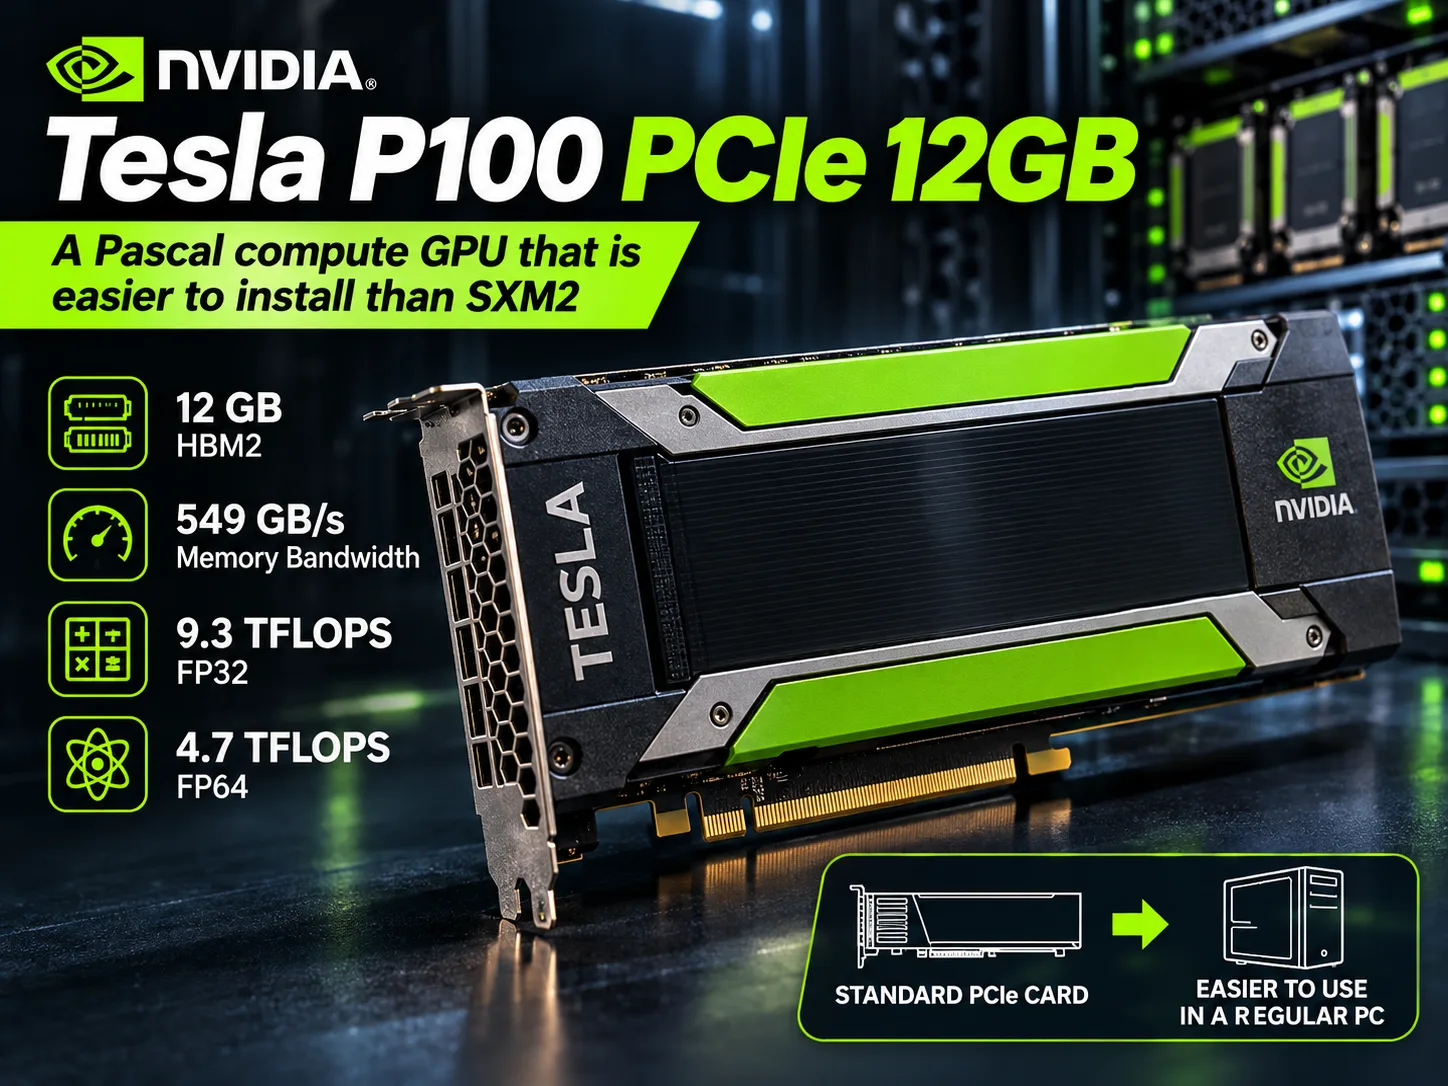
Tesla P100 PCIe 12 GB : calculateur FP64 à 80 $ avec une date de fin de support
La Tesla P100 est le premier accélérateur NVIDIA basé sur l’architecture Pascal. En 2016-2017, elle comptait parmi les principales cartes utilisées dans les supercalculateurs et pour l’entraînement des réseaux de neurones. À l’époque, la version PCIe de 12 Go coûtait environ 4 600 $. Aujourd’hui, ces cartes proviennent de serveurs mis au rebut et se vendent entre 70 et 140 $ sur eBay, soit moins cher qu’une carte graphique gaming d’entrée de gamme.
On l’achète pour ses performances en double précision et sa mémoire HBM2. En FP64, la carte atteint 4,7 TFLOPS, davantage qu’une RTX 4090. La version d’entrée de gamme est toutefois moins bien lotie en mémoire : l’un des quatre stacks HBM2 est désactivé, ce qui réduit d’un quart la capacité et la bande passante par rapport à la P100 16 GB. La prise en charge logicielle complète de Pascal prendra fin avec la branche de pilotes R580, à la mi-2028.
Positionnement dans la gamme et architecture
Toutes les Tesla P100 reposent sur le GP100, une puce gravée en 16 nm et couvrant 610 mm², installée sur un interposeur CoWoS avec quatre stacks HBM2. Sur les 3840 cœurs CUDA de la puce complète, 3584 sont actifs sur la P100. La version PCIe fonctionne à 1190-1329 MHz avec un TDP de 250 W.
La version 12 Go utilise la même carte, avec un stack mémoire désactivé. Le GPU et les fréquences restent inchangés : sa puissance de calcul est donc identique à celle du modèle supérieur.
| Modèle | Mémoire | Bus | Bande passante | FP64 | FP16 | TDP |
|---|---|---|---|---|---|---|
| Tesla P100 PCIe 12 GB | 12 Go HBM2 | 3072 bits | 549 Go/s | 4,7 TFLOPS | 18,7 TFLOPS | 250 W |
| Tesla P100 PCIe 16 GB | 16 Go HBM2 | 4096 bits | 732 Go/s | 4,7 TFLOPS | 18,7 TFLOPS | 250 W |
| Tesla P100 SXM2 | 16 Go HBM2 | 4096 bits | 732 Go/s | 5,3 TFLOPS | 21,2 TFLOPS | 300 W |
| Tesla P40 | 24 Go GDDR5 | 384 bits | 347 Go/s | 1/32 de FP32 | 1/64 de FP32 | 250 W |
Le GPU GP100 n’a pas été retenu pour les GeForce. Son plus proche parent destiné aux stations de travail est la Quadro GP100, équipée de sorties vidéo. Les GTX 1080 Ti et Tesla P40 reposent sur une autre puce, le GP102. Le GP100 exécute le FP64 à la moitié de la vitesse du FP32 et le FP16 à une vitesse double, tandis que ces deux modes sont quasiment supprimés sur le GP102. En revanche, le GP100 - compute capability 6.0 - ne dispose pas des instructions DP4A de produit scalaire entier présentes sur le GP102. Pour les réseaux de neurones quantifiés, cela s’est révélé plus important qu’on ne le pensait en 2016.
La P100 ne possède pas de cœurs Tensor. Ceux-ci sont apparus dès 2017 avec la Tesla V100 basée sur l’architecture Volta.
Performances
La carte ne convient pas au jeu vidéo. Elle n’a aucune sortie vidéo, et les passionnés qui faisaient transiter l’image par une seconde carte graphique se plaignent des pilotes pour centres de données et déconseillent la P100 pour jouer. Ses usages restent surtout les modèles de langage locaux et les calculs en double précision.
Tableau récapitulatif de la communauté llama.cpp pour CUDA (Llama 2 7B, Q4_0, sans Flash Attention) :
| Accélérateur | Mémoire | Traitement du prompt, tok/s | Génération, tok/s |
|---|---|---|---|
| RTX 3090 | 24 Go GDDR6X | 5174 | 158 |
| Tesla V100 | 32 Go HBM2 | 3043 | 129 |
| RTX 2080 Ti | 11 Go GDDR6 | 2890 | 107 |
| GTX 1080 Ti | 11 Go GDDR5X | 1084 | 62 |
| Tesla P100 PCIe 16 GB | 16 Go HBM2 | 761 | 58,4 |
| Tesla P40 | 24 Go GDDR5 | 1007 | 54,7 |
| Tesla T4 | 16 Go GDDR6 | 1219 | 46,4 |
La P100 génère du texte au niveau d’une GTX 1080 Ti et d’une P40. Elle traite le prompt 3,8 fois plus lentement qu’une RTX 2080 Ti, et plus lentement que cette même P40. Avec de courtes requêtes dans un chat, cela reste acceptable, mais sur de longs documents le modèle met sensiblement plus de temps à « lire » le texte avant de répondre.
Le test de ComputingForGeeks réalisé avec une version récente de llama.cpp en octobre 2026 a montré la même chose. Sur Qwen3 8B en Q4_K_M, la P100 16 GB a atteint 38,4 tok/s contre 47 pour la P40, alors que la mémoire de la P100 est deux fois plus rapide. La raison tient à l’absence de DP4A : avec un compute capability 6.0, les kernels quantifiés de llama.cpp passent par un chemin lent.
La largeur de bus réduite de la version 12 Go gêne donc très peu les modèles de langage. Dans le test Llama 2 7B, la P100 16 GB utilise environ 220 Go/s, soit moins du tiers de sa bande passante maximale : elle est donc limitée par les calculs. Il n’existe pas de mesures distinctes de la version d’entrée de gamme dans llama.cpp, mais sur les petits modèles sa vitesse de génération devrait rester proche de celle de la version 16 Go. Le problème de la version 12 Go est sa capacité : gpt-oss-20b et les modèles denses de plus de 14B ne tiennent pas dans cette mémoire.
La situation est inverse en FP64. Une RTX 4090 atteint environ 1,3 TFLOPS en double précision, tandis qu’une RTX 3090 en fournit dix fois moins que la P100. Les cartes serveur de la génération suivante sont les seules à s’en approcher : la V100 PCIe atteint 7 TFLOPS et l’AMD Instinct MI50, 6,6 TFLOPS. Dans les calculs limités par la mémoire en FP64, par exemple les méthodes sur grille et l’hydrodynamique, la version 12 Go sera jusqu’à 25 % plus lente que le modèle supérieur.
Résultats dans des systèmes spécifiques
Il existe très peu de tests publiés portant précisément sur la version 12 Go ; le tableau inclut donc également les résultats du modèle 16 Go équipé de la même puce.
| Système | Configuration | Version de la P100 | Test | Résultat |
|---|---|---|---|---|
| Uniwide RB228H | 2× Xeon E5-2699 v4 | PCIe 12 GB | SPEC ACCEL OpenCL, base | 5,15 |
| Serveur d’hébergement de Database Mart | 2× Xeon E5-2660 v2, 128 Go de DDR3 | PCIe 16 GB | Ollama, Llama 2 7B | 49,7 tok/s |
| Nœud loué sur vast.ai | n.d. | PCIe 16 GB | llama.cpp, Qwen3 8B Q4_K_M | 38,4 tok/s |
L’écart entre 49,7 et 38,4 tok/s s’explique par le modèle et la quantification, pas par le serveur. Si le modèle tient entièrement dans la mémoire vidéo, le processeur influence très peu la vitesse de génération ; même une plateforme équipée d’un Xeon E5 v2 de 2013 ne ralentit pas la carte.
Au repos, la P100 consomme 28 W et la P40, 11 W. Avec une charge de LLM, la consommation de pointe de la P100 atteint 211 W.
Où on la trouve, prix et disponibilité
Il n’existe plus de matériel neuf équipé d’une P100. À l’époque, la carte était proposée en option dans les serveurs Dell PowerEdge R730, R740, C4130 et C4140, Cisco UCS C240 M5 et C220 M5SX, ainsi que dans les HPE ProLiant. C’est de là qu’elle arrive sur le marché de l’occasion, généralement sans câbles.
| Variante | État | Prix |
|---|---|---|
| Tesla P100 PCIe 12 GB | d’occasion, lots en volume | 70-100 $ |
| Tesla P100 PCIe 12 GB | d’occasion, testée avec possibilité de retour | 110-165 $ |
| Tesla P100 PCIe 16 GB | d’occasion, lots provenant de Chine | 118-130 $ |
| Tesla P100 PCIe 16 GB | reconditionnée, Amazon | environ 155 $ |
Pour installer la carte dans un PC classique, il faudra acheter quelques accessoires :
| Élément nécessaire | Utilité | Prix |
|---|---|---|
| Carénage et ventilateur-turbine | refroidissement passif | à partir de 20 $, ventilateur en sus |
| Adaptateur 8-pin EPS | connecteur processeur, pas PCIe | environ 13 $ |
| Circuit graphique intégré ou seconde carte | aucune sortie vidéo | - |
L’option Above 4G Decoding doit être activée dans le BIOS. Il est impossible d’installer une P100 dans le même système qu’une carte Blackwell : elles nécessitent des modules du noyau NVIDIA différents. Au final, une P100 12 GB prête à l’emploi revient à 110-150 $.
Concurrentes et alternatives
Tesla P100 PCIe 16 GB (environ 130-155 $). La puce est identique, mais la carte dispose de 4 Go de mémoire supplémentaires et d’une bande passante supérieure d’un tiers. Les 40-60 $ supplémentaires permettent d’utiliser gpt-oss-20b, des modèles 14B avec un contexte normal et la pleine vitesse dans les tâches limitées par la mémoire. La version 12 Go ne reste plus avantageuse que pour les calculs en FP64 où la capacité mémoire n’est pas importante : elle offre les mêmes performances tout en coûtant moins cher.
Tesla P40 24 GB (environ 300-350 $). Elle dispose de deux fois plus de mémoire et prend en charge DP4A ; les modèles 32B en Q4 y tiennent entièrement et génèrent environ 12 tok/s. Ses performances en FP16 et FP64 sont en pratique inexistantes, ce qui la rend inutilisable pour les calculs. Pour les modèles de plus de 14B, elle est plus utile que n’importe quelle P100.
Tesla V100 PCIe 16 GB (environ 365 $). Elle possède des cœurs Tensor, traite les prompts 3 à 4 fois plus rapidement et atteint 7 TFLOPS en FP64. Sa prise en charge prendra fin en même temps que celle de Pascal. Pour trois fois plus cher, on obtient une carte sensiblement plus rapide, mais avec la même durée de vie.
GeForce RTX 3060 12 GB (environ 300-320 $ d’occasion). Elle possède la même quantité de mémoire, mais permet d’utiliser une version actuelle de CUDA, vLLM et les futures versions de PyTorch. Elle dispose de sorties vidéo et d’un refroidissement classique, pour une consommation de 170 W. Ses cœurs Tensor accélèrent sensiblement le traitement des prompts. La double précision y est symbolique. Si l’on a besoin d’une carte graphique classique avec un logiciel qui restera pris en charge pendant plusieurs années, la RTX 3060 est plus intéressante, malgré un prix trois fois supérieur.
Conclusion
Pour les modèles de langage, la P100 12 GB génère du texte comme une GTX 1080 Ti et traite les prompts 3 à 4 fois plus lentement qu’une RTX 2080 Ti. Elle suffit pour les modèles 7-14B en quantification 4 bits et pour expérimenter avec Ollama et llama.cpp sur un ancien serveur. Les modèles de plus de 14B ne tiennent pas dans sa mémoire et les longs prompts sont traités lentement. vLLM n’est pas pris en charge, PyTorch a annoncé l’arrêt des builds prêtes à l’emploi pour Pascal et les pilotes cesseront de sortir en 2028. À cela s’ajoutent une consommation de 250 W et une turbine bruyante.
Il ne faut pas payer plus de 80 $ pour cette carte. Si vous avez besoin de modèles de plus de 14B, tournez-vous vers la P40 ; si vous voulez un logiciel qui continuera à fonctionner après 2028, choisissez une RTX 3060 12 GB.
Pour les calculs en double précision, la P100 12 GB à 70-80 $ a pratiquement peu de concurrentes. Pour les réseaux de neurones, mieux vaut ajouter 50 $ et prendre la version 16 Go.
Comparaison de GPU
Comparer Tesla P100 PCIe 12 GB avec d’autres GPUs
Basique
Spécifications de la mémoire
Affichage et multimédia
Performance théorique
Divers
Benchmarks
Comparé aux autres GPU
Partager sur les réseaux sociaux
Ou créez un lien vers nous
<a href="https://cputronic.com/index.php/fr/gpu/nvidia-tesla-p100-pcie-12-gb" target="_blank">NVIDIA Tesla P100 PCIe 12 GB</a>