NVIDIA CMP 50HX

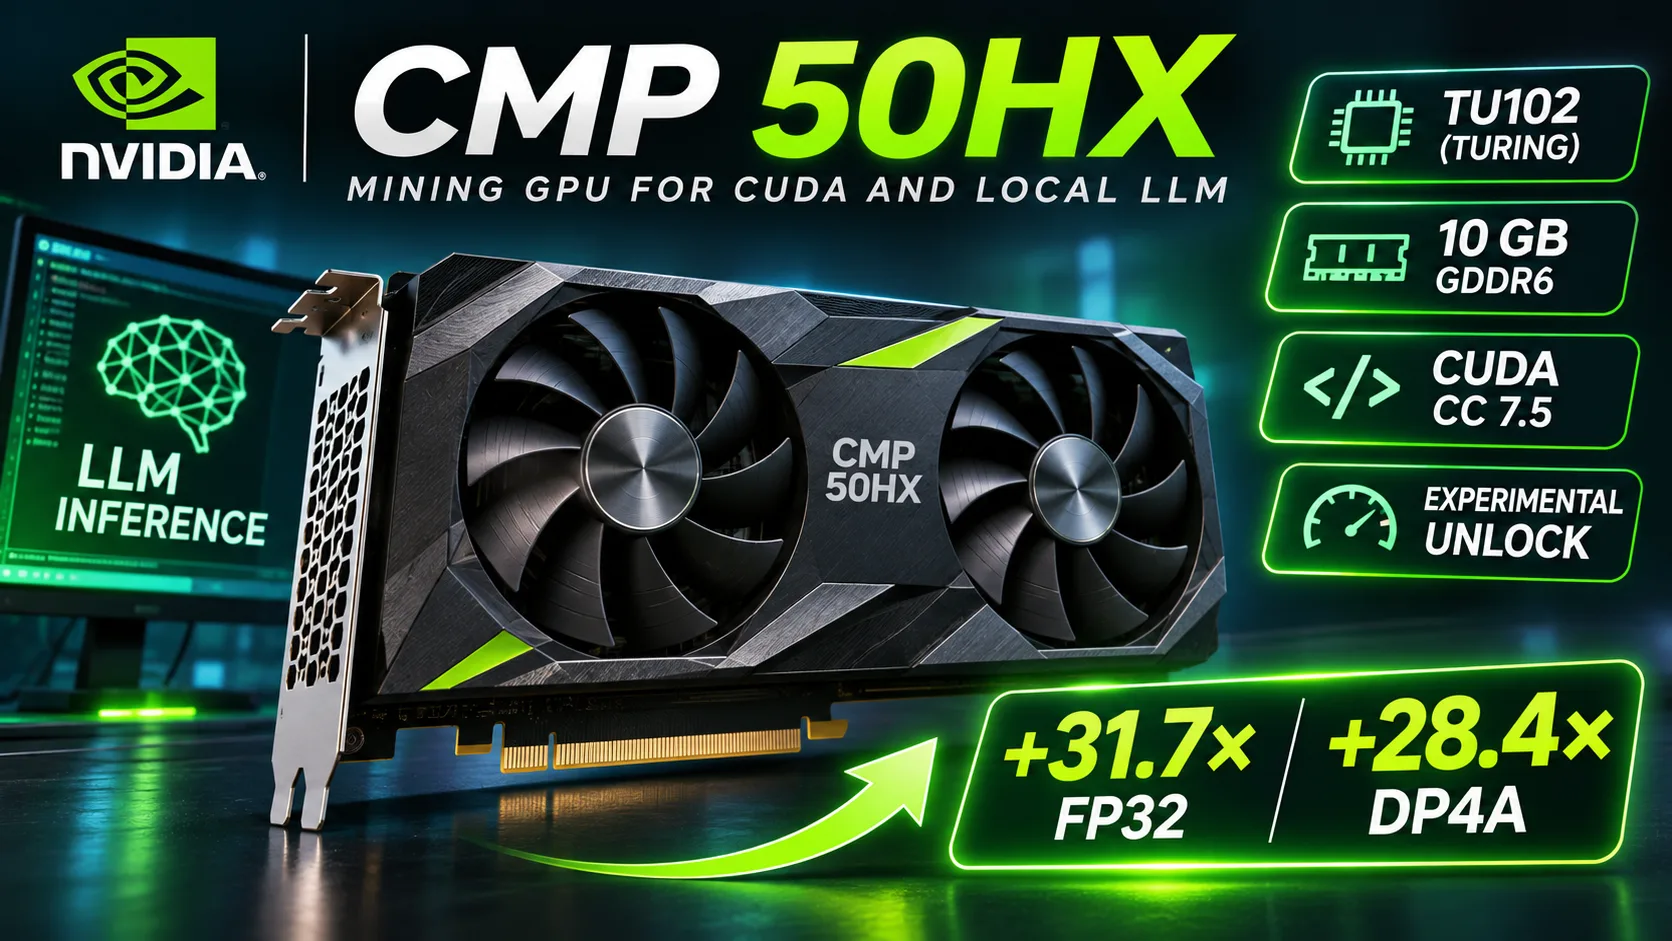
NVIDIA CMP 50HX: 10 GB de memoria para CUDA y LLM locales
NVIDIA CMP 50HX es una tarjeta gráfica especializada para minería, lanzada en 2021. Utiliza una GPU TU102 con arquitectura Turing, emparentada con la GPU de la GeForce RTX 2080 Ti. La tarjeta cuenta con 3584 núcleos CUDA y 10 GB de memoria GDDR6, pero carece de salidas de vídeo y tiene limitaciones en el rendimiento de cálculo.
Tras la transición de Ethereum a Proof of Stake, las CMP 50HX empezaron a utilizarse para experimentar con CUDA y redes neuronales locales. En algunos LLM ofrecen alrededor de 30 tokens/s, aunque la velocidad depende del tipo de cálculos y de la configuración del software. En 2026 aparecieron métodos experimentales para eliminar parte de las limitaciones.
Arquitectura y características
La CMP 50HX está basada en una GPU TU102 de 12 nm con 56 multiprocesadores de streaming. En comparación con la RTX 2080 Ti, tiene menos bloques de cálculo activos y un bus de memoria más estrecho.
| Característica | CMP 50HX | RTX 2080 Ti |
|---|---|---|
| Núcleos CUDA | 3584 | 4352 |
| Multiprocesadores de streaming | 56 | 68 |
| Memoria GDDR6 | 10 GB | 11 GB |
| Bus de memoria | 320-bit | 352-bit |
| Ancho de banda | 560 GB/s | 616 GB/s |
| Frecuencia Boost | 1545 MHz | 1545 MHz |
| PCIe | 1.0 x4 | 3.0 x16 |
| Consumo energético | 225 W | 250 W |
| Salidas de vídeo | No | Sí |
Características de la MSI CMP 50HX MINER y de la RTX 2080 Ti estándar.
La CMP 50HX funciona a frecuencias de 1350-1545 MHz. La memoria GDDR6, con una velocidad de 14 Gb/s, proporciona un ancho de banda de 560 GB/s. El rendimiento teórico en FP32 a la frecuencia Boost es de aproximadamente 11.07 TFLOPS.
Sin embargo, en la configuración estándar, el rendimiento de cálculo disponible es considerablemente inferior.
Características de la CMP 50HX:
- Compatibilidad con CUDA Compute Capability 7.5.
- 10 GB de GDDR6 para cálculos y almacenamiento de modelos.
- Ausencia de HDMI y DisplayPort.
- Interfaz PCIe 1.0 x4 limitada.
- Dos conectores de alimentación adicionales de 8 pines.
- Las funciones disponibles dependen de los controladores.
La versión de MSI consume 225 W, mientras que la especificación de referencia de NVIDIA contempla 250 W. Para un funcionamiento prolongado se requiere un flujo de aire suficiente dentro de la caja.
Rendimiento en FP32, FP16 e INT8
La principal característica de la CMP 50HX son las limitaciones de software aplicadas a determinadas operaciones de cálculo. En la configuración estándar, la velocidad de FP32 y DP4A se reduce especialmente, mientras que FP16 funciona a una velocidad considerablemente mayor.
En septiembre de 2026, los desarrolladores del desbloqueo experimental compararon el rendimiento de una tarjeta con un controlador normal y con ese mismo controlador después de aplicar la modificación.
| Cálculos | Antes del desbloqueo | Después del desbloqueo | Aumento |
|---|---|---|---|
| FP32, TFLOPS | 0.427 | 13.512 | 31.7× |
| FP16 half2, TFLOPS | 26.923 | 26.698 | ≈1× |
| DP4A / INT8, TIOPS | 1.689 | 47.984 | 28.4× |
Resultados de un único experimento comparativo con la misma base de software. Las mediciones posteriores al desbloqueo no son especificaciones de fábrica.
El rendimiento en FP32 aumentó casi 32 veces, mientras que el de DP4A lo hizo más de 28 veces. Al mismo tiempo, la velocidad de las operaciones FP16 convencionales prácticamente no cambió.
Esto confirma que las limitaciones afectan a determinados bloques de cálculo e instrucciones, no a toda la GPU.
Tras el desbloqueo, FP32 alcanzó 13.51 TFLOPS, por encima de los 11.07 TFLOPS teóricos a la frecuencia Boost de fábrica. La causa es la mayor frecuencia de funcionamiento durante el experimento. Comparar estos resultados sin tener en cuenta las frecuencias no es correcto.
En otra prueba, tras el desbloqueo, FP16 Tensor WMMA alcanzó 106.8 TFLOPS. Este resultado corresponde a operaciones tensoriales y no es directamente comparable con el FP16 convencional de la tabla.
Desbloqueo experimental en 2026
Los desarrolladores lograron recuperar el rendimiento de cálculo de la CMP 50HX mediante una modificación de la UEFI y cambios en la configuración del software.
Para la versión probada se utiliza el controlador NVIDIA 610.43.03. El desbloqueo requiere cargar la UEFI y tener activado Above 4G Decoding. Secure Boot puede conservarse si la aplicación UEFI se firma correctamente y se registra la clave.
Otras modificaciones permiten activar PCIe Gen2 y la compatibilidad experimental con ReBAR. Sin embargo, estas funciones pueden requerir cambios independientes en los controladores.
Los resultados se confirmaron en configuraciones de prueba concretas. La compatibilidad con otras placas y sistemas debe comprobarse por separado.
Rendimiento en LLM locales
Los 10 GB de memoria de vídeo permiten alojar en la CMP 50HX muchos modelos de lenguaje cuantizados con 7-9 mil millones de parámetros.
En pruebas con Ollama y controladores modificados se obtuvieron los siguientes resultados de generación:
| Modelo | CMP 50HX, tokens/s |
|---|---|
| Qwen3 8B Q4_K_M | alrededor de 28 |
| Llama 3.1 8B Instruct Q6_K | 32 |
| Dolphin3 8B | 28 |
| Gemma 2 9B | 33 |
| Gemma 3 4B Q8_0 | 57 |
Velocidad de generación anterior al desbloqueo experimental de los cálculos en 2026.
Estas cifras explican por qué la CMP 50HX seguía siendo adecuada para inferencia incluso con un rendimiento FP32 extremadamente bajo.
Sin embargo, la limitación de DP4A también es importante. Al procesar modelos cuantizados, CUDA puede utilizar operaciones enteras, incluida DP4A. La reducción de su velocidad puede limitar tanto la generación de tokens como el procesamiento del contexto de entrada.
El procesamiento de prompts largos (prefill) puede ser especialmente sensible, ya que la carga de cálculo es mayor. No obstante, todavía no hay suficientes mediciones comparativas confirmadas del prefill antes y después del desbloqueo como para extraer conclusiones cuantitativas.
La CMP 50HX tiene un ancho de banda de memoria de 560 GB/s, frente a los 360 GB/s de la RTX 3060 12 GB. Sin embargo, un ancho de banda elevado por sí solo no garantiza una generación más rápida: las limitaciones de cálculo, las características de los núcleos CUDA y la cuantización también influyen en el resultado.
El desbloqueo de DP4A sienta las bases para acelerar los LLM, pero el aumento de 28 veces observado en una prueba sintética no puede extrapolarse a la velocidad de generación de tokens.
Con una cuantización adecuada y un contexto pequeño, algunos modelos de 12-14 mil millones de parámetros también pueden caber en 10 GB de VRAM. Esto depende del tamaño de los pesos, la caché KV y la sobrecarga de la aplicación. Si parte de las capas se transfiere a la CPU, la velocidad disminuye notablemente.
Limitaciones de PCIe
Para la MSI CMP 50HX se especifica una interfaz PCIe 1.0 x4, con un ancho de banda teórico de aproximadamente 1 GB/s en cada dirección.
Para la minería, esto no era crítico, ya que el intercambio de datos con la CPU era relativamente reducido. Sin embargo, al cargar LLM y transferir grandes volúmenes de datos, el PCIe lento aumenta el tiempo de espera.
Las modificaciones experimentales permiten cambiar la interfaz al modo PCIe Gen2 x4. Su ancho de banda teórico es de aproximadamente 2 GB/s en cada dirección. En el sistema de prueba, después de la modificación, la velocidad de transferencia medida alcanzó aproximadamente 1.7 GB/s.
Si el modelo cabe por completo en la VRAM, la velocidad de generación de tokens puede depender relativamente poco del PCIe. Al transferir capas entre la RAM y la GPU, la influencia de la interfaz se vuelve mucho más evidente.
Rendimiento en minería
La CMP 50HX se diseñó originalmente para minar Ethereum con el algoritmo Ethash. NVIDIA anunciaba las siguientes cifras para la familia CMP:
| Tarjeta gráfica | Ethash | Consumo energético |
|---|---|---|
| CMP 30HX | 26 MH/s | 125 W |
| CMP 40HX | 36 MH/s | 185 W |
| CMP 50HX | 45 MH/s | 250 W |
| CMP 90HX | 86 MH/s | 320 W |
Especificaciones anunciadas de las soluciones de referencia de NVIDIA para las condiciones de 2021.
La CMP 50HX ofrecía un hashrate un 25% superior al de la CMP 40HX. Sin embargo, tras la transición de Ethereum a Proof of Stake en septiembre de 2022, la minería de ETH con tarjetas gráficas llegó a su fin.
Es posible utilizar la CMP 50HX con otros algoritmos, pero su rentabilidad depende de la dificultad de la red y del coste de la electricidad.
¿Se puede utilizar la CMP 50HX para jugar?
A pesar de su parentesco con la RTX 2080 Ti, la CMP 50HX no está diseñada para juegos.
La tarjeta no tiene salidas de vídeo y la configuración estándar limita las funciones gráficas. Los controladores modificados permiten ejecutar algunas aplicaciones, pero no garantizan la compatibilidad con los juegos.
Incluso después de desbloquear las operaciones de cálculo, siguen existiendo limitaciones en el pipeline gráfico. Por eso, el rendimiento de la RTX 2080 Ti no puede extrapolarse automáticamente a la CMP 50HX.
¿Vale la pena comprar la NVIDIA CMP 50HX en 2026?
La CMP 50HX resulta interesante para experimentar con CUDA, LLM locales y modificaciones de GPU. Sus principales ventajas son los 10 GB de GDDR6, el bus de memoria amplio y la posibilidad de recuperar el rendimiento de cálculo.
Pero para un sistema de uso general siguen existiendo limitaciones: controladores no estándar, PCIe lento y ausencia de salidas de vídeo.
Para redes neuronales locales, la GeForce RTX 3060 12 GB sigue siendo una alternativa más versátil. Ofrece más memoria de vídeo, compatibilidad completa con CUDA y una interfaz PCIe estándar.
Tiene sentido considerar la CMP 50HX si supone un ahorro considerable frente a la RTX 3060 y se está dispuesto a configurar el software por cuenta propia. Para un funcionamiento estable sin modificaciones, es preferible una GeForce convencional.
Conclusión: la NVIDIA CMP 50HX es un acelerador especializado basado en TU102 con 10 GB de GDDR6. El desbloqueo experimental de 2026 mostró un aumento de 31.7 veces en FP32 y de 28.4 veces en DP4A, pero su influencia en los LLM reales todavía requiere mediciones independientes. La tarjeta resulta interesante para experimentos de cálculo, pero no es un sustituto completo de una GeForce.
Comparación de GPU
Comparar CMP 50HX con otros GPUs
Básico
Especificaciones de Memoria
Pantalla y multimedia
Rendimiento teórico
Misceláneos
Clasificaciones
Comparado con Otras GPU
Comparaciones de GPU relacionadas


Compartir en redes sociales
O Enlázanos
<a href="https://cputronic.com/index.php/es/gpu/nvidia-cmp-50hx" target="_blank">NVIDIA CMP 50HX</a>