NVIDIA Tesla V100 SXM3 32 GB

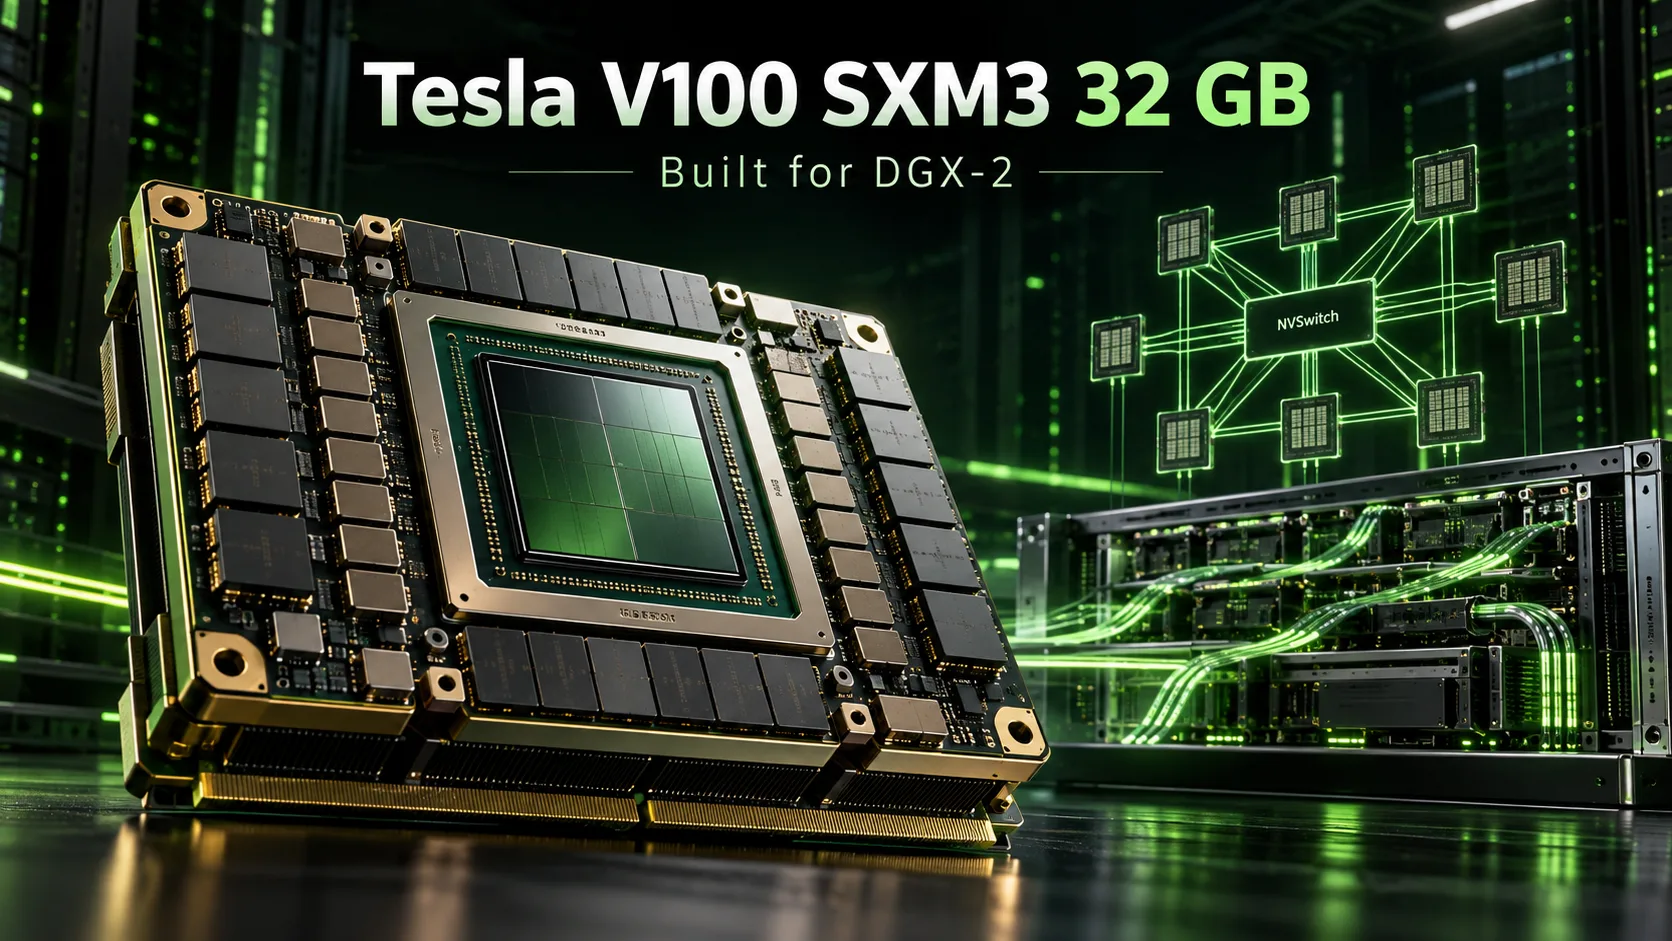
Tesla V100 SXM3 32 GB: leistungsstärker als SXM2, aber deutlich schwieriger zu verwenden
Die Tesla V100 SXM3 32 GB ist ein NVIDIA-Rechenmodul für den Supercomputer DGX-2 und Server auf Basis der HGX-2-Plattform. NVIDIA stellte den DGX-2 im März 2018 vor. In seinem Zentrum standen 16 Beschleuniger mit Volta-Architektur, die über NVSwitches miteinander verbunden waren. Im Vergleich zur herkömmlichen V100 SXM2 bot die neue Version höhere Taktraten, eine größere Speicherbandbreite und eine Leistungsgrenze von 350 W.
Die SXM3 übertrifft die SXM2 bei den technischen Daten, eignet sich aber deutlich schlechter für einen Eigenbau. Das Modul verwendet einen speziellen Anschluss und benötigt eine kompatible Stromversorgung und Kühlung. Außerdem ist sein Betrieb außerhalb einer Serverplattform kaum erprobt. Selbst wenn es gelingt, eine SXM3 an einen gewöhnlichen Computer anzuschließen, dürfte der geringe Geschwindigkeitsvorteil den Aufwand kaum rechtfertigen.
Einordnung in die Produktpalette
| Modell | Speicher | Speicherbandbreite | Boost | Leistungsaufnahme |
|---|---|---|---|---|
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 900 GB/s | 1380 MHz | 250 W |
| Tesla V100 SXM2 32 GB | 32 GB HBM2 | 900 GB/s | 1530 MHz | 300 W |
| Tesla V100 SXM3 32 GB | 32 GB HBM2 | 981 GB/s | 1597 MHz | 350 W |
| Tesla V100 SXM3 32 GB H | 32 GB HBM2 | 1134 GB/s | 1702 MHz | 450 W |
Alle vier Versionen verwenden denselben GV100-Chip mit 5120 CUDA-Kernen und 640 Tensor-Kernen. Die Unterschiede liegen bei den Taktraten, den Leistungseinstellungen und der Art der Anbindung.
Die Standard-SXM3 erreicht ungefähr 16,4 TFLOPS in FP32 und 8,2 TFLOPS in FP64. Ihre Speicherbandbreite liegt 9 % über der der SXM2, während die GPU-Taktrate um etwa 4 % erhöht wurde. Dadurch hat die SXM3 bei Berechnungen und speicherbandbreitenbegrenzten Aufgaben einen Vorteil, wobei der tatsächliche Leistungszuwachs von der jeweiligen Last abhängt.
Für den DGX-2H entwickelte NVIDIA die leistungsstärkere Variante SXM3-H. Ihre Leistungsgrenze wurde auf 450 W erhöht, während die Speicherbandbreite 1134 GB/s erreicht. Dies ist die leistungsfähigste V100-Version im SXM-Format.
DGX-2 und NVSwitch
Die wichtigste Neuerung des DGX-2 war nicht die höhere GPU-Taktrate, sondern die Art, wie die GPUs miteinander verbunden wurden.
Im DGX-1 waren acht SXM2-Beschleuniger über NVLink direkt miteinander verbunden. Die Topologie begrenzte den Datenaustausch zwischen einzelnen GPU-Paaren. Im DGX-2 wurden sechzehn SXM3-Module an zwölf NVSwitches angeschlossen, wodurch eine Hochgeschwindigkeitsverbindung zwischen allen Beschleunigern möglich wurde.
Das System verfügte über insgesamt 512 GB HBM2-Speicher. Jede GPU konnte auf den Speicher der übrigen GPUs zugreifen, doch dadurch wurden die sechzehn Beschleuniger nicht zu einer einzigen GPU mit einem gemeinsamen lokalen Puffer. Die Zugriffszeiten auf den entfernten Speicher blieben höher, und die Anwendungen mussten verteilte Berechnungen unterstützen.
Die Bandbreite der Verbindung zwischen den beiden Systemhälften erreichte 2,4 TB/s. Für das Training großer neuronaler Netze war dies wichtiger als der geringe Anstieg der Taktrate einzelner Module.
Der DGX-2 erreichte auf den Tensor-Kernen etwa 2 PFLOPS, verbrauchte bis zu 10 kW und kostete zum Marktstart $399.000. NVIDIA entwickelte die Architektur mit NVSwitch in den folgenden DGX-Generationen weiter, darunter im DGX A100.
Leistung bei modernen Aufgaben
Unabhängige Einzeltests der V100 SXM3 mit modernen Sprachmodellen gibt es praktisch nicht. Die meisten verfügbaren Ergebnisse wurden mit SXM2- und PCIe-Modellen erzielt, sodass sich der genaue Vorteil der SXM3 bei der Textgenerierung derzeit nicht bestimmen lässt.
Als Orientierung erreicht eine Tesla V100 SXM2 32 GB bei der Generierung mit Qwen3.6-27B im Format Q4_K_M unter Verwendung von llama.cpp etwa 32 Token/s. Dieses Ergebnis bezieht sich auf eine einzelne Grafikkarte und nicht auf ein System mit mehreren GPUs.
Die SXM3 verfügt über eine um 9 % höhere Speicherbandbreite und könnte bei der Generierung daher theoretisch schneller sein. Diesen Prozentsatz direkt auf die Token-Ausgaberate zu übertragen, wäre jedoch falsch. Das Ergebnis wird von der Quantisierung, der Kontextgröße, der Software-Engine und den Eigenschaften des Modells beeinflusst.
Auch bei FP32- und FP64-Aufgaben bieten die höheren Taktraten einen Vorteil. Die Volta-Architektur liegt bei der Zahl der unterstützten Rechenformate jedoch hinter neueren Beschleunigern zurück.
Die wichtigsten Softwareeinschränkungen:
- CUDA: Die Compute Capability sm_70 wird bis CUDA 12.9 unterstützt. Ab CUDA 13 ist die Kompilierung neuer GPU-Kernels für Volta nicht mehr verfügbar.
- Treiber: R580 ist der letzte NVIDIA-Treiberzweig mit Volta-Unterstützung.
- BF16: Eine Hardwareunterstützung fehlt, was die Kompatibilität mit modernen Werkzeugen für das Training neuronaler Netze einschränkt.
- FlashAttention 2: Die offizielle Implementierung unterstützt Volta nicht. Daher müssen andere Attention-Mechanismen verwendet werden.
Die V100 kann weiterhin lokale LLMs ausführen, doch für den Start neuer Modelle und Bibliotheken sind mitunter spezielle Builds erforderlich.
Kann man eine SXM3 in einem gewöhnlichen Computer verwenden?
Im Gegensatz zu einer PCIe-Karte wird ein SXM3-Modul nicht direkt in einen Steckplatz des Mainboards eingesetzt. Es ist für spezielle Serverplatinen mit dem passenden Anschluss sowie einer entsprechenden Stromversorgung und Kühlung ausgelegt.
Auf dem Gebrauchtmarkt finden sich Angebote für SXM3-zu-PCIe-Adapter für etwa $200-300. Einige davon enthalten jedoch Teilenummern, die zur SXM2 gehören. Unabhängige Bestätigungen für einen stabilen Betrieb echter SXM3-Module mit solchen Adaptern sind nicht ausreichend vorhanden.
Vor dem Kauf sollte geprüft werden:
- Unterstützt das Board tatsächlich SXM3 und nicht SXM2?
- Hält die Stromversorgung eine Last von bis zu 350 W aus?
- Wie ist die Kühlung des Moduls ausgeführt?
- Wird die GPU vom NVIDIA-Treiber erkannt und hält sie einer längeren Belastung stand?
Ein gewöhnliches Foto der Platine oder die Kompatibilitätsangabe des Verkäufers reicht nicht aus. Empfehlenswert sind Ergebnisse von nvidia-smi, ein CUDA-Test und eine Bestätigung des stabilen Betriebs speziell mit einer V100 SXM3.
Im DGX-2 und HGX-2 bestehen diese Probleme nicht. Die Anschaffung eines kompletten Servers wegen einiger veralteter Beschleuniger lässt sich jedoch nur schwer rechtfertigen. Der DGX-2 ist auf eine leistungsfähige Infrastruktur für Stromversorgung und Kühlung ausgelegt, während seine Energieeffizienz hinter modernen Systemen mit A100 und neueren GPUs zurückbleibt.
Alternativen
Tesla V100 SXM2 32 GB. Die naheliegendste Alternative mit derselben Speicherkapazität. Auf dem Gebrauchtmarkt wurden solche Karten für etwa $450-700 angeboten, aktuelle Angebote können jedoch deutlich teurer sein. Für die SXM2 gibt es Adapter auf PCIe sowie fertig umgebaute Karten mit Kühllösung. Dabei müssen die Kosten des Adapters und die Qualität des Umbaus berücksichtigt werden.
Tesla V100 PCIe 32 GB. Die einfachere Variante für einen kompatiblen Server mit PCIe. Abgeschlossene Verkäufe deuten auf etwa $650-850 hin, im Herbst 2026 beginnen viele Angebote jedoch bei $850. Die Karte liegt bei Taktrate und Speicherbandbreite hinter der SXM3 zurück, benötigt dafür aber keine speziellen SXM-Platinen. Eine geeignete Stromversorgung und aktive Kühlung sind dennoch erforderlich.
Fazit
Die Tesla V100 SXM3 32 GB übertrifft die SXM2 bei Taktraten und Speicherbandbreite, doch angesichts der Schwierigkeiten beim Anschluss gehen ihre Vorteile fast vollständig verloren.
Für Besitzer eines DGX-2 oder eines HGX-2 bleibt das Modul ein nützliches Ersatzteil. Für einen Eigenbau ist es vor allem als Experiment interessant, bei dem die Kompatibilität des Adapters sowie die Stromversorgung und Kühlung überprüft werden müssen.
Wer eine V100 mit 32 GB Speicher für lokale neuronale Netze benötigt, fährt wahrscheinlich besser mit einer SXM2 und einem erprobten Adapter oder mit einer fertigen PCIe-Version. Die SXM3 sollte nur gekauft werden, wenn eine kompatible Serverplattform oder ein nachweislich funktionierendes Anschluss-Kit vorhanden ist.
GPU-Vergleich
Tesla V100 SXM3 32 GB mit anderen GPUs vergleichen
Basic
Speicherspezifikationen
Anzeige und Medien
Theoretische Leistung
Verschiedenes
Benchmarks
Im Vergleich zu anderen GPUs
In sozialen Medien teilen
Oder verlinken Sie uns
<a href="https://cputronic.com/index.php/de/gpu/nvidia-tesla-v100-sxm3-32-gb" target="_blank">NVIDIA Tesla V100 SXM3 32 GB</a>