NVIDIA Tesla V100 PCIe 16 GB

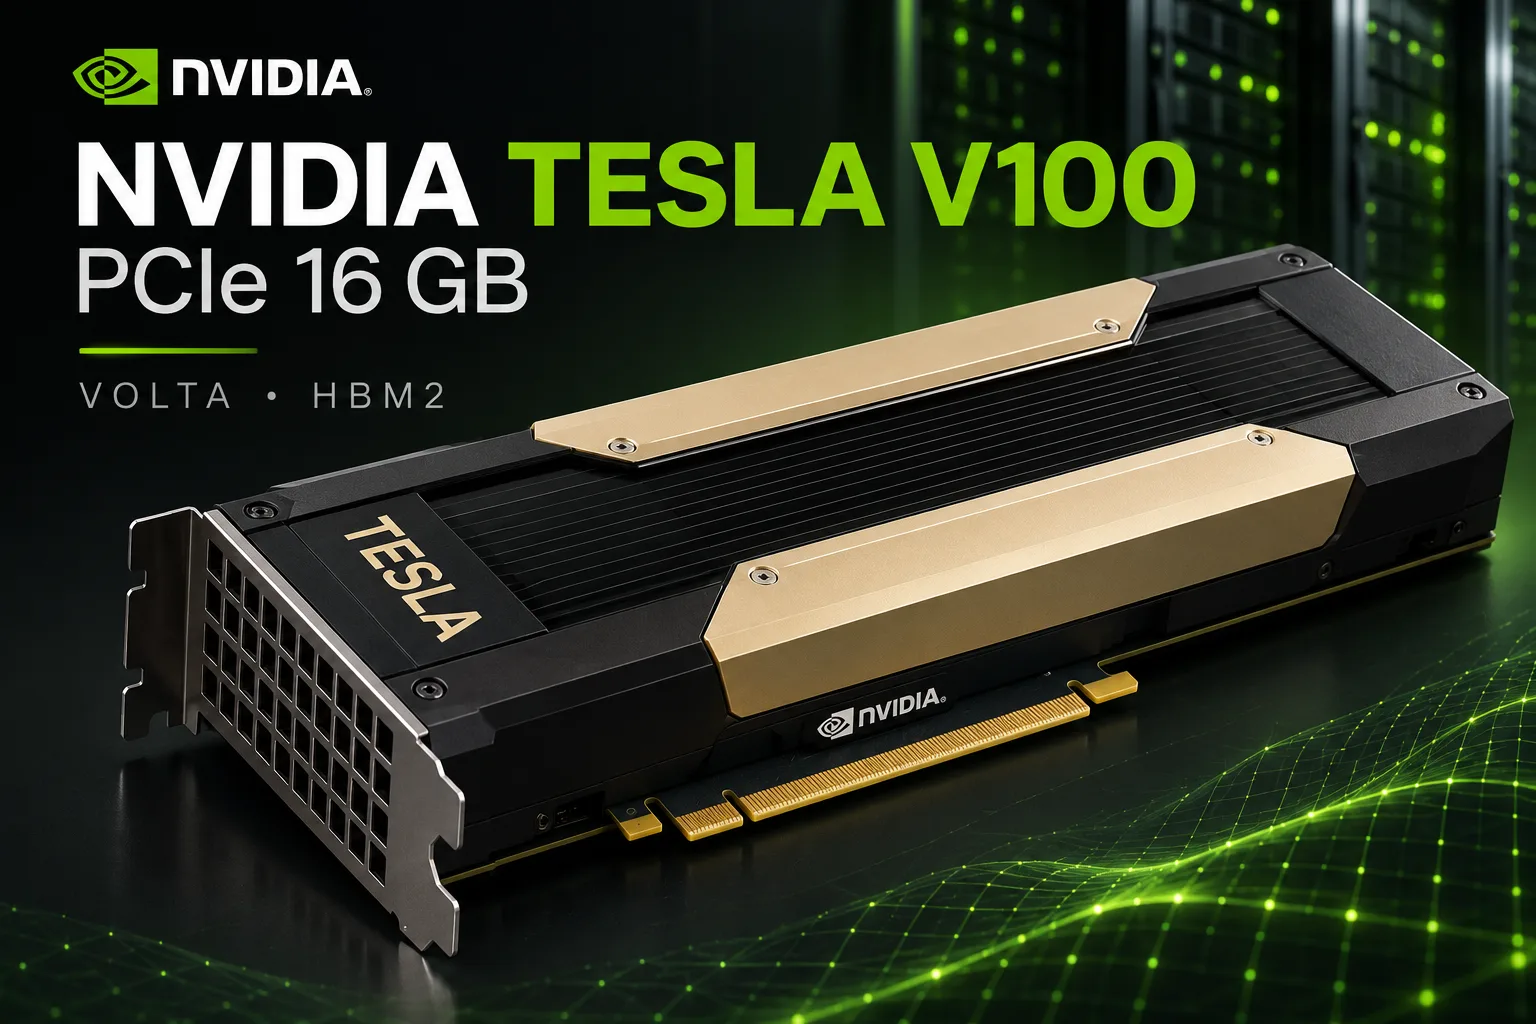
Tesla V100 PCIe 16 GB: 900 GB/s HBM2 für wenig Geld, aber mit eingeschränkter CUDA-Unterstützung
Die Tesla V100 PCIe 16 GB ist ein Serverbeschleuniger aus dem Jahr 2017, der bis heute für lokale neuronale Netze und wissenschaftliche Berechnungen interessant ist. Ihr größter Vorteil ist der HBM2-Speicher mit einer Bandbreite von 900 GB/s - fast so viel wie bei der GeForce RTX 3090. Auf dem Gebrauchtmarkt kostet die Karte einige hundert Dollar, wobei sich hinter den günstigsten Angeboten häufig SXM2-Module und keine vollwertigen PCIe-Karten verbergen.
Für den niedrigen Preis muss man einige Einschränkungen in Kauf nehmen. Die V100 besitzt keine Videoausgänge und keine Hardware-Raytracing-Unterstützung, 16 GB Speicher reichen für große Sprachmodelle nicht aus, und die Unterstützung neuer CUDA-Versionen ist beendet. NVIDIA hat Volta im Treiberzweig R580 belassen, dessen Support bis Mitte 2028 fortgesetzt wird. Für den Betrieb moderner LLMs müssen kompatible Softwareversionen daher immer häufiger selbst zusammengestellt werden.
Einordnung in die Produktpalette
Die Tesla V100 basiert auf dem 815 mm² großen GV100-Chip, der im 12-nm-Prozess TSMC FFN gefertigt wird. Von 84 Streaming-Multiprozessoren sind 80 aktiviert, was 5120 CUDA-Kernen und 640 Tensor-Kernen der ersten Generation entspricht. Vier HBM2-Stacks sind über ein 4096-Bit-Speicherinterface angebunden.
Auf Basis des GV100 brachte NVIDIA mehrere Beschleuniger mit unterschiedlichen Speicherkapazitäten, Taktraten und Schnittstellen auf den Markt.
| Modell | Speicher | Bandbreite | Boost | TDP | Besonderheiten |
|---|---|---|---|---|---|
| Tesla V100 PCIe 16 GB | 16 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | PCIe 3.0 x16, kein NVLink |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 900 GB/s | 1380 MHz | 250 W | Doppelte Speicherkapazität |
| Tesla V100 SXM2 16/32 GB | 16/32 GB HBM2 | 900 GB/s | 1530 MHz | 300 W | SXM2, NVLink-Unterstützung |
| Tesla V100S PCIe 32 GB | 32 GB HBM2 | 1134 GB/s | 1601 MHz | 250 W | Schnellerer HBM2 |
| Titan V | 12 GB HBM2 | 653 GB/s | 1455 MHz | 250 W | Videoausgänge, 3072-Bit-Interface |
| Quadro GV100 | 32 GB HBM2 | 870 GB/s | 1627 MHz | 250 W | Professionelle Grafik |
Die 16-GB-PCIe-Version erreicht bis zu 14 TFLOPS in FP32, 7 TFLOPS in FP64 und 112 TFLOPS bei Tensor-Berechnungen in FP16. Das ist etwas weniger als bei der SXM2-Version, die mit einem höheren Takt und einem höheren Power Limit arbeitet.
Volta war die erste NVIDIA-Architektur mit Tensor-Kernen. Diese unterstützen allerdings nur FP16 und funktionieren nicht mit BF16, TF32 oder FP8. Das Fehlen dieser Formate begrenzt die Effizienz moderner Bibliotheken und Modelle. Auch Hardware-RT-Kerne besitzt der GV100 nicht.
Leistung
Lokale Sprachmodelle
Bei der Token-Generierung wird die Leistung häufig durch die Geschwindigkeit begrenzt, mit der die Gewichte aus dem Videospeicher gelesen werden. Deshalb bleibt die V100 mit ihren 900 GB/s auch gegenüber deutlich neueren GPUs konkurrenzfähig.
Zum Vergleich eignet sich eine von den Entwicklern von llama.cpp veröffentlichte Ergebnistabelle für Llama 2 7B mit der Q4_0-Quantisierung. Gemessen werden die Verarbeitung eines Prompts mit 512 Tokens und die Generierung von 128 Tokens ohne FlashAttention.
| Grafikkarte | Speicher | Prompt-Verarbeitung, Token/s | Generierung, Token/s |
|---|---|---|---|
| Tesla P40 | 24 GB GDDR5 | 1007 | 55 |
| Tesla V100 PCIe 32 GB | 32 GB HBM2 | 3043 | 129 |
| GeForce RTX 3090 | 24 GB GDDR6X | 5175 | 158 |
| GeForce RTX 4090 | 24 GB GDDR6X | 11 993 | 186 |
| GeForce RTX 5090 | 32 GB GDDR7 | 14 073 | 290 |
Die Ergebnisse stammen aus Tests verschiedener Nutzer. Modell und grundlegende Parameter sind identisch, allerdings können sich llama.cpp-Versionen, Treiber und Systemkonfigurationen unterscheiden.
In der Tabelle wurde eine V100 PCIe 32 GB getestet. Die 16-GB-Version besitzt dieselben Taktraten und dieselbe HBM2-Bandbreite, während das Modell selbst weniger als 4 GB belegt. Daher ist eine ähnliche Leistung zu erwarten, auch wenn hier keine direkte Messung der 16-GB-Karte vorliegt.
Bei der Generierung liegt die V100 etwa 18 % hinter der RTX 3090, bei der Prompt-Verarbeitung beträgt der Rückstand 41 %. Bei einem kurzen Dialog ist dieser Unterschied nicht immer entscheidend, bei der Verarbeitung großer Dokumente und eines langen Gesprächsverlaufs wird er jedoch deutlicher.
Die RTX 4090 verarbeitet den Prompt fast viermal schneller als die V100, obwohl ihr Vorsprung bei der Generierung nur 44 % beträgt. Das zeigt, warum die Speicherbandbreite allein die Leistung nicht in allen Aufgaben bestimmt.
Die wichtigste Einschränkung der Tesla V100 PCIe 16 GB ist die Speicherkapazität. Die Karte eignet sich für Modelle mit 7-14 Milliarden Parametern bei 4-Bit-Quantisierung. Modelle mit 27-32 Milliarden Parametern erfordern normalerweise eine teilweise Auslagerung in den Arbeitsspeicher oder eine stärkere Komprimierung. In beiden Fällen muss man Kompromisse bei Geschwindigkeit, Qualität oder Kontextlänge eingehen.
Training und wissenschaftliche Berechnungen
Die V100 wurde in erster Linie für das Training neuronaler Netze und High-Performance-Computing entwickelt. Die FP16-Tensor-Kerne sind weiterhin nützlich, doch neuere Beschleuniger verfügen über effizientere Rechenformate, größere Caches und optimierte Bibliotheken.
Besonders deutlich werden die Einschränkungen beim Training von Modellen, die BF16 verwenden. Die V100 unterstützt dieses Format nicht hardwareseitig, weshalb sich nicht alle aktuellen Konfigurationen von PyTorch und anderen Frameworks ohne Änderungen auf Volta übertragen lassen.
Bei Berechnungen mit doppelter Genauigkeit behält die Karte dagegen einen deutlichen Vorteil gegenüber Gaming-GeForce-Modellen. Ihre Leistung erreicht 7 TFLOPS in FP64 und liegt damit ungefähr 5,4-mal höher als bei der RTX 4090.
Für Molekulardynamik, numerische Modellierung und andere HPC-Aufgaben bleibt die V100 interessant, sofern die eingesetzte Software Volta unterstützt. Eine hohe nominelle FP64-Leistung garantiert jedoch nicht automatisch denselben Vorteil in einem konkreten Programm.
Kann man mit der Tesla V100 spielen?
Die V100 PCIe besitzt keine Videoausgänge. Für die Bildausgabe wird daher eine andere Grafikkarte oder die integrierte Grafik des Prozessors benötigt. Unter Windows muss außerdem ein kompatibler Treiber ausgewählt und der Start von Spielen auf dem Rechenbeschleuniger eingerichtet werden.
Enthusiasten haben die Spieleleistung einer V100 SXM2 16 GB über einen PCIe-Adapter überprüft. In einem System mit Ryzen 7 5700GE erzielte die Karte bei hohen Einstellungen ohne Upscaling und Frame Generation folgende Ergebnisse.
| Spiel | 2560×1080, durchschnittliche FPS | 3440×1440, durchschnittliche FPS |
|---|---|---|
| Cyberpunk 2077 | ~78 | ~56 |
| Hogwarts Legacy | ~55-60 | ~40 |
| Atomic Heart | ~115 | ~75-80 |
| Red Dead Redemption 2 | ~80 | ~65 |
In Cyberpunk 2077 lag die Leistungsaufnahme des Beschleunigers bei etwa 181 W. Die Ergebnisse zeigen, dass Volta moderne Spiele noch bewältigen kann, auch wenn das Fehlen von DLSS und Hardware-Raytracing ihre Möglichkeiten deutlich einschränkt.
Wichtig ist, dass es sich um Tests der SXM2- und nicht der PCIe-Version handelt. Die SXM2 erreicht einen Boost-Takt von bis zu 1530 MHz gegenüber 1380 MHz bei der PCIe-Version, außerdem liegt ihr Power Limit um 50 W höher. Daher kann die PCIe-Version langsamer sein. Ohne separate Messungen lässt sich der Unterschied bei den FPS nicht bestimmen.
Die V100 speziell für Spiele zu kaufen, lohnt sich nicht. Eine gewöhnliche GeForce ist einfacher zu installieren, unterstützt moderne Grafiktechnologien und benötigt keine zusätzliche Grafikkarte für die Bildausgabe.
Installation in einem gewöhnlichen Computer
Im Gegensatz zur SXM2 wird die Tesla V100 PCIe direkt in einen standardmäßigen PCIe-x16-Steckplatz eingesetzt. Die Installation in einem Heim-PC erfordert dennoch einige Vorbereitungen.
Stromversorgung. Die Referenzversion der V100 PCIe besitzt einen 8-poligen CPU-EPS12V-Anschluss. Dieser unterscheidet sich vom gewöhnlichen 8-poligen PCIe-Anschluss. NVIDIA erlaubt den Anschluss eines passenden EPS12V-Kabels oder die Verwendung eines speziellen Adapters mit PCIe-Steckern.
Vor dem ersten Einschalten müssen die Pinbelegung und die zulässige Belastung der Kabel überprüft werden. Ein ungeeignetes Kabel darf nicht allein deshalb angeschlossen werden, weil der Stecker ähnlich aussieht.
Kühlung. Die Karte ist mit einem passiven Kühlkörper ausgestattet, der für einen starken Luftstrom im Server ausgelegt ist. In einem gewöhnlichen Gehäuse wird ein separater Lüfter mit gerichteter Luftströmung benötigt.
Ohne ausreichende Kühlung kann der Beschleuniger die Taktraten senken oder überhitzen. Überprüft werden sollten nicht nur die Kerntemperatur, sondern auch die Stabilität unter längerer Belastung.
Leistungsaufnahme. Das nominelle Power Limit beträgt 250 W. Über nvidia-smi lässt sich die zulässige Leistungsaufnahme beispielsweise auf 180 W reduzieren. Das senkt die Wärmeentwicklung und die Anforderungen an die Kühlung, der Einfluss auf die Leistung hängt jedoch von der jeweiligen Aufgabe ab.
Softwareunterstützung: die wichtigste Einschränkung
NVIDIA hat bestätigt, dass R580 der letzte Treiberzweig mit Unterstützung für Maxwell, Pascal und Volta sein wird. Bei den Serverbeschleunigern gehört er zu einer Reihe mit langfristigem Support, deren Pflege im Juni 2028 endet.
CUDA 13 erlaubt nicht mehr, Anwendungen für die Volta-Architektur mit der Compute Capability sm_70 zu kompilieren. Die letzte kompatible Reihe des CUDA Toolkit ist 12.x, einschließlich Version 12.9.
Die V100 hat jedoch nach der Veröffentlichung von CUDA 13 nicht aufgehört zu funktionieren. Programme, die mit Unterstützung für Volta unter früheren CUDA-Versionen erstellt wurden, laufen mit kompatiblen Treibern weiterhin.
Das Problem betrifft neue Versionen von Programmen und Bibliotheken:
- llama.cpp. Der Quellcode erlaubt die Erstellung kompatibler Versionen für sm_70, doch neue Optimierungen unterstützen Volta möglicherweise nicht.
- PyTorch. Für die V100 müssen Builds mit Unterstützung für CUDA 12.x und die entsprechenden Compute-Architekturen ausgewählt werden.
- LM Studio und Ollama. Die Kompatibilität hängt von der Version der Anwendung und der mitgelieferten CUDA-Runtime ab. Einige Funktionen können ältere Builds erfordern.
- FlashAttention 2. Die gewöhnliche CUDA-Implementierung ist auf neuere Architekturen ausgelegt, weshalb auf der V100 alternative Mechanismen zur Verarbeitung der Attention verwendet werden müssen.
Für Experimente zu Hause ist das akzeptabel: Eine kompatible Umgebung lässt sich beibehalten und selektiv aktualisieren. Für einen Produktivserver sind die Einschränkungen gravierender, da neuere Versionen von Frameworks die Unterstützung für Volta schrittweise einstellen.
Preise auf dem Gebrauchtmarkt
Der Preis der V100 unterscheidet sich je nach Ausführung deutlich. Günstige SXM2-Module erscheinen häufig in den allgemeinen Suchergebnissen für die Tesla V100, obwohl sie sich ohne Adapter nicht in einem PC installieren lassen.
Laut einer Übersicht der eBay-Angebote vom 28. Oktober 2026 stellt sich die Situation folgendermaßen dar:
| Grafikkarte | Unteres Ende der Angebote | Median der Angebote |
|---|---|---|
| Tesla V100 PCIe 16 GB, passive Ausführung | $329 | $422 |
| Tesla V100 SXM2 16 GB | $191 | $300 |
| Tesla V100 SXM2 32 GB | $842 | $990 |
| Tesla V100 PCIe 32 GB, passive Ausführung | $860 | $960 |
| GeForce RTX 3090 24 GB | $1651 | $1970 |
Die Preise beziehen sich auf aktive Angebote und nicht auf abgeschlossene Verkäufe. Einzelne V100 PCIe 16 GB wurden für etwa $240-275 verkauft, solche Angebote können jedoch nicht als garantiert verfügbar gelten.
Für die 16-GB-PCIe-Version ist es sinnvoll, sich an $300-350 für eine funktionierende Karte mit Möglichkeit zur Prüfung zu orientieren. Bei einem Preis von etwa $400 wird der Kauf weniger attraktiv, insbesondere wenn zusätzlich Kühlung und ein Stromkabel benötigt werden.
Die Kosten für ein fertig aufgebautes Heimsystem können deutlich über dem Preis des Beschleunigers selbst liegen. Deshalb sollten die Kosten der V100 mit Alternativen erst nach Berücksichtigung aller Komponenten verglichen werden.
Konkurrenten und Alternativen
Tesla V100 SXM2 16 GB. Das Modul selbst ist günstiger als die PCIe-Version, benötigt jedoch einen Adapter, eine Stromversorgung und eine separate Kühlung. Die Gesamtkosten können dadurch denen einer fertigen PCIe-Karte entsprechen. Für eine einzelne GPU rechtfertigt der Vorteil der SXM2 normalerweise den komplizierten Aufbau nicht. Anders sieht es bei Multi-Modul-Platinen mit NVLink aus.
Tesla V100 PCIe 32 GB. Sie besitzt dieselbe Rechenarchitektur und Speicherbandbreite, aber doppelt so viel HBM2. Dadurch eignet sie sich deutlich besser für Sprachmodelle mit 27-32 Milliarden Parametern. Bei einem Preis von $800-1000 ist der wirtschaftliche Vorteil der alten Architektur jedoch nicht mehr so offensichtlich.
GeForce RTX 3090 24 GB. Sie ist bei der Prompt-Verarbeitung schneller, unterstützt BF16, moderne CUDA-Optimierungen und Hardware-Raytracing. Ihre 24 GB erlauben die Arbeit mit größeren Modellen als bei der V100 16 GB. Auf dem Gebrauchtmarkt finden sich Angebote ab etwa $1200, wobei der Großteil der Angebote teurer ist. Sie ist die vielseitigere Karte, allerdings ist der Aufpreis erheblich.
GeForce RTX 5060 Ti 16 GB. Sie bietet eine neue Architektur, Unterstützung für aktuelle Bibliotheken, Videoausgänge, DLSS 4 und eine Herstellergarantie. Ihre Speicherbandbreite ist mit 448 GB/s niedriger als bei der V100 mit 900 GB/s. Aus diesem Unterschied lässt sich die LLM-Leistung jedoch nicht direkt ableiten: Moderne Rechenkerne und Softwareoptimierungen können den Nachteil bei der Bandbreite ausgleichen. Für Spiele und alltägliche Aufgaben ist die RTX 5060 Ti die bessere Wahl.
AMD Instinct MI50 32 GB. Sie ist eine Alternative mit doppelt so viel HBM2, einer Bandbreite von etwa 1 TB/s und hoher FP64-Leistung. Die Preise einzelner Angebote beginnen bei etwa $650. Die wichtigste Einschränkung sind die zunehmend veraltende ROCm-Unterstützung und Schwierigkeiten mit moderner Compute-Software. Für Programme, die auf CUDA ausgelegt sind, ist die V100 normalerweise einfacher zu verwenden.
Tesla P40 24 GB. Sie ist eine ältere Karte mit GDDR5 und 24 GB Speicher. Im llama.cpp-Test generiert sie etwa 55 Token/s gegenüber 129 Token/s bei der V100. Die zusätzlichen 8 GB ermöglichen jedoch den Betrieb von Modellen, die nicht in die 16 GB der V100 passen. Deshalb bleibt die P40 eine Alternative, wenn die Speicherkapazität wichtiger ist als die Geschwindigkeit.
Lohnt sich der Kauf einer Tesla V100 PCIe 16 GB?
Die Tesla V100 PCIe 16 GB ist weiterhin attraktiv für lokale neuronale Netze, wissenschaftliche Berechnungen und CUDA-Experimente. Für einige hundert Dollar erhält man 900 GB/s Speicherbandbreite, 640 Tensor-Kerne und 7 TFLOPS in FP64.
Allerdings schränkt die Kapazität von 16 GB die Auswahl an Sprachmodellen ein, während die Softwareunterstützung für Volta schrittweise zurückgeht. Die Karte benötigt eine gerichtete Kühlung, eine passende Stromversorgung sowie eine sorgfältige Auswahl von Treiber- und Bibliotheksversionen.
Bei einem Preis von bis zu $300-350 kann die V100 PCIe 16 GB als guter Kauf für einen privaten Rechenaufbau gelten. Kostet die Karte $400 oder mehr, sollte man sie unter Berücksichtigung der Installationskosten mit der SXM2 16 GB, der P40 24 GB und moderneren Beschleunigern vergleichen.
Für Modelle mit bis zu 14 Milliarden Parametern reichen die Möglichkeiten der V100 normalerweise aus. Wenn das Ziel darin besteht, Modelle mit 27-32 Milliarden Parametern lokal ohne Auslagerung in den Arbeitsspeicher zu betreiben, sollte man gleich eine Grafikkarte mit 24-32 GB Speicher in Betracht ziehen.
Die V100 sollte man wegen konkreter Rechenaufgaben kaufen und nicht als universelle Grafikkarte. Ihre Leistung reicht noch für viele Experimente aus, doch mit einer vollständigen Unterstützung neuer Software in den kommenden Jahren kann man nicht mehr rechnen.
GPU-Vergleich
Tesla V100 PCIe 16 GB mit anderen GPUs vergleichen
Basic
Speicherspezifikationen
Anzeige und Medien
Theoretische Leistung
Verschiedenes
Benchmarks
Im Vergleich zu anderen GPUs
Verwandte GPU-Vergleiche


In sozialen Medien teilen
Oder verlinken Sie uns
<a href="https://cputronic.com/index.php/de/gpu/nvidia-tesla-v100-pcie-16-gb" target="_blank">NVIDIA Tesla V100 PCIe 16 GB</a>